
邁入30天賽程的中界點,系統性整合 Day 6 至 Day 14 的探索性資料分析(EDA)成果,進行領域知識導向的特徵工程(Feature Engineering),建構出量化個人眼部亞健康負擔的「綜合用眼疲勞指數(Composite Eye Strain Index, CESI)」,並檢驗其與原始風險分級的對齊程度。
一、實作前情境:為什麼我們需要特徵工程?
回顧前半程的探索,我們發現了幾項關鍵的資料特性:
1.單一數值特徵線性關聯極弱:每日螢幕時數、休息次數與單一症狀的皮爾森相關係數僅在 0.00~0.01 之間徘徊。
2.多因子交互作用明確:在「睡眠不足(≤5h)」的條件下,高工時螢幕暴露會使眼痛分數急劇放大至 5.58 分。
3.客觀急性症狀具有強烈警示性:出現「視力模糊(Blurred_Vision)」的受試者,高疲勞風險比例大增近 9 個百分點。
說明:單一欄位不足以完整代表個體的眼部健康狀態,各因子具有彼此加乘與緩衝的複合效果。因此,我們需要透過特徵工程將「外在暴露危害」、「內在生理修復能力」與「自覺急性症狀」融合成單一可量化評估的數值指標——CESI(Composite Eye Strain Index)。
二、指數設計邏輯與數學架構
我們將 CESI 指數設計為介於 0 到 100 分 的綜合評分,分數越高代表用眼負擔越沉重。指標權重劃分為三大維度:
1.自覺症狀維度(權重 45%):
三、撰寫特徵工程與驗證視覺化腳本
在Colab中新增儲存格,使用乾淨語法建立新特徵,並透過Seaborn驗證新指數能否有效區分原始的 Digital_Eye_Strain_Risk(Low / Medium / High):
# ==========================================
# Day 15:綜合用眼疲勞指數 (CESI) 特徵工程實作
# ==========================================

import warnings
warnings.filterwarnings('ignore') # 保持日誌輸出整潔

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 2. 特徵工程計算
# (1) 急性症狀二元轉換
df['Blurred_Vision_Score'] = df['Blurred_Vision'].map({'Yes': 10.0, 'No': 0.0})

# (2) 計算暴露修復比率:螢幕時數 / 睡眠時數
# 考量每小時休息次數 (0~3 次) 帶來的微幅緩衝修正
break_discount = 1.0 - (df['Break_Frequency_Per_Hour'] * 0.05) # 每次休息折抵 5% 暴露負擔
df['Exposure_Burden'] = (df['Daily_Screen_Hours'] / df['Sleep_Hours']) * break_discount

# 將暴露負擔標準化至 0~10 分
min_burden = df['Exposure_Burden'].min()
max_burden = df['Exposure_Burden'].max()
df['Exposure_Score'] = ((df['Exposure_Burden'] - min_burden) / (max_burden - min_burden)) * 10.0

# (3) 依據領域權重綜合成 CESI 指數 (滿分 100 分)
df['CESI_Score'] = (
    df['Eye_Dryness_Level'] * 2.0 +        # 20%
    df['Eye_Pain_Level'] * 2.5 +           # 25%
    df['Blurred_Vision_Score'] * 1.5 +     # 15%
    (df['Headache_Frequency_Per_Week'] / 7.0 * 10.0) * 0.5 + # 5%
    df['Exposure_Score'] * 3.5             # 35%
)

# 3. 建立 1x2 驗證視覺化圖表
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="whitegrid")

risk_order = ['Low', 'Medium', 'High']
risk_palette = {'Low': '#5dade2', 'Medium': '#f4d03f', 'High': '#e74c3c'}

# --- 圖 1:各風險等級的 CESI 指數箱形圖 ---
sns.boxplot(
    data=df,
    x='Digital_Eye_Strain_Risk',
    y='CESI_Score',
    order=risk_order,
    palette=risk_palette,
    width=0.45,
    boxprops=dict(alpha=0.85),
    ax=axes[0]
)
axes[0].set_title('不同風險等級之 CESI 綜合指數分佈', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[0].set_xlabel('原始用眼疲勞風險等級 (Digital_Eye_Strain_Risk)', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('CESI 綜合疲勞指數 (0-100 分)', fontproperties=my_font, fontsize=12)
axes[0].set_xticks([0, 1, 2])
axes[0].set_xticklabels(['低度風險 (Low)', '中度風險 (Medium)', '高度風險 (High)'], fontproperties=my_font, fontsize=11)

# --- 圖 2:各風險等級的 CESI 指數核密度曲線 (KDE) ---
sns.kdeplot(
    data=df,
    x='CESI_Score',
    hue='Digital_Eye_Strain_Risk',
    hue_order=risk_order,
    palette=risk_palette,
    fill=True,
    common_norm=False,
    alpha=0.3,
    linewidth=2,
    ax=axes[1]
)
axes[1].set_title('各風險等級 CESI 指數機率密度曲線', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[1].set_xlabel('CESI 綜合疲勞指數 (0-100 分)', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('核密度估計 (Density)', fontproperties=my_font, fontsize=12)

# 圖例字型設定
legend_1 = axes[1].get_legend()
if legend_1:
    legend_1.set_title('疲勞風險等級')
    plt.setp(legend_1.get_texts(), fontproperties=my_font)
    plt.setp(legend_1.get_title(), fontproperties=my_font)

plt.tight_layout()
plt.show()

# 4. 輸出各風險組在 CESI 指數上的統計摘要表
print("=== CESI 綜合疲勞指數統計驗證表 ===")
cesi_stats = df.groupby('Digital_Eye_Strain_Risk')['CESI_Score'].agg(
    樣本數='count',
    平均值='mean',
    中位數='median',
    標準差='std',
    最小值='min',
    最大值='max'
).loc[risk_order].reset_index()

display(cesi_stats.round(2))
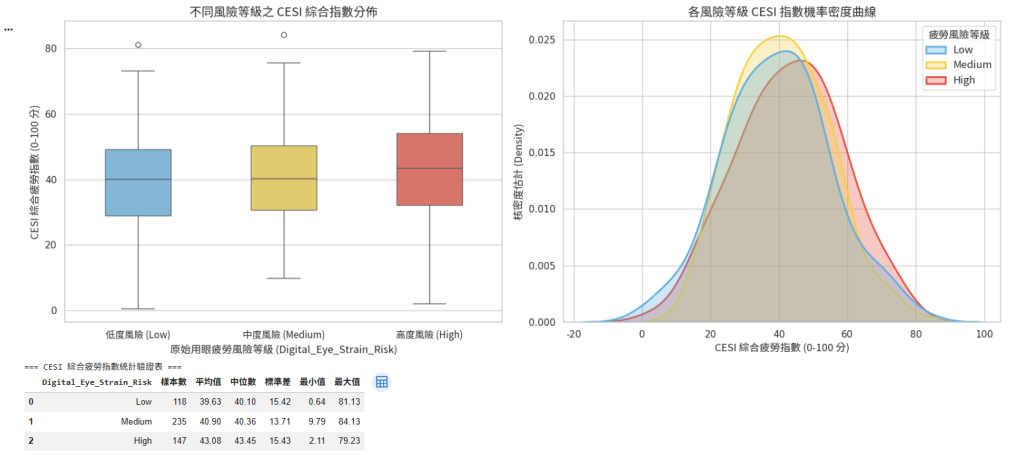
四、圖表解讀與客觀觀察切入點執行程式碼後,重點檢驗新特徵的鑑別成效:
1.階梯分離度:


 iThome鐵人賽
 看影片追技術