
(這節是給菜鳥的,老鳥可以直接跳到第 2 節了 XDD)
從系統設計的角度看,本質上跟 AI 聊天的過程,依然是我們再熟悉不過的 Client-Server 的模式。(很像廢話,但有時候魔法用著用著,確實會忘記他跟你所認知的或是你正在開發的架構,有很多東西是一樣的,沒那麼可怕~)
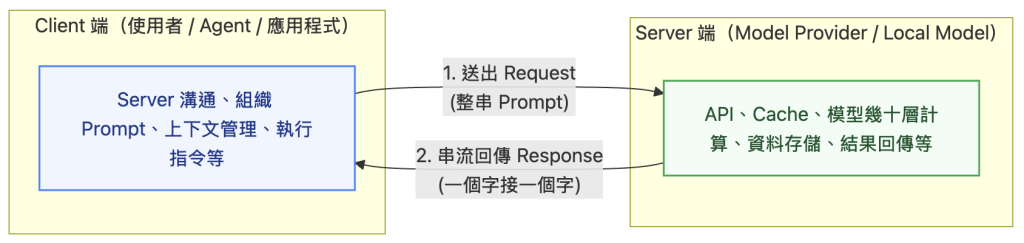
這張圖當然只是個示意,實際背後系統架構的複雜度,肯定遠遠不止這些,畢竟功能也遠遠不止這些。
如果拆開來看兩邊各自要做的事情:
Client 端(使用者 / 應用程式 / Agent):
在 Client 這端主要負責就是管理對話的上下文(Context)、把參考資料和 System Prompt 組織成符合 API 格式的文字,透過發送 Request 與伺服器溝通;如果是具備工具調用(Tool Calling)能力的 Agent,甚至還得在本地端負責執行指令或讀寫檔案,把結果再整理然後再發一次 Request。透過這樣反覆執行,形成了我們與 AI 聊天的整個過程。但無論功能多複雜,退回到底層最基本的動作,其實就是:把當前要講的話打包成一段 Prompt,送出 Request。
Server 端(Model Provider / Local Model):
伺服器也同樣是一整套龐大的分散式系統。除了我們這幾天聊的幾十層 Transformer 模型計算,它還得處理 API 路由、排隊調度、資料儲存、以及我們後面會聊到的快取機制。而它的核心任務也很明確:接收這串 Prompt,在 GPU 裡跑完模型計算,再把生成的文字一個字一個字串流吐回給 Client。
簡單區分了兩者的分工與邊界,我們繼續來看一下工程師是怎麼設計與運用模型,實作出這種可以跟你對話,還能記住你說過的話的聊天系統。
(沒錯!這是系統設計!不是 AI!抱歉有點敏感 XDD 我只是想表達很多人時常在讚嘆 AI 的同時貶低軟體工程師,但其實有很多讚嘆 AI 的點,不見得都是 AI 的功勞,而是軟體工程師與產品們的設計跟決策)
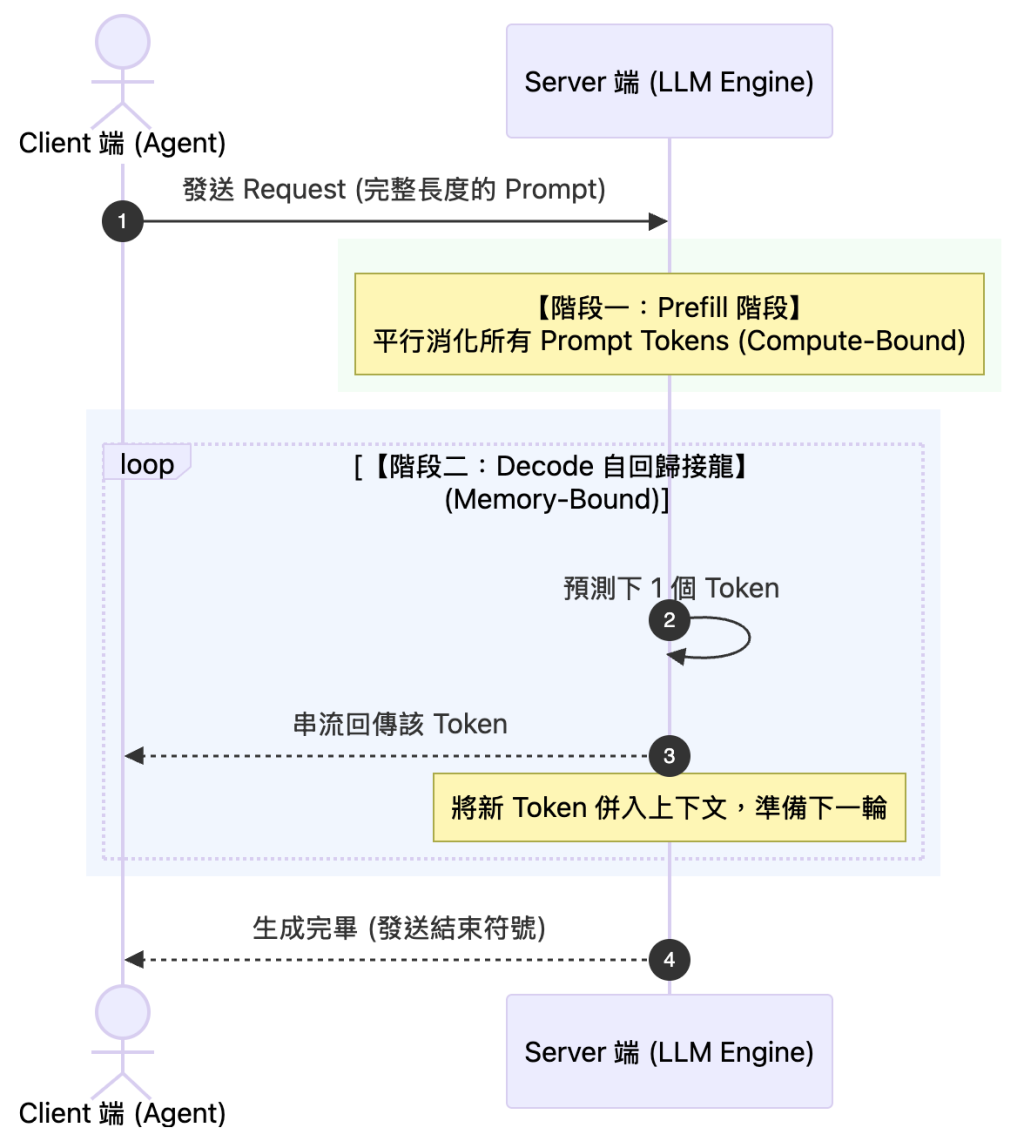
當 Server 收到 Client 送來的長篇 Prompt 時,不是像我們前幾天那樣單純把一大段 Prompt 丟到模型,吐出結果。這裡分成了兩個不同的階段:Prefill 與 Decode:
小故事:曾經在 ChatGPT 剛出來的時候,我跟同事曾討論過「為什麼 AI 都記得住我們講過的內容?」這問題放到現在可能沒什麼,大家都知道一次會送一大包,但畢竟當時剛出來嘛。那時的我很天真地覺得「每次發過去都會 fine-tune 模型參數,每個 session 都是個別 tune 過的 model,所以才都記得住我們的聊天記錄」。現在想想這想法有夠荒唐哈 XDD
首先,我們要先理解一件事,當我們在一個 session 中跟 AI 對話時,每一次的 Request 不是只有把我們這輪的對話內容發給模型,而是整個 session 裡面所有的歷史紀錄(當然有 Compact 後就是從 Checkpoint 到最新的輸入之間所有的內容)。對,模型的 Input Token 就是這麽大包!絕對不是「我吃蘋果」這種很短的句子~
幾天前的我們,可能還比較難想像這個階段的目的。但 Day07 提到了現在很多在使用的 LLM,採取的是「Decoder-Only」的策略,所以我們已經沒有 Encoder 了,理解上下文的工作也全部都在 Decoder 身上。Client 送來的 Prompt 通常是一大段文字(幾百字、幾千字,甚至包含整份程式碼以及厚厚的 System Prompt),因此,這個階段的目的是要先讓模型 「理解傳過來的 Prompt 內容到底在做什麼」。
所以在這個階段,模型做的事情就是 「一次性消化整批輸入內容然後理解上下文關係」:
工程特性:算力密集(Compute-Bound)
這時候 GPU 裡的幾萬個運算核心全速工作,把算力用在進行大規模的矩陣乘法。
讀完並理解整段 Prompt 之後,模型可以開始透過計算好的上下文資訊(KV),不斷玩「文字接龍」,就像我們平常在介面上看到的「打字機效果」。
這個階段,完全回歸到 自回歸模型(Autoregressive) 的本質(還記得它嗎?在 Day 07 XDD)
「每一次模型輸入然後前向傳播,就只負責猜出『下 1 個 Token』!然後把生成的 Token 再放到 Input 再生成下一個字」
工程特性:記憶體頻寬密集(Memory-Bound)
在這個階段,模型跑完整個神經網路,僅僅只是為了生出 1 個 Token。但為了算這 1 個 Token,GPU 卻必須把整個幾十 GB 的模型權重,從 GPU 顯存完整搬進運算核心跑一輪!這時候算力根本用不滿,真正的效能瓶頸全卡在 GPU 顯存搬移的頻寬上。
把剛才聊到的 Client-Server 與兩大階段串連起來,整個現代 LLM 推論的運作過程類似這樣:
在使用 AI Agent 時,會有兩個不同指標來表示體感上的延遲:
每一次的 Decode(生出一個 Token) 或是 每一輪對話(Request),如果都要 Prefill 計算的話,整台伺服器就等於一直在把上下文重新理解一次,顯然是一筆非常大的計算開銷。還記得 昨天 的問題嗎?「頭髮、眼睛、鼻子的邊界(K)與畫面(V)在「嘴巴」比對時,是不是可以重複利用呢?」確實可以!這又是一次漂亮的設計,將整體運算的時間及成本,以及你的 Token 花費大大降低的設計,KV Cache。
明天就來聊聊這東西是啥吧!


 iThome鐵人賽
 看影片追技術