
上一篇我們知道,DNN 會先透過 Flatten 將圖片攤平成一串數字,而 CNN 則可以保留圖片原本的空間結構,從局部區域學習影像特徵
但這裡就出現了一個新的問題:CNN 到底是怎麼從圖片中找到這些特徵的?
我們常說 CNN 可以找到圖片中的「邊緣」、「紋理」或「形狀」,但電腦並不是真的用眼睛去看,CNN 最核心的秘密,其實就是今天要介紹的:Convolution(卷積)
前面我們知道,圖片對電腦來說就是一個由數字組成的矩陣
假設今天有一張非常小的灰階圖片:
1   1   1   0   0
1   1   1   0   0
1   1   1   0   0
0   0   0   1   1
0   0   0   1   1
CNN 不會一次把整張圖片全部攤平,而是會拿一個比較小的矩陣,在圖片上逐步移動。這個小矩陣就叫做Kernel(卷積核),也常稱為 Filter(濾波器)
假設我們現在有一個 3 × 3 的 Kernel:
1   0  -1
1   0  -1
1   0  -1
而圖片的其中一個 3 × 3 區域是:
1   1   1
1   1   1
1   1   1
Convolution 會把兩個矩陣對應位置的數值相乘,再全部加起來
(1×1) + (1×0) + (1×-1)
+
(1×1) + (1×0) + (1×-1)
+
(1×1) + (1×0) + (1×-1)
= 0
接著 Kernel 不會停在這裡,而是繼續往圖片的下一個位置移動,再進行相同的計算
Kernel 會先看其中一個區域,計算完成之後,再往旁邊移,就像拿著一個小視窗,在圖片上一格一格地掃描,這也是 CNN 可以觀察局部區域的重要原因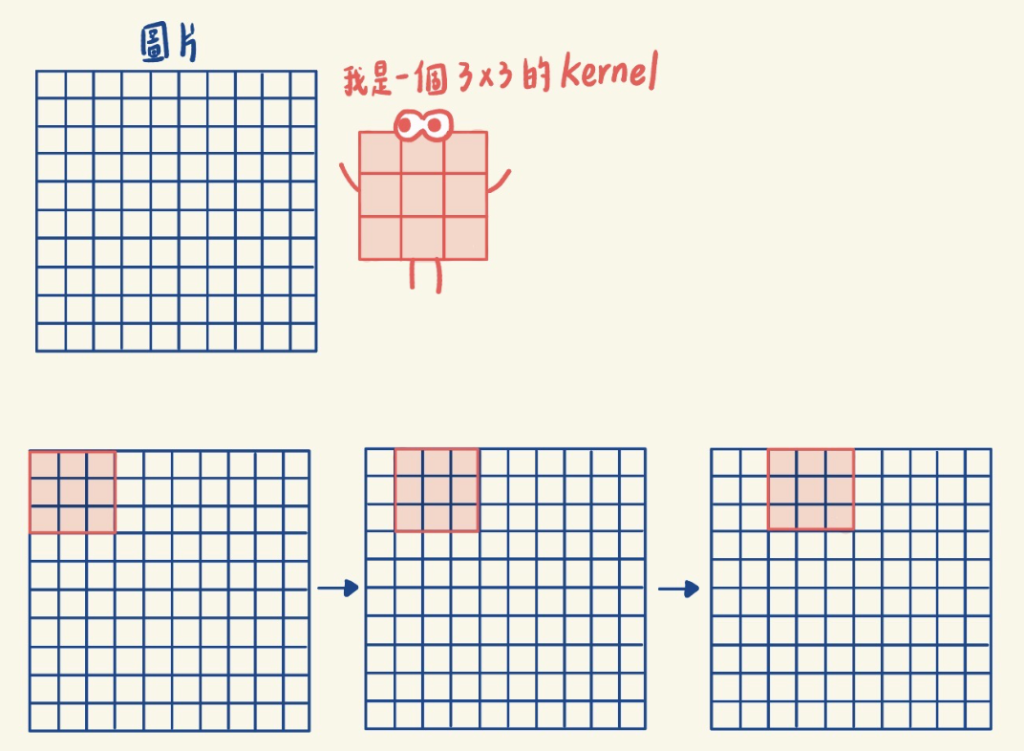
說到這邊,你一定很好奇 Kernel 裡面的 1、0、-1 是我們自己設定的嗎?如果是傳統影像處理,我們確實可以人工設計 Kernel,例如用特定 Kernel 偵測邊緣,但在 CNN 中,Kernel 裡面的數值通常不是我們一個一個手動設定
它們是模型在訓練過程中學習出來的參數,一開始 Kernel 的 Weight 可以從初始化值開始,接著模型根據預測結果與正確 Label 之間的誤差,不斷更新這些數值,所以 CNN 真正學習的其中一部分,其實就是在判斷哪些 Kernel 數值可以找出對分類有幫助的特徵
Kernel 在圖片上移動時,還有一個重要的設定就是Stride(步幅),Stride 代表 Kernel 每次移動多少格
例如:Stride = 1
就是每次移動一格,Stride 越大,Kernel 掃描的位置通常越少,最後產生的 Feature Map 空間尺寸也會比較小
Kernel 把整張圖片掃過一次之後,每一個位置都會得到一個新的數值,把這些數值重新排列起來,就會形成 Feature Map(特徵圖)
Feature Map 可以看成是圖片經過某個 Filter 處理後產生的新表示,其中會反映這個 Filter 對不同位置的反應程度
例如某個 Kernel 經過訓練後,可能會對某些邊緣特徵產生較強的反應,那麼這些位置在 Feature Map 中就會出現不同的數值
以我們的資料為例,一張皮膚病灶圖片裡可能包含很多不同的資訊,例如:邊緣、紋理、顏色變化、局部形狀
所以 CNN 通常不會只有一個 Filter,而是會同時學習很多個不同的 Filter
每個 Filter 都有自己學習到的 Weight,因此可能會對不同的影像模式產生不同反應,這些 Feature Map 再繼續傳到下一層,讓後面的 CNN Layer 組合出更複雜的特徵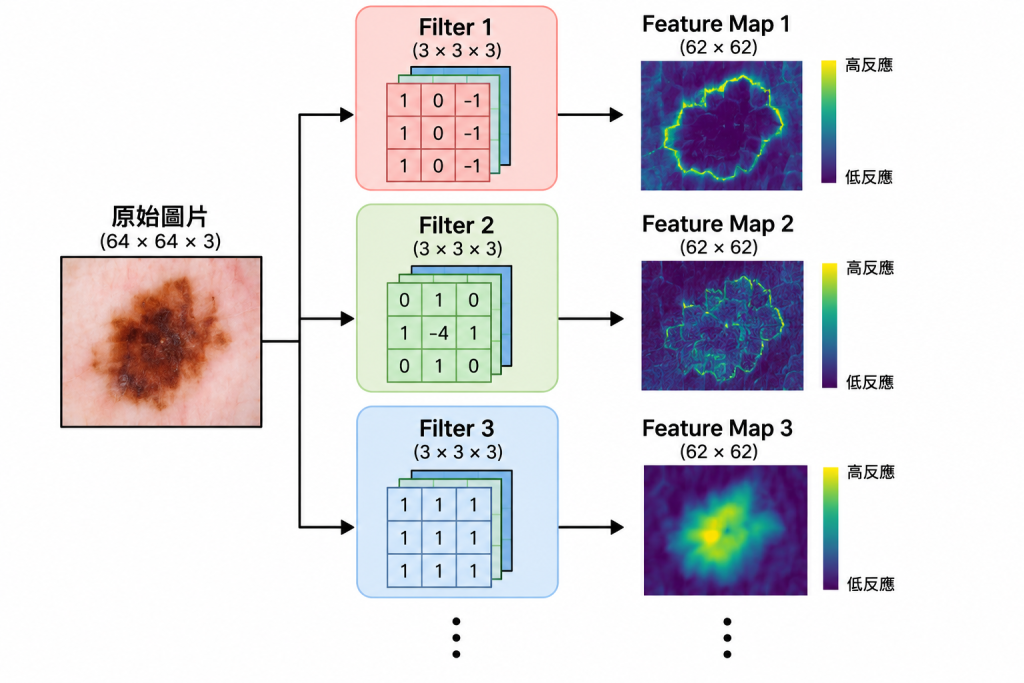
tf.keras.layers.Conv2D(filters=32, kernel_size=(3, 3), strides=(1, 1), activation="relu")
看完前面的,再來看看程式碼,是不是容易很多呢filters=32 代表使用 32 個 Filter,會產生 32 個輸出 Feature Mapkernel_size=(3, 3)代表每個 Kernel 的空間大小是 3 × 3strides=(1, 1)每次水平、垂直移動 1 格activation="relu" 使用 ReLU Activation Function


 iThome鐵人賽
 看影片追技術