
前幾天我們把 CNN 拆成不同的部分來認識,在 Day12 我們知道 CNN 和 Dense Neural Network 的差別,Day13 認識了 Convolution、Kernel 與 Feature Map,Day14 則介紹了 Pooling 如何縮小 Feature Map
今天終於要把前面學到的東西全部組合起來,建立我們第一個完整的 CNN 圖片分類模型!
這次的目標不是馬上做出最好的模型,而是先建立一個簡單的 Baseline Model(基準模型)
之後我們調整模型架構、Batch Size、Learning Rate 或其他方法時,就可以和今天的結果比較,看看模型到底有沒有真的進步
Day11 我們建立的模型大概是: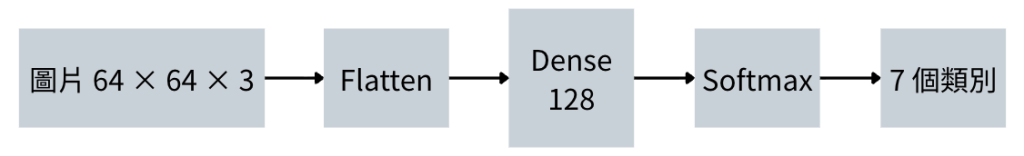
最大的問題就是圖片一進入模型,很快就被 Flatten 成一串數字
今天我們改成 CNN: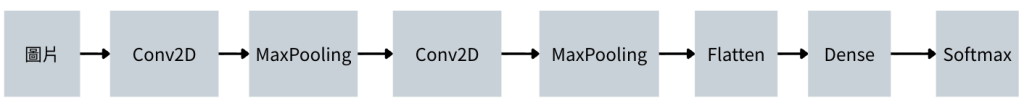
最大的差別就是:在 Flatten 之前,先透過 Convolution 和 Pooling 進行 Feature Extraction
我們繼續使用前面處理好的:
64 × 64 × 3,接著建立模型import tensorflow as tf
model = tf.keras.Sequential([
# 輸入圖片:64 × 64,3 代表 RGB 三個 Channel
tf.keras.layers.Input(shape=(64, 64, 3)),
# 第一層 Convolution
# 使用 32 個 3 × 3 Filter 學習圖片的局部特徵
tf.keras.layers.Conv2D(32, kernel_size=(3, 3), activation="relu", padding="same"),
# 將 Feature Map 的空間尺寸縮小
tf.keras.layers.MaxPooling2D(pool_size=(2, 2)),
# 第二層 Convolution
# 使用 64 個 Filter 學習更多特徵
tf.keras.layers.Conv2D(64, kernel_size=(3, 3), activation="relu", padding="same"),
# 再次縮小 Feature Map
tf.keras.layers.MaxPooling2D(pool_size=(2, 2)),
# 將 Feature Map 攤平成一維
tf.keras.layers.Flatten(),
# Dense Layer
tf.keras.layers.Dense(128, activation="relu"),
# HAM10000 有 7 個類別
tf.keras.layers.Dense(7, activation="softmax")
])
這裡我加入了 padding="same",它可以讓 Convolution 前後的空間尺寸(Height、Width)維持相同,所以第一個 Conv2D 從 64 × 64 × 3 到 64 × 64 × 32,圖片的寬和高仍然是 64 × 64,但最後變成 32,是因為我們使用了 filters=32,也就是產生 32 個輸出 Feature Map
接著
tf.keras.layers.MaxPooling2D(pool_size=(2, 2))
就會把 64 × 64 × 32 縮小成 32 × 32 × 32 ,接著第二個 Conv2D 使用 filters=64,因此變成 32 × 32 × 64,再次經過 MaxPooling 變成 16 × 16 × 64,這邊可以發現一個很有趣的變化:
空間尺寸逐漸縮小,但是 Feature Map 的數量增加,模型就是透過這些 Layer,逐步建立更豐富的特徵表示
前面一直說 Dense Model 的問題是 Flatten,那為什麼 CNN 最後還是用了:
tf.keras.layers.Flatten()
差別在於 Flatten 的時間點不同
Day11 是:原始圖片直接 Flatten⮕Dense
今天則是經過了幾個Conv2D與Pooling再Flatten
CNN 並不是完全不能使用 Flatten,而是先透過 Convolution 和 Pooling 進行 Feature Extraction,最後再把提取出的 Feature Map 攤平成一維,交給 Dense Layer 進行分類
建立完模型後,可以使用model.summary()實際看到每一層到底有多少需要學習的參數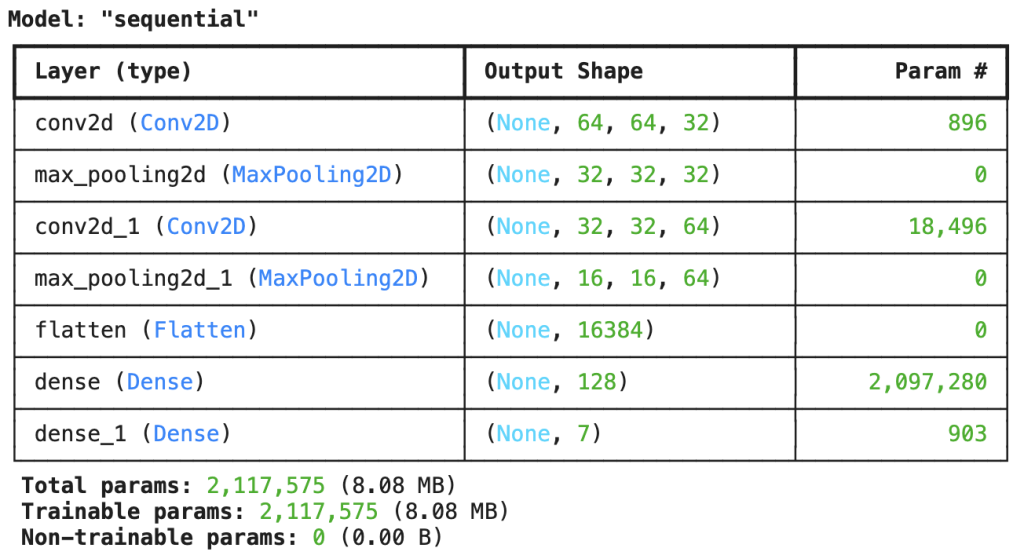
模型建立完成之後,和 Day11 一樣需要 Compile,這次我們先維持和 Dense Model 類似的設定,因為今天的目的,是先建立 CNN Baseline,而不是一次改很多東西,如果一次同時改模型、Optimizer、Learning Rate、Batch Size 等設定,最後反而很難知道到底是哪一個改變造成結果不同
從結果可以看到,隨著 Epoch 增加,Training Accuracy 持續上升,從一開始約 67.5%,最後提高到約 82.7%
但是 Validation Accuracy 並沒有跟著持續上升,Validation Accuracy 在前幾個 Epoch 上升後,大約在第 5 個 Epoch 達到 72.5% 左右,之後反而開始出現下降與波動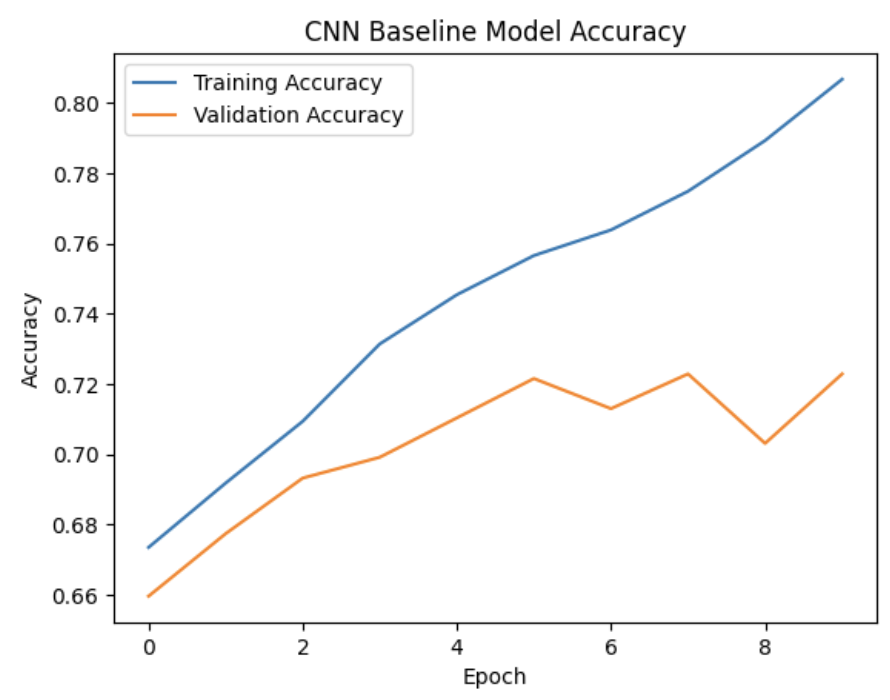
訓練完成後,最後使用先前保留下來的 Test Data 評估模型,這次得到:
Test Loss: 0.7663570046424866
Test Accuracy: 0.7349397540092468
換算成百分比後,這個 CNN Baseline Model 在 Test Data 上的 Accuracy 約為 73.49%,也就是說,在目前的 Test Data 中,模型整體大約有 73.49% 的圖片分類正確
不過,73.49% 就代表模型表現得很好嗎?
這時候就要回想到前面探索 HAM10000 時發現的問題:這個 Dataset 存在明顯的 Class Imbalance,其中 nv 的圖片數量遠高於其他類別
因此,只看整體 Accuracy 還不能知道模型對每一個病灶類別的表現,例如模型可能很會判斷 nv,但對數量較少的 df、vasc 等類別表現較差,最後仍然可以得到看起來不錯的 Accuracy


 iThome鐵人賽
 看影片追技術