
上一篇我們認識了 Neural Network,也知道模型所謂的「學習」,其實就是透過一次又一次的預測與修正,不斷調整內部的 Weight 和 Bias
今天終於要真的把 HAM10000 的圖片丟進模型,建立我們第一個圖片分類模型!
不過這次先不急著使用 CNN,而是從最基本的 Dense Neural Network(全連接神經網路)開始
前面我們讀取的 HAM10000_metadata.csv 裡面有image_id,但真正要訓練模型時,我們需要找到這張圖片實際存放的位置
HAM10000 的圖片分別放在:
所以先建立每個 image_id 和圖片路徑之間的對應:
image_folders = [
    os.path.join(path, "HAM10000_images_part_1"),
    os.path.join(path, "HAM10000_images_part_2")
]

image_path_dict = {}

for folder in image_folders:
    for filename in os.listdir(folder):
        if filename.endswith(".jpg"):
            image_id = filename.replace(".jpg", "")
            image_path_dict[image_id] = os.path.join(folder, filename)

df["image_path"] = df["image_id"].map(image_path_dict)
這樣原本 Metadata 裡的每一筆資料,就多了一個 image_path,之後可以直接根據路徑讀取圖片。
HAM10000 的 dx 就是我們要預測的 Label,但模型最後處理的還是數值,因此我們先將這些文字 Label 轉換成數字
class_names = sorted(df["dx"].unique())
class_to_index = {name: index for index, name in enumerate(class_names)}
df["label"] = df["dx"].map(class_to_index)
類別對應:{'akiec': 0, 'bcc': 1, 'bkl': 2, 'df': 3, 'mel': 4, 'nv': 5, 'vasc': 6}
接著就是 Day9 提到的 Dataset Split,這次我把資料分成:
不過 HAM10000 有一個需要特別注意的地方:同一個 lesion_id 可能會有多張圖片,因此這次使用 GroupShuffleSplit,以 lesion_id 作為 Group 這樣做的目的,就是讓同一個病灶的圖片盡量待在同一組,而不是其中一張跑到 Train、另一張又跑到 Test
from sklearn.model_selection import GroupShuffleSplit

split1 = GroupShuffleSplit(n_splits=1, test_size=0.30, random_state=42)
train_idx, temp_idx = next(split1.split(df, groups=df["lesion_id"]))
資料切好之後,就可以開始處理圖片,前面 Day5、Day6 已經介紹過 Resize 和 Normalization,這邊我先把圖片統一 Resize 成64 × 64,並且確保圖片是 RGB
img = Image.open(row["image_path"]).convert("RGB")
img = img.resize((64, 64))
接著轉成 NumPy Array,最後進行 Normalization
img_array = np.array(img, dtype=np.float32)
img_array = img_array / 255.0
這邊每一張圖片最後的 Shape 都會是(64, 64, 3)
接下來我們真的建立模型
import tensorflow as tf

# 建立一個循序式神經網路模型,資料會依照設定的順序一層一層往下傳
model = tf.keras.Sequential([

    # 輸入層:每張圖片大小為 64 × 64,3 代表 RGB 三個 Channel
    tf.keras.layers.Input(shape=(64, 64, 3)),

    # 將 64 × 64 × 3 的三維圖片攤平成一維資料
    # 64 × 64 × 3 = 12,288 個數值
    tf.keras.layers.Flatten(),

    # Dense 全連接層,共有 128 個 Neuron
    # 使用 ReLU 作為 Activation Function
    tf.keras.layers.Dense(128, activation="relu"),

    # 輸出層:HAM10000 共有 7 個病灶類別,因此設定 7 個 Neuron
    # Softmax 會將輸出轉換成 7 個類別的機率分布
    tf.keras.layers.Dense(7, activation="softmax")
])
model.compile(optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"])
模型會對 Training Data 進行 10 個 Epoch 的訓練,每次使用 32 筆資料進行一次訓練計算
X_train 訓練圖片y_train 正確 LabelX_val Validation 圖片y_val Validation Labelhistory = model.fit(X_train, y_train, validation_data=(X_val, y_val), epochs=10, batch_size=32)
為了更直覺地觀察訓練結果,我把 Accuracy 畫成圖: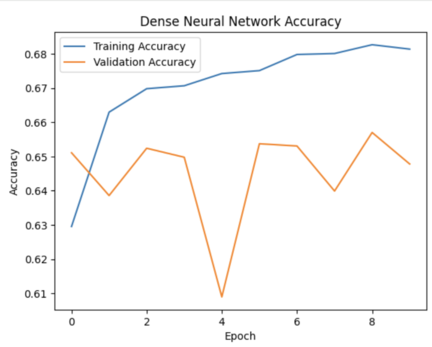
結果:
Test Loss: 0.8850919604301453
Test Accuracy: 0.688085675239563
模型訓練完成後,最後再拿 Test Data 得到 Test Loss 和 Test Accuracy
test_loss, test_accuracy = model.evaluate( X_test, y_test )
最後,我們不只想看 Accuracy,也可以真的拿一張 Test 圖片給模型預測,這時候會得到 7 個 Softmax 數值
prediction = model.predict(X_test[:1])
再使用
predicted_index = np.argmax(prediction[0])
找出最大的數值位在哪一個位置,最後轉回類別名稱:
predicted_class = class_names[predicted_index]
true_class = class_names[y_test[0]]

print("模型預測:", predicted_class)
print("正確答案:", true_class)
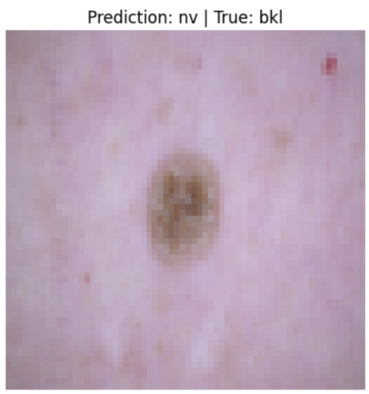
我們把 64 × 64 × 3 的圖片 Flatten 成 12,288 個數值,雖然 DNN 可以進行分類,但這真的是處理圖片最適合的方法嗎?


 iThome鐵人賽
 看影片追技術