
延續生活型態變數探索,聚焦於另一項關鍵護眼行為——每小時休息次數(Break_Frequency_Per_Hour),分析其對「眼睛乾澀(Eye_Dryness_Level)」與「眼痛(Eye_Pain_Level)」的實際影響與趨勢。
一、實作前情境:眼科「20-20-20」法則在數據中的真實樣貌
在Day10的分析中,我們發現抗藍光濾鏡在緩解乾眼與眼痛上的效果非常有限。眼科醫學界常提倡更主動的護眼準則(如美國眼科醫學會推廣的20-20-20法則:每看螢幕20分鐘,眺望20英尺外20秒),強調「定時打斷長時間注視」才是讓睫狀肌放鬆、促使正常眨眼滋潤眼球的根本手段。
在我們的資料集中,Break_Frequency_Per_Hour 記錄了受試者每小時休息的次數(0次至3次):
今天我們就要透過統計分組與視覺化,驗證一個核心問題:相較於被動的抗藍光設備,主動提高每小時休息頻率,是否能在數據中看見顯著的護眼效益?
二、撰寫休息頻率與症狀關聯腳本
為了同時觀察各組的資料分佈範圍(箱形圖)以及平均值的升降走勢(趨勢點圖),在Colab中新增儲存格,使用 sns.boxplot搭配sns.pointplot進行多子圖繪製:
# ==========================================
# Day 11:每小時休息次數對眼部症狀影響分析
# ==========================================

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd

# 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 1.建立1x2畫布佈局
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="whitegrid")

# 設定漸層調色盤(由深至淺,代表休息頻率從低到高)
break_palette = sns.color_palette("Blues_r", n_colors=4)

# --- 圖 1:每小時休息次數 vs 眼睛乾澀程度 ---
sns.boxplot(
    data=df,
    x='Break_Frequency_Per_Hour',
    y='Eye_Dryness_Level',
    hue='Break_Frequency_Per_Hour',
    palette='Blues',
    legend=False,
    width=0.5,
    boxprops=dict(alpha=0.75),
    ax=axes[0]
)
# 疊加平均值趨勢線(Pointplot)
sns.pointplot(
    data=df,
    x='Break_Frequency_Per_Hour',
    y='Eye_Dryness_Level',
    color='#d9534f',
    errorbar=None,
    markers='o',
    linestyles='--',
    ax=axes[0]
)
axes[0].set_title('每小時休息次數 vs 眼睛乾澀程度', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[0].set_xlabel('每小時休息次數(次/小時)', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('乾澀自評分數 (0-10 分)', fontproperties=my_font, fontsize=12)
axes[0].set_xticks([0, 1, 2, 3])
axes[0].set_xticklabels(['0 次 (不休息)', '1 次', '2 次', '3 次'], fontproperties=my_font, fontsize=11)

# --- 圖 2:每小時休息次數 vs 眼痛程度 ---
sns.boxplot(
    data=df,
    x='Break_Frequency_Per_Hour',
    y='Eye_Pain_Level',
    hue='Break_Frequency_Per_Hour',
    palette='Reds',
    legend=False,
    width=0.5,
    boxprops=dict(alpha=0.75),
    ax=axes[1]
)
# 疊加平均值趨勢線(Pointplot)
sns.pointplot(
    data=df,
    x='Break_Frequency_Per_Hour',
    y='Eye_Pain_Level',
    color='#2b5c8f',
    errorbar=None,
    markers='s',
    linestyles='--',
    ax=axes[1]
)
axes[1].set_title('每小時休息次數 vs 眼痛程度', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[1].set_xlabel('每小時休息次數(次/小時)', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('眼痛自評分數 (0-10 分)', fontproperties=my_font, fontsize=12)
axes[1].set_xticks([0, 1, 2, 3])
axes[1].set_xticklabels(['0 次 (不休息)', '1 次', '2 次', '3 次'], fontproperties=my_font, fontsize=11)

plt.tight_layout()
plt.show()

# 2.精確量化:計算各休息組的樣本數與症狀統計量
print("=== 每小時休息次數分組指標統計 ===")
break_stats = df.groupby('Break_Frequency_Per_Hour').agg(
    受試人數=('Age', 'count'),
    乾澀平均=('Eye_Dryness_Level', 'mean'),
    乾澀中位數=('Eye_Dryness_Level', 'median'),
    眼痛平均=('Eye_Pain_Level', 'mean'),
    眼痛中位數=('Eye_Pain_Level', 'median')
).reset_index()

display(break_stats.round(2))
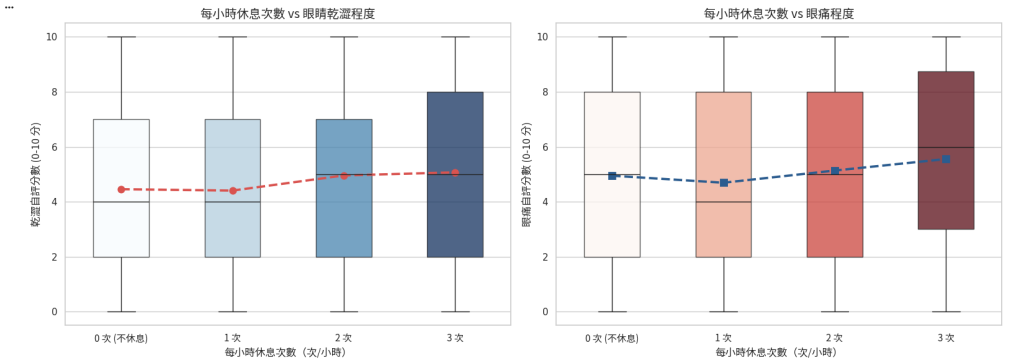
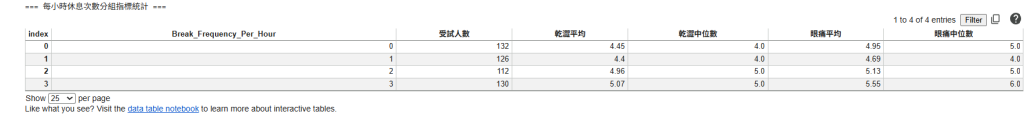
三、圖表解讀與客觀數據分析(打破假設的意外反轉)
觀察分組箱形圖疊加平均值折線的視覺化結果,配合詳細統計表格,可以得出以下具備深度討論價值的洞察:
1.樣本分佈均勻度極佳
樣本量:0次組132人、1次組126人、2次組112人、3次組130人。四個組別的人數都在110~130人之間,代表各組權重完全平衡,分析結果不會受到單一組別人數過少所偏誤。
2.眼睛乾澀程度(Eye_Dryness_Level):休息次數多,乾澀評分反而微幅上升。
量化指標:
趨勢分析:
趨勢分析:
四、資料工程師的深度反思:為什麼多休息沒有降低不適?
這項違反常理直覺的結果,非常適合作為日誌的精彩核心反思:
實作洞察:相關不等於因果,是否存在「反向因果」?
這段分析把探索性資料分析(EDA)「用數據推翻直覺、提出合理假設」的精髓完全展現了出來!


 iThome鐵人賽
 看影片追技術