
🔎 資料可以先留在 Context 外面,前提是 Agent 找得到、讀得到,結論也查得回原文。
昨天在 Day 8|Prompt Cache 命中率:我做 Agent 時最先看的效能指標,我們看到重複送的內容可以靠 Prompt Cache 省下計算,但用不到的資料還是不該一直塞進去。Chroma 的一組測試就發現,同一個問題,只把研究者挑好的相關段落送給模型,比整份長對話丟進去答得好。
快速回顧一下:Day 1 說 Harness 決定模型看得到什麼、被允許做什麼;Day 3 講得更細,Harness 每一輪都在挑要放什麼進去、工具結果要怎麼寫,還示範了一招:大 log 不要整份塞回去,存成檔案,回個路徑再加一句怎麼讀的提示。這兩篇講的其實是同一件事:Agent 做不做得到,要看我們每一輪有沒有給它夠用的工具和資訊,讓它能再往下走一步。
這件事現在有個名字,叫 context engineering。Anthropic 那篇 Context engineering 文章把 system prompt、工具說明、外部資料、對話紀錄都算進 Context,當成有限的資源,要找的是最少、但最有用的那一組內容。
今天要看的就是「給夠」跟「不塞爆」怎麼一起做到:開工時先給入口和工具,Agent 查到哪裡、缺什麼,再自己去拿。
假設使用者回報:結帳服務 checkout 下單 10 秒就 timeout。怪的是,上週才有人把 timeout 改成 30 秒。你請 Coding Agent 查原因。開工前,Harness 先照這段描述撈了一包看起來相關的資料放進 prompt:上週改 timeout 的討論串、那次改的 default.yaml,還有從 log 平台抓來、checkout 正式環境最近的幾千行 log。
Agent 手上也有搜尋工具,但包裡的資料看起來已經夠了。它讀了討論串和 default.yaml,看到 timeout: 30s,就回報:「設定已經是 30 秒了,可能是網路問題。」
它漏掉的是,checkout 其實有兩份設定檔:
services/checkout/config/default.yaml     timeout: 30s   ← 上週改的是這份
services/checkout/config/production.yaml  timeout: 10s   ← 正式環境啟動時才載入,蓋掉上面的值
production.yaml 不在那包資料裡。討論串沒提到它,撈資料時是照相關程度挑前幾筆,它沒被挑中。那份 log 其實印了一行 effective timeout=10s,就在服務啟動那段,只是淹在幾千行裡沒被注意到。
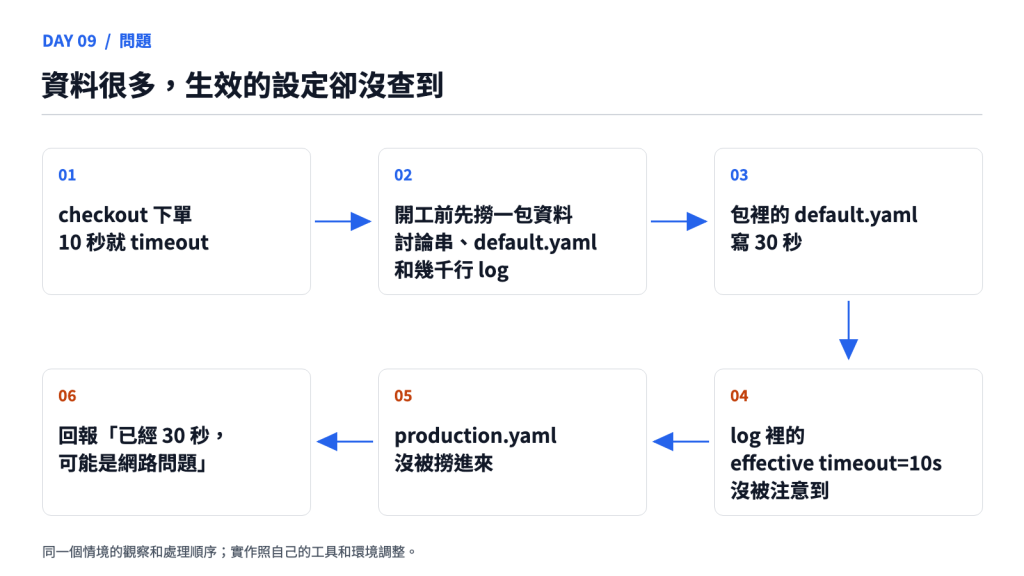
圖:checkout 下單 10 秒就 timeout → 開工前先撈一包資料 → 包裡的 default.yaml 寫 30 秒 → log 裡那行 effective timeout=10s 沒被注意到 → production.yaml 沒被撈進來 → 回報「已經 30 秒,可能是網路問題」。這是示意,實作要照自己的工具和環境調整。
那行 log 為什麼沒被用上,這個案例說不準。可能是資料太多,也可能是它看到 30 秒就下了結論,沒去核對正式環境實際生效的值;Chroma 的測試只能當背景,替這個案例診斷不了。production.yaml 則根本不在包裡,事先沒人想到它,準備得再多也可能漏掉。
開頭那個 Agent 手上就有搜尋工具,照樣沒去找。所以光把資料改成回路徑,也不保證它會查對:入口和工具給的是繼續查的機會,有沒有查對,要看實際任務的表現;自己找也會多出新的錯法,例如搜了一個目錄就說「沒有」。
下面先看開工時要給 Agent 什麼,再沿著 checkout 把調查走一遍;接著看自己找會錯在哪裡、回傳結果要交代什麼,最後回到自己的 Harness 要加什麼。
這種先給入口、需要時再拿的做法,Anthropic 那篇文章叫 just in time:Agent 平常只帶著檔案路徑、查詢語句、網址這類輕量的參照,需要時再用工具把內容載進來。
下面會一直用到「入口」這個詞,指的就是這類能把完整內容找回來的東西,例如檔案路徑、log 的時間區間、commit 加行號。完整內容本身存在 Context 外面,這裡叫它 artifact,例如那份幾千行的 log。重點是拿著入口,真的讀得回同一份內容。
開頭那種「開工前先撈一包」也很常見。Anthropic 同一篇寫,現在很多 AI 產品會在模型開始推論前,先用 embedding 搜尋(把文字轉成向量,找意思相近的內容)撈出相關資料;文章也說,效果好的 Agent 可能會兩種混著用,一部分先撈好求快,其他讓 Agent 自己決定要不要再找。
Claude Code 就是混著用:開工時把 CLAUDE.md 整份放進 Context,程式碼則靠 glob、grep 這類工具需要時才找。Claude Code 的 memory 文件也寫了怎麼分:CLAUDE.md 只放每次對話都要知道的事,例如 build 指令、專案慣例、「一律要做 X」這類規則,建議控制在 200 行內;只跟程式庫某一塊有關的,就移出去,需要時再載入。log、整個程式庫、舊討論這些又大、又只有某些任務用得到的,我也會留在外面給入口。
工具本身也可以只給入口。Cursor 的 Dynamic context discovery 把 MCP(讓 Agent 接外部工具和資料的協定)的工具說明同步成資料夾,Agent 平常只看到工具名稱,要用時才讀完整說明。工具怎麼按需出現,是 Day 15 的題目。
放回 checkout,開工時給的是使用者的回報、服務名稱和環境、每次都要守的專案規則,再加上幾個工具:搜尋、讀檔、從 log 平台抓 log,和一份 repo map。討論串和那幾千行 log 先不放,Agent 要的時候再拿。
開工時,Agent 只知道一件事:設定改成 30 秒,實際卻在 10 秒 timeout。它還不知道有 production.yaml。
抓 log。 Agent 先要了 checkout 正式環境最近的 log。executor 是 Harness 裡實際執行工具的那段程式,它拿到幾千行,把完整內容存成 artifact,回給模型的只有:log 在哪裡、總共幾行、怎麼搜尋和分段讀。Cursor 同一篇也是這樣處理 shell 指令和 MCP 呼叫的長輸出:寫進檔案,Agent 先用 tail 看結尾,需要再往前讀。文章說以前常見的做法是直接截斷,可能把重要的資訊一起丟掉。
在 log 裡搜 timeout。 搜到 effective timeout=10s。這一行推翻了「設定已經是 30 秒」:正式環境實際生效的是 10 秒。問題變成 10 秒是從哪裡來的,Agent 接著讀這一行附近的啟動紀錄,看到正式環境除了 default.yaml,還載入了 production.yaml。
找載入設定的程式。 知道有兩份檔案之後,要確認誰蓋掉誰。Agent 在 services/checkout/** 底下搜 timeout,看還有哪些地方寫到它,再從 repo map 找負責載入設定的 function。
Aider 的 repo map 就是這種程式庫目錄:列出每個檔案裡重要的 symbol(function、class 這類有名字的程式單位)和定義它們的那幾行程式碼。它把檔案之間的依賴畫成圖來排序,大致上被越多地方引用的排越前面,挑到塞滿 token 預算為止(--map-tokens,預設 1k)。模型看了覺得需要哪個檔案,就開口要,Aider 問過使用者再加進對話。地圖只能指方向,預設值、條件分支這些細節不在上面。
讀原文確認。 Agent 讀同一個 commit 的載入程式和這兩份檔案:正式環境啟動時先讀 default.yaml,再讀 production.yaml,後者的 10 秒蓋掉前者的 30 秒。
回頭看,從搜 timeout 開始,每一步要查什麼都是上一筆證據帶出來的。 開工時沒人知道要找 production.yaml,是 log 裡那一行讓它出現;知道有兩份檔案,才需要去讀載入的程式。事先準備的那包資料,只能照開工時的猜測挑。
到這裡能說的是「這次啟動載入的 production.yaml 蓋掉了預設值」。要說「整個系統只受這個檔案控制」還太早,其他啟動方式和部署設定都還沒查。
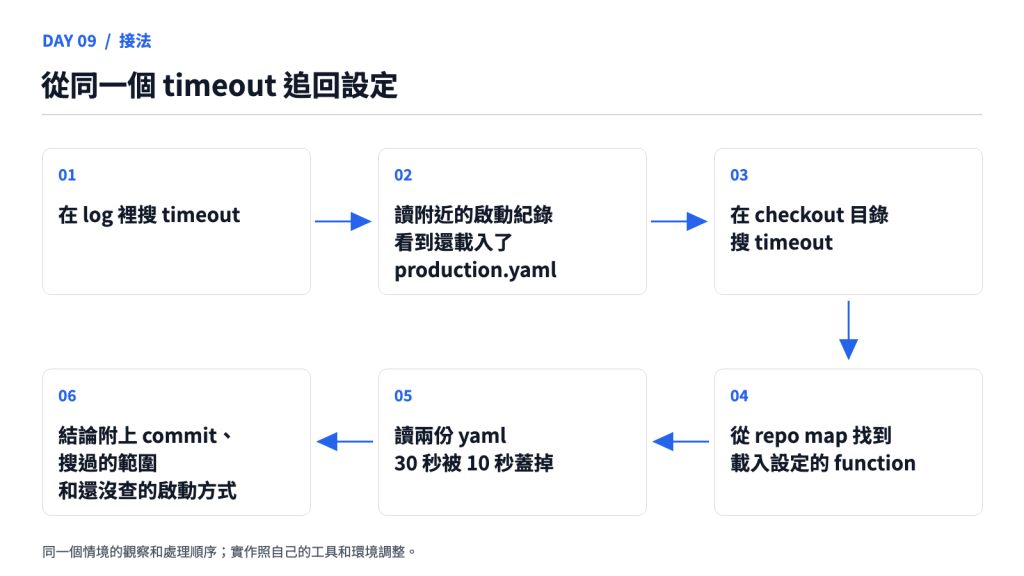
圖:在 log 裡搜 timeout → 讀附近的啟動紀錄,看到還載入了 production.yaml → 在 checkout 目錄搜 timeout → 從 repo map 找到載入設定的 function → 讀兩份 yaml,確認 30 秒被 10 秒蓋掉 → 結論附上 commit、搜過的範圍和還沒查的啟動方式。這是示意,實作要照自己的工具和環境調整。
查完之後,讀回來的那幾段 log、兩份 yaml 和那個 function 還留在對話裡,之後每一輪都會跟著送。Anthropic 的 context editing(目前是 beta)可以把舊的工具結果換成佔位文字,代價是 prompt cache 從那裡往後失效。能這樣清,前提是內容還讀得回來,Manus 把這叫可以還原的壓縮:內容從 Context 拿掉,路徑或網址留著。對話變長之後怎麼整理,Day 11 講壓縮時再談。
Anthropic 那篇 Context engineering 文章講得很直接:執行時才探索,比讀預先算好的資料慢;沒給對工具和方向,Agent 會亂用工具、追進死路,或漏掉關鍵資訊。Sourcegraph(賣程式碼搜尋的公司)用自己做的 benchmark 分析了 1,281 次 Agent 執行,歸出五類失敗:在程式庫裡迷路、找錯檔案或 symbol、只找到一部分該改的地方、反覆呼叫工具卻沒進展、讀了太多無關的程式碼而失焦。
上面那四步,每一步都可能查錯,Agent 自己不一定知道。能讓它發現的,是搜尋和讀檔工具多回的幾個欄位,看了才知道下一步該續查、重讀,還是把結論說小。這組欄位是我整理的,沒看到哪家 Agent 剛好照這樣回:
| 欄位 | 這個情境的值 | 防的是哪種錯 | Agent 看到之後怎麼做 |
|---|---|---|---|
| query/root | timeout;services/checkout/** |
只搜一個目錄,就說整個系統沒有別的 timeout 設定 | 結論限在 checkout 目錄;要講全系統,先擴大範圍再搜 |
| truncated | False:12 筆全部回來了 |
命中 200 筆只回前 50 筆,以為只有 50 處 | 是 True 就縮小範圍或續查,不能當成全部 |
| version | 程式碼是 commit a1b2c3d;log 是抓取的時間區間 |
索引上個月建的,搜到的 default.yaml 還是改之前的值 |
跟要下結論的版本不同,就用同一個 commit 重讀 |
| path/range | config/production.yaml;第 1–40 行 |
log 已經存成檔案,只看了前 20 行就開始推論 | 知道讀過哪幾段,沒讀到的再去讀 |
| complete | True:第 1–40 行就是整份檔案 |
讀檔只回了前面一段,以為看完了 | 是 False 就續讀,讀完再下結論 |
這幾種錯的出處不一樣。截斷有現成的做法可以對照:Anthropic 的工具設計文章提到 Claude Code 預設把工具回應限制在 25,000 token,截斷時附一句指引,例如叫 Agent 改成多次、範圍小的搜尋;GitHub 的搜尋 API 在查詢超過時間上限時,先回已經找到的結果,同時把 incomplete_results 設成 true。索引過期是 Cline 提的。範圍太小和只讀一部分是我從 checkout 推的,接近 Sourcegraph 說的「只找到一部分」和 Anthropic 說的「漏掉關鍵資訊」。
零筆也要帶查詢範圍,才知道這個「沒有」是對哪裡說的。這些欄位留下來,事後換手的人也能照著追查。
兩個工具包在既有的搜尋和讀檔外面。搜尋時多要一筆,就知道後面還有沒有;讀檔時把實際讀到的範圍、有沒有讀完一起帶回去。下面是示意,search 和 read 換成你手上現有的搜尋和讀檔:
MAX_HITS = 50

def search_evidence(search, query, root, version):
    hits = search(query, root=root, version=version, limit=MAX_HITS + 1)
    return {"query": query, "root": root, "version": version,
            "hits": hits[:MAX_HITS], "truncated": len(hits) > MAX_HITS}

def read_evidence(read, path, version, line_range):
    result = read(path, version, line_range)
    return {"path": path, "version": version, "content": result.content,
            "range": result.returned_range, "complete": result.complete}
在 checkout 的情境裡,它們是這樣被叫到的:
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
| executor | 模型要了 checkout 正式環境最近的 log | 幾千行存成 artifact,回給模型 log 位置、總行數和讀法 |
loop 照模型的要求呼叫 search_evidence |
在 log 裡搜 timeout,再到 services/checkout/** 搜一次 |
log 裡找到 effective timeout=10s;程式碼那次 truncated: False,模型知道 12 筆就是 checkout 目錄裡的全部 |
loop 呼叫 read_evidence |
讀載入設定的 function 和兩份 yaml | production.yaml 回 complete: True,模型不用續讀,直接拿 10 秒那行下結論 |
| 模型回報結論 | 準備回答使用者 | 結論附上查的 commit 和搜過的範圍,說明其他啟動方式還沒查 |
假設你已經做到 Day 8:看得到每輪 request 放了什麼,也能核對 cache 用量。下一步照這個順序加:
第一步,長輸出存檔、回入口。 executor 把超過一定長度的工具輸出存成 artifact,回給模型路徑和讀法。Day 3 講過單一工具怎麼回,這一步是讓它變成每個工具的預設。artifact 要存在讀得回來的地方;worker 會換機器的話,Day 7 講過只留在舊機器上的東西不會自己跟過去。
第二步,把入口寫清楚。 工具說明除了名字,也要寫什麼時候用、能查哪些範圍、怎麼繼續讀。以 checkout 來說,log 工具要寫得出能查哪些服務、多久以前的 log,存成檔案之後怎麼搜、怎麼分段讀。入口也要分得出「沒權限」和「沒資料」:log 平台授權過期時回沒權限,Agent 才知道要請人重新授權,不會以為 log 不存在。
第三步,搜尋和讀檔回報範圍、版本、有沒有讀完。 照上面那張欄位表加。用現成框架的話,看它的搜尋工具回傳有沒有帶範圍和截斷資訊,沒有就自己包一層。
第四步,確認這樣做有幫上忙。 拿開頭的 checkout 當測試題,先撈一包和只給入口兩種做法各跑幾次,比較有沒有查到 production.yaml、花了幾輪、用了多少 token。按需讀也有代價:多了工具往返,花的時間可能比直接帶入一小段資料還長;搜尋介面不好用,token 是省了,Agent 卻一直在錯的地方打轉。有了第三步的紀錄,結果不好時才分得出是沒找到、找錯地方,還是找到了沒讀。怎麼把這種比較做成可以重跑的 Eval,Day 29 會細談。
單一 repository、Agent 大多一兩輪就找到位置的話,做到第三步就夠了,不用先建程式碼索引。Cline 就不建,理由是程式碼切塊做 embedding 會把邏輯切散、索引會跟實際程式碼對不上、多一份副本也多一份要保護的資料。Sourcegraph 自己的 benchmark 則顯示,程式庫超過約 40 萬行,只靠 grep 和讀檔的 Agent 開始吃力,40 萬行以下 grep 通常就夠;這組數字要連著出處一起看。程式庫大到幾十萬行,或 Agent 一直在同一塊換關鍵字、範圍卻沒縮小,再評估索引。
Day 10 會查找到的文件有沒有真的送進模型,Day 16 接截斷之後怎麼續讀,Day 17 把搜尋收斂到 symbol 和 reference,也會細看 Sourcegraph 那組數字。
回到查設定的例子,可以試著問自己:只搜過 services/checkout/**,就能說整個系統沒有其他設定嗎?開頭那個 Agent 手上有搜尋工具,為什麼還是沒查到 production.yaml?
第一題不行,只查一個目錄就下全域結論,等於把沒查到說成不存在。第二題,它看到 30 秒就停了,沒去核對 log 裡實際生效的值;production.yaml 要從那行 effective timeout=10s 往下追才會出現。
資料可以先不放進 Context,但要找得到、讀得到,也查得回來。 每個結論都要對得上查過的範圍和版本,零筆結果也一樣。
明天接著看容易被忽略的下一步:文件和索引都有了,Agent 為什麼還是用舊 API?找到入口、讀取成功,和內容真的送進模型,是不同的檢查點。
CLAUDE.md、用 glob 和 grep 按需找;執行時探索比較慢,也可能追進死路或漏掉關鍵資訊。CLAUDE.md 只放每次對話都要知道的事、控制在 200 行內,只跟某一塊程式有關的移出去,需要時再載入。--map-tokens 預設 1k,和模型要求加入檔案的流程。incomplete_results 設成 true;這裡拿來當標出截斷的現成例子。

 iThome鐵人賽
 看影片追技術