
最近做企業內部系統時,我一直遇到一個很矛盾的問題。
很多員工問題看起來根本就是 AI 最適合處理的:
「育嬰留停可以請多久?」
「出差可以報哪些費用?」
「這種情況算不算加班?」
「我符合這個福利資格嗎?」
大量、重複,而且答案散落在不同 Policy、FAQ 和 System 裡。
但真的討論要不要讓 AI 回答時,大家反而非常保守。
因為最怕的是:
「AI 如果講錯政策怎麼辦?」
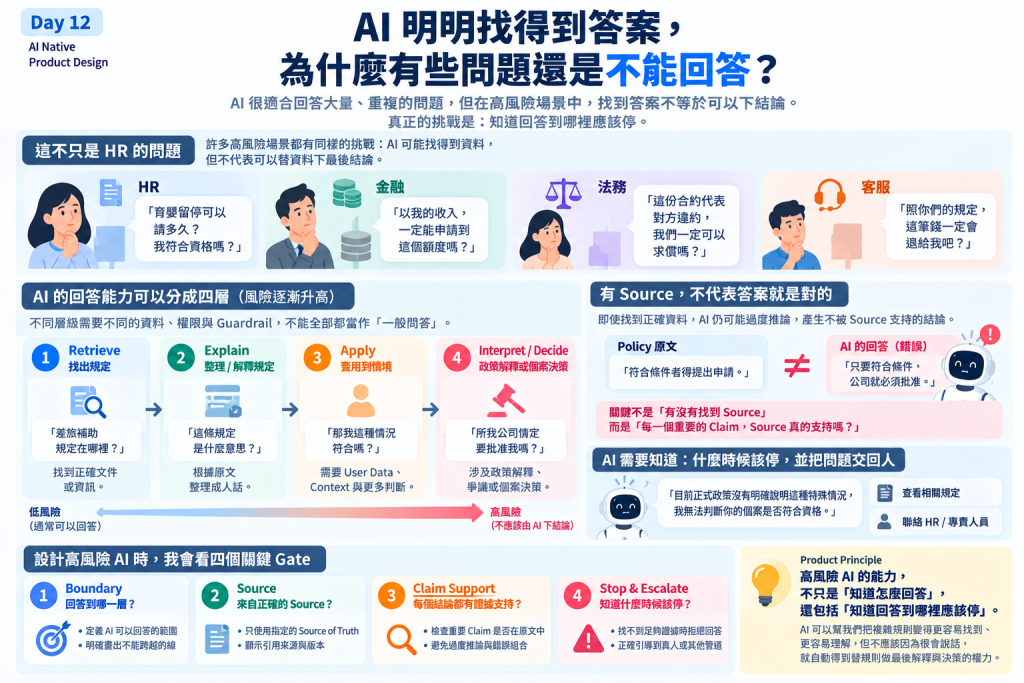
而且這其實不只是 HR 的問題。
金融 AI 可能遇到:
「照我的收入,我一定能申請到這個額度嗎?」
法務 AI 可能被問:
「所以這份合約代表對方違約,我們一定可以求償?」
客服 AI 也可能遇到:
「照你們的規定,這筆錢一定會退給我吧?」
這些問題的共同點都是:
AI 可能找得到相關資料,但不代表它有資格替資料下最後結論。
所以這篇真正想討論的不是 HR。
而是所有 High-stakes AI 都會遇到的一個 Product Problem:
AI 到底應該回答到哪裡?
以前做 FAQ 很簡單。
User 選擇問題
      ↓
System 顯示 Review 過的內容
公司 Review 過什麼,User 就看到什麼。
但 LLM 最大的優點,偏偏也是高風險場景最大的風險。
它會:
理解問題
↓
找資料
↓
整理資訊
↓
組織答案
↓
推論
↓
繼續對話
每往前一步,都可能離原始 Source 更遠一點。
例如 Policy 只寫:
「符合條件者得提出申請。」
User 接著問:
「所以只要符合條件,公司就一定會批准?」
如果 AI 很自然地回答:
「是的。」
它其實已經不是在 Retrieve Policy。
而是在替 Policy 做 Interpretation。
所以高風險 AI 第一個要定義的,不是:
Answer Rate 要多少?
而是:
Answer Boundary 在哪裡?
很多產品一開始會把需求寫成:
「做一個 Policy Q&A。」
但我現在會覺得這個定義太粗。
因為「回答問題」至少可以拆成四層:
「差旅補助規定在哪裡?」
找到正確文件或資訊。
「這條規定是什麼意思?」
根據原文整理成人話。
「那我這種情況符合嗎?」
開始需要 User Data、Context,以及更多判斷。
「所以公司一定要批准我嗎?」
開始涉及政策解釋、爭議或個案決策。
Retrieve
   ↓
Explain
   ↓
Apply
   ↓
Interpret / Decide

風險逐漸升高 →
這四層需要的 Data、Permission、Evals 和 Guardrail 完全不同。
所以 PM 真正該問的不是:
AI 能不能回答?
而是:
我們允許 AI 回答到哪一層?
如果答案牽涉 Policy,我不希望 AI 根據:
「Model 本來知道什麼。」
回答。
而應該根據指定的:
Source of Truth。
例如:
正式 Policy
經 Review 的 FAQ
最新版內部規範
AI 可以負責理解 User 的問法,也可以把難讀的條文整理成人話。
但重要 Claim 必須能回到正式 Source。
例如:
依據目前規定,你可以……
Source:XX 管理辦法|第 X 條|更新日期
但這裡還有一個很重要的陷阱:
有 Citation,不代表答案就是對的。
假設正式 Policy 寫的是:
「符合條件者得提出申請。」
AI 卻回答:
「只要符合條件,公司就必須批准。」
Citation 甚至真的連到那份 Policy。
看起來非常可信。
但其實答案還是錯。
因為 Source 只支持:
可以提出申請
AI 卻多推成:
一定會批准
所以高風險 AI 不能只 Review:
Source 找對了嗎?
還要再問:
每一個重要 Claim,Source 真的 Support 嗎?
Correct Source
≠
Supported Claim
我覺得這是做 Policy / Financial / Legal AI 時,非常容易被忽略的一層。
另一個風險是,User 不一定一開始就問危險問題。
可能慢慢問:
Policy 沒寫一定要主管同意?
        ↓
所以不用主管同意也可以?
        ↓
所以 HR 不讓我申請就是違規?
如果 AI 的邏輯是:
上一輪我說 A
→ 這輪推 B
→ 再從 B 推 C
很容易越走越遠。
所以重要結論應該重新回到 Evidence:
Current Question
      ↓
Retrieve Source
      ↓
Source 支持這個 Claim?
    ↙             ↘
  Yes              No
   ↓                ↓
Answer        Stop / Escalate
Conversation History 可以提供 Context,但不能自己變成 Source of Truth。
以前做產品,我們很容易追求:
Answer Rate 越高越好。
但高風險 AI 反而需要另一個能力:
Correct Refusal。
例如:
「目前正式規定沒有明確說明這種特殊情況,我無法判斷你的個案是否符合資格。」
接著提供:
[ 查看相關規定 ]
[ 聯絡負責人 ]
看起來沒有那麼「Smart」。
但比 AI 很有自信地猜一個答案安全得多。
所以這類產品不能只看:
Answer Rate
還可以看:
Supported Answer Rate
Unsupported Claim Rate
Correct Refusal
Escalation Accuracy
該回答的答對,和不該回答的知道停,同樣重要。
User 問:
「申請資格是什麼?」
AI 可以根據 Source 回答一般規則。
但下一句:
「所以我符合嗎?」
已經是另一個 Task。
因為 Individual Decision 可能需要:
User Data
歷史紀錄
完整 Context
Permission
Business Rules
資料不完整,就不應該直接回答:
「你符合。」
這件事放到其他產業也一樣。
金融:
「貸款資格有哪些?」
≠
「我一定會核貸嗎?」

法務:
「合約的解約條款是什麼?」
≠
「這個 Case 我一定能解約嗎?」

客服:
「退款規則是什麼?」
≠
「我這筆訂單一定會退款嗎?」
前者是在 Explain Rule。
後者已經開始進入 Individual Decision。
PM 必須刻意把兩者拆開。
最後我會把它收斂成四個問題:
1. Boundary
AI 被允許回答到哪一層?

2. Source
答案是否來自指定的 Source of Truth?

3. Claim Support
每個重要結論,Evidence 真的支持嗎?

4. Stop & Escalate
Evidence 不夠時,AI 知不知道要停?
這其實也延續了昨天 Day 11 講的 Success Criteria。
昨天問的是:
什麼叫 AI 做得對?
到了 High-stakes AI,還要再多定義一件事:
什麼時候「不回答」,反而才是做對?
HR Policy、金融規則、Legal Document、Customer Service,看起來都是非常適合 AI 的場景。
大量 Knowledge。
大量重複問題。
大量人工解釋成本。
但也正因如此,我覺得這些產品不能只追求:
「回答得像人。」
還要確保 AI:
知道答案從哪裡來
知道 Evidence 支持到哪裡
知道什麼不能繼續推論
知道什麼時候應該交回人
高風險 AI 的能力,不只是「知道怎麼回答」,還包括「知道回答到哪裡應該停」。
AI 可以幫我們把複雜規則變得更容易找到、更容易理解。
但它不應該因為很會說話,
就自動得到:
替規則做最後解釋與決策的權力。


 iThome鐵人賽
 看影片追技術