
Day 8 排隊的兩個候選,caveman 上禮拜測完了,今天輪到另一個:ponytail——GitHub 上有 14 萬多顆星星、一個把 YAGNI 原則(你不會需要它)塞進 AI 編碼判斷的 skill。這個 skill 有意思的地方,是它主張的東西——不要過度設計、不要加沒人要求的抽象層——本來就已經是 Claude 系統層級教過的原則。今天想測的問題不是「這個原則對不對」,是「裝了這個 skill,跟這個原則本來就內建在模型裡,兩者之間有沒有可以測出來的差異」。
ponytail,作者 Dietrich Gebert,MIT 授權,官方一句話宣稱:「讓你的 AI agent 像房間裡最懶的資深工程師一樣思考。最好的程式碼,是你從來沒寫過的那段。」SessionStart(session 一開始)、SubagentStart(子代理啟動時)這幾個掛鉤上,自動把整套規則注入進去——預設模式是 full,代表裝好、啟用之後,不用做任何事就會一直生效,這點跟一定要打 /i-have-adhd才會啟動的設計完全相反ponytail: 開頭的註解標記,講清楚簡化的天花板在哪、之後要怎麼升級——不是悄悄簡化,是留下明講的紀錄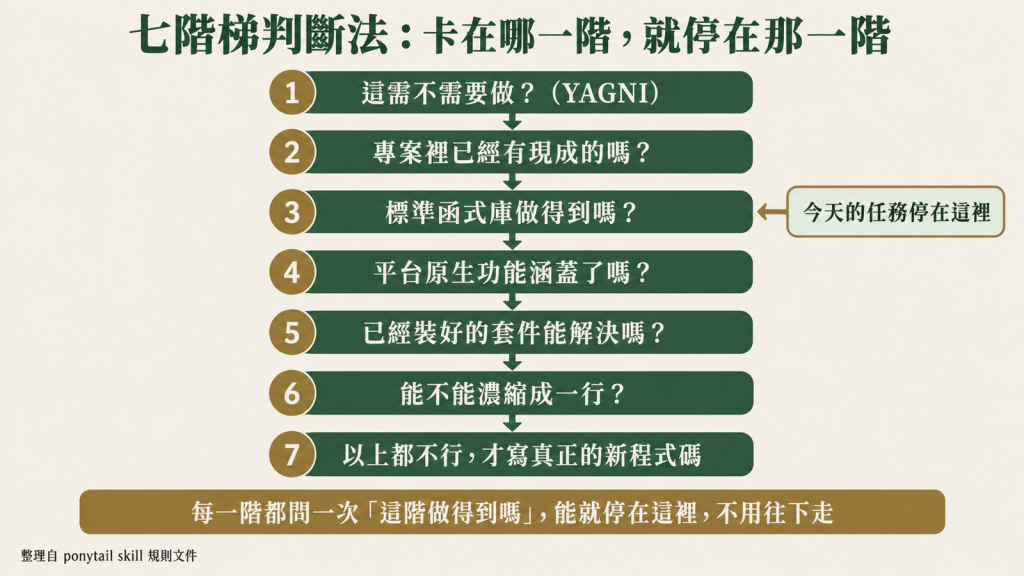
把今天的任務套進七階梯走一遍:第一階「這需不需要做」——註冊表單需要擋掉明顯打錯的 email,答案是需要,往下走;第二階「專案裡已經有現成的嗎」——這是一個獨立的測試腳本,沒有既有專案脈絡,跳過;第三階「標準函式庫做得到嗎」——Python 內建的 re 模組正則表達式完全能處理格式檢查,答案是可以,梯子在這裡停住,不用往下走到「要不要裝新套件」或「能不能濃縮成一行」。實際輸出也正好停在這一階:用 re.compile 加幾行長度與字元檢查,沒有引入任何外部套件(例如 email-validator 這類現成套件),也沒有為了炫技把整個檢查硬塞成一行難以閱讀的正則。基線版本雖然也停在同一階(同樣用 re),但額外多做的 docstring、isinstance 防呆、五點條列說明,某種程度上是把「這階做完就好」的界線往外推了一點——不是換了更複雜的手段,是在同一個手段上多包了一層說明與防禦性檢查,而這些防禦性檢查(呼叫方傳非字串)不在任務描述的假設範圍內,表單輸入本來就一定是字串。
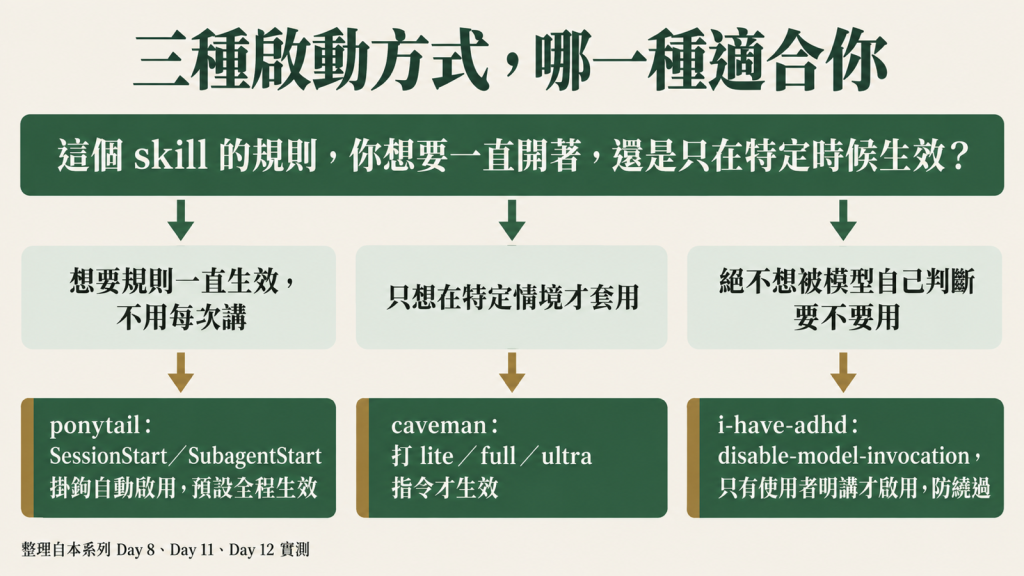
這系列測到現在,已經看過兩種不同的技能啟動方式:Day 8 的 i-have-adhd 靠 disable-model-invocation: true 加上系統層級的防繞過機制,只有使用者明講才會生效,而且刻意設計成不能被「模型自己判斷該不該用」繞過;Day 11 的 caveman 靠明確的觸發詞(lite/full/ultra/wenyan 各一組指令),沒打指令就是平常的樣子。這兩種都需要「使用者主動做一件事」才會啟動。
ponytail 是第三種:不靠使用者輸入觸發,也不靠模型自己判斷要不要用,是掛在 session 生命週期的事件上——SessionStart 在一個新 session 開始時觸發,SubagentStart 在子代理啟動時觸發,兩者都會呼叫對應的 .js 檔案,把整套規則文字寫進當時的上下文。翻開 ponytail-config.js,裡面寫死 const DEFAULT_MODE = 'full';——這代表只要這個 plugin 是啟用狀態,规則就會在每一個新開的 session、每一個新啟動的子代理身上自動生效,不需要任何人講一句話。這也是為什麼今天測試時,第一次嘗試在同一個既有 session 裡直接呼叫裝好的 skill 沒有生效——SessionStart 只在 session 真正重新開始時觸發一次,用同一個舊 session 硬測,掛鉤根本沒有機會執行,最後改用全新的 headless claude -p 行程才讓規則正確注入。這個操作上的細節,剛好呼應了系列裡重複出現的同一條教訓:新裝的能力,要用一個真正全新的行程去驗證,不能假設舊 session 會自動感知到。
問題是「寫一個函式,檢查使用者在註冊表單輸入的字串是不是合法的 email 格式」。這題經典的陷阱在於,稍微不節制一點,很容易被寫成一個完整的 EmailValidator 類別,帶著可設定的驗證規則、可擴充的檢查器介面、支援多種驗證嚴謹程度的參數——結果使用情境其實就是表單擋一下明顯打錯的輸入,用不到那麼多。這題沒有標準答案,重點是看兩邊怎麼拿捏「夠用」跟「完整」之間的分寸。
沒裝 ponytail 的版本,寫的是一個函式,不是類別,用的是標準函式庫 re,這點是對的,沒有掉進最誇張的過度設計陷阱。但看細節,還是加了幾個沒人要求的東西:完整的 docstring(含 Args、Returns 區塊)、一個防呼叫方傳非字串進來的 isinstance 檢查、程式碼後面接了一段五點條列的「設計上的幾個重點」說明,最後還主動問「如果需要更嚴謹(例如要擋一次性信箱、要驗證 MX record),可以再告訴我,我可以加上去」——這句話本身就是在往外延伸範圍,不是被要求的事。整體不算誇張,但明顯比「剛好夠用」多做了一截。
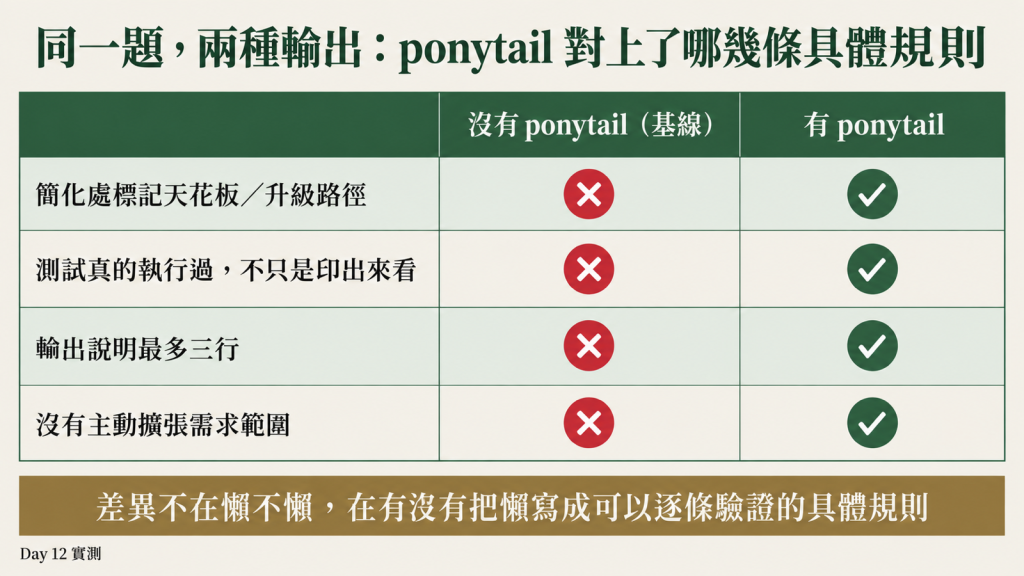
裝了 ponytail 的版本,程式碼本身更精簡(26 行,沒有 docstring),但更值得看的是它精準對上了規則裡幾條很具體的條款,不是含糊地「看起來比較簡單」而已:
規則說故意簡化的地方要用 ponytail: 註解標記天花板跟升級路徑,實際輸出的第一行程式碼就是:
# ponytail: pragmatic format check, not full RFC 5322; real proof = send confirmation email
一句話講完「這不是完整規範、只是務實檢查」跟「真的要確認信箱存在,得靠寄驗證信」——天花板跟升級路徑都在這一行裡。
規則說非小可的邏輯要留一個可以直接跑的檢查,實際輸出不只是把測試案例印出來看,是寫了 assert 陳述式、存成檔案、自己執行過確認全部通過,回報裡明講「實際跑過,全部通過」。我事後重新獨立執行這個檔案,assert 全部通過——不是它自己說有測,是真的測過了。
規則說輸出格式是「程式碼優先,最多三行短說明」,實際輸出程式碼後面剛好是三段簡短說明(會擋掉哪些格式、不支援哪些格式、格式對不代表信箱真的存在),沒有像基線那樣延伸成五點條列,也沒有主動問要不要加更多功能。
重讀 ponytail-instructions.js 裡那份「不准簡化掉」的清單,第二條寫的是「信任邊界的輸入驗證」——而今天測的任務,剛好就是一個信任邊界的輸入驗證:使用者從註冊表單輸入的字串,在還沒確認格式之前,對系統來說就是不可信的外部輸入。這代表這次測試其實同時測到了兩件事:一是「懶」的判斷夠不夠精準,二是這個 skill 有沒有真的守住自己寫的例外——會不會因為追求精簡,把這題該有的嚴謹度也一起砍掉。
從結果看,兩件事都測到了正確方向:程式碼確實比基線短,但沒有省略任何一項該擋的格式檢查——空字串、缺少 @、多個 @、長度上限、連續點號、標籤前後的連字號,這些跟資安或資料完整性有關的邊界一項都沒有少,反而比基線多防了幾種。「懶」省下來的地方,是文件字數(沒有 docstring)跟輸出的說明篇幅,不是驗證邏輯本身的嚴謹度。這剛好對應規則清單裡的分界線:懶要用在「多餘的解釋、沒人要的擴充功能」上,不能用在「輸入驗證」這種明講不准簡化的項目上。如果今天測到的是相反結果——程式碼變短、但漏掉了某幾種原本該擋的輸入——那就代表這個 skill 把「精簡」跟「省略必要的嚴謹度」搞混了,那會是一個值得寫進文章的負面發現。這次沒有出現這種情況,但值得記下來:往後如果要測 ponytail 在更明顯踩到例外清單邊界的任務(例如牽涉安全機制、無障礙功能的題目),這個「有沒有守住自己畫的線」才是更嚴格的考驗。
比對兩邊擋掉的輸入情境,基線測了空字串、缺 @、@ 重複、有空白、前後空白、網域缺失這幾類;ponytail 版本額外多防了連續兩個點(a..b@x.com)、點出現在 local part 的開頭或結尾(.a@x.com、a.@x.com)、網域標籤用連字號開頭或結尾(a@-x.com、a@x-.com)——這幾種都是真實世界裡偶爾會出現、規則寫得鬆的驗證函式容易漏掉的邊界情況。程式碼變短,但涵蓋的邊界情況變多,這跟 Day 11 測 caveman 時看到的現象是同一種模式:省下來的篇幅不是靠犧牲完整性換來的。
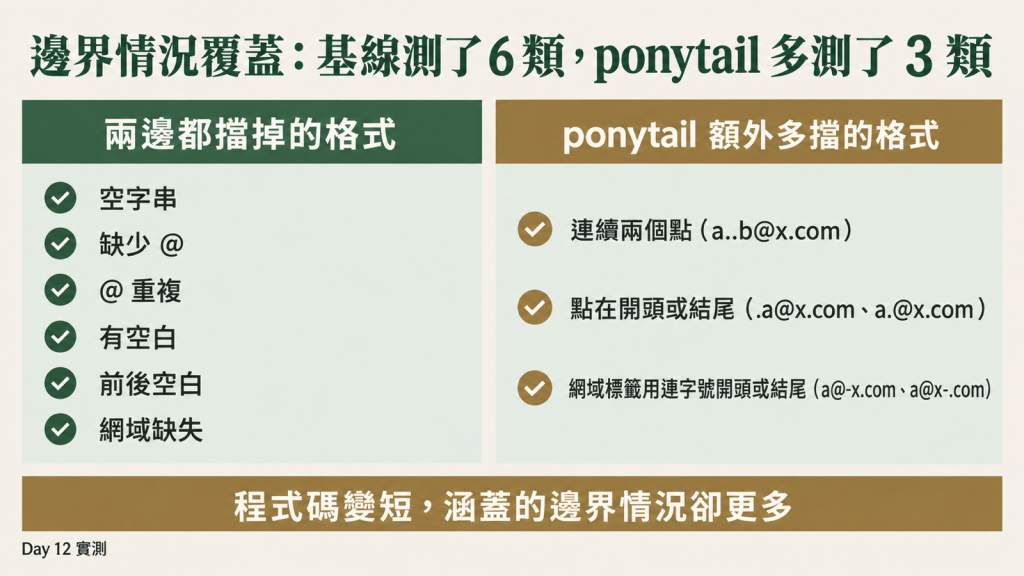
回到一開始想問的問題:Claude 本來就有「不要過度設計」的系統層級指引,這次基線也確實沒有寫出誇張的過度設計,那 ponytail 到底多帶來了什麼?答案不是「從會過度設計變成不會」,兩邊都沒有過度設計;差別在具體的、可以逐條對應規則文件的行為細節——固定格式的簡化說明註解、真的執行過的測試而不是印出來看看、明確的輸出長度紀律。這些細節不是「更謹守 YAGNI」這種抽象方向,是幾個具體到可以逐字對照規則文件的行為,這代表就算大方向本來就對,一份寫得夠具體的規則文件,還是能在執行細節上留下可以驗證的痕跡,不是重複而已。
這個發現也回應了系列前幾天一直在驗的同一件事:判斷一個規則有沒有生效,不能只看「結果感覺起來對不對」,要看有沒有可以指出來的具體痕跡。Day 9 測 CodeQL 跟 Semgrep 的差別,靠的是能不能重建完整的跨檔資料流路徑;Day 10 測 codex 對抗式審查,靠的是它有沒有量出具體數字(一萬個快取項目、一千萬字元)而不是含糊地說「有風險」。今天的判準是同一種邏輯:不是問「ponytail 讓程式碼看起來比較懶惰嗎」,是問「規則文件裡寫的具體條款,有沒有在輸出裡留下可以逐字對照的痕跡」。三天測的技能性質完全不同,但驗證的方法論是同一套——找得到具體證據的說法才算數,找不到就只是印象。
ponytail: 這種標記慣例,就算不裝這個 skill,自己手動採用也有價值。 故意簡化的地方留一句話講清楚天花板在哪、之後怎麼升級,這個習慣本身就值得參考,不需要依賴工具才能做到。caveman、i-have-adhd 都需要主動觸發不一樣,ponytail 裝好就是預設行為,如果你偶爾需要比較完整、偏保守的實作方式,得記得明講關掉,不是自己選要不要用。SessionStart/SubagentStart 這類掛鉤自動啟動的 skill,裝好之後最好在一個全新的 session 裡確認它真的生效過一次,不要假設裝了就一定有作用。 這類啟動方式不像明講觸發詞那樣有清楚的「我現在啟動了」訊號,最保險的做法是像今天一樣,直接觀察輸出裡有沒有出現規則要求的具體痕跡(例如那行 ponytail: 註解),而不是憑感覺判斷。SessionStart 掛鉤在長時間、多輪對話的 session 裡會不會因為上下文被壓縮、規則被稀釋而逐漸失效,今天測的是掛鉤剛觸發、規則剛注入的第一手效果,沒有測到規則在長 session 裡的持久度。前面測 i-have-adhd、caveman,都是在測「一個持久生效的風格規則,會不會影響輸出的樣子」;今天測 ponytail,問的是同一類問題的更深一層:如果模型本來就有類似的傾向,這個 skill 還剩下多少價值?答案不是「沒有價值」,是「價值換了個位置」——不在於扭轉一個原本會犯的錯,在於把一個模糊的好習慣,變成幾條可以逐一核對、逐一驗證的具體規則。這系列走到第十二天,量的東西一直在變,但方法沒變:不管測的是能力、是審查方式、還是一個原則裝不裝 skill 有沒有差,答案永遠是拿出來跑一次才知道,不是用猜的。
回頭看這系列已經測過的十二個技能,啟動方式分成三種:需要明講才生效、需要打特定指令才生效、不需要任何動作就自動生效。哪一種比較適合你,答案不在「哪個原則比較好」,在於你想不想讓一個規則永遠開著。如果你多數時候都想要精簡、只有偶爾需要完整版,ponytail 這種預設自動啟用、需要時再明講關掉的模式比較省事;如果你只在特定場合(例如快速原型、除錯)才想要這種風格,需要主動觸發的模式反而比較安全,不會在不該精簡的場合也被套用。這是今天測完之後,比「哪個 skill 比較厲害」更值得帶走的判斷依據。
這系列接下來還是每篇一個獨立的技能卡,累積起來變成一份你自己就能查的 skill 選用清單。


 iThome鐵人賽
 看影片追技術