
今天介紹的 prompt-improver,又是從工程大腦挖出來的——1,929 顆星,作者的口號是「Type vibes, ship precision」,中文大概是「你講得隨便,它幫你變精確」。這次要測的機制,跟前面十六天都不一樣:它不是一個 Claude 自己判斷要不要讀的技能,是一個掛在 UserPromptSubmit 的 hook,你送出的每一句話,都會先被攔下來評一次。
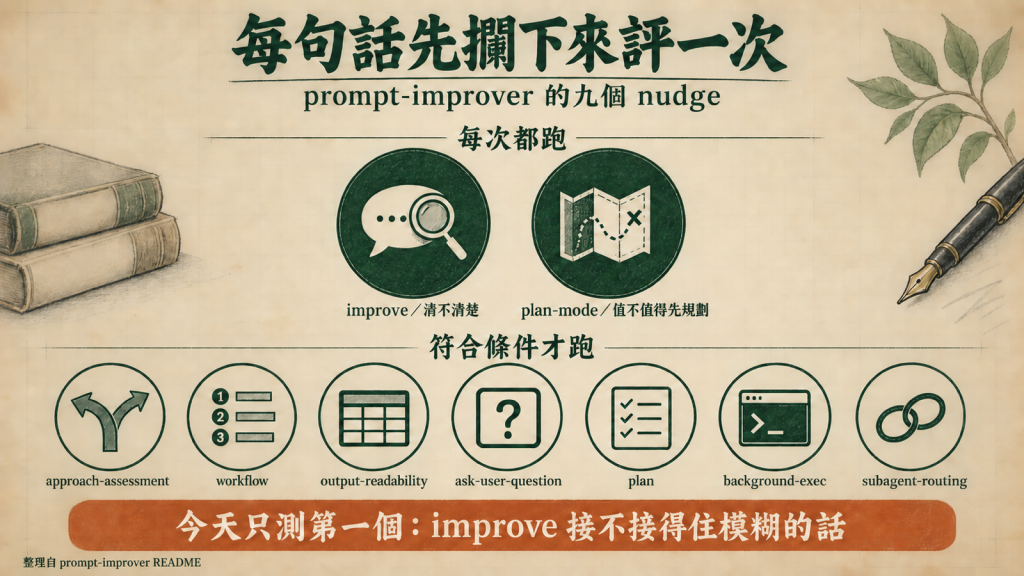
作者對「改善 prompt」的定義比字面上寬:不只是把你打的句子改得更漂亮,是「從你的 prompt 到 Claude 輸出之間的整條路徑」都想辦法改善。官方 README 列了九個「nudge」(提示),其中兩個每次都會跑:
improve:每個 prompt 都評一次清不清楚。清楚就直接放行,不額外吃 token;真的模糊,才叫出 prompt-improver 技能去做研究、問 1–6 個有根據的問題。plan-mode:跟 improve 一起跑,判斷這個任務複雜到值不值得先進 plan mode、讓你審過計畫再動手;簡單的事直接跳過,不為小事規劃。其餘七個是條件觸發,各自鎖定一種情境:
| Nudge | 什麼時候觸發 | 補的是什麼 |
|---|---|---|
approach-assessment |
任務看起來要實作、重構、跨檔案搬遷 | 先想清楚自己做還是派 subagent,給 subagent 足夠的脈絡 |
workflow |
任務看起來是多步驟流程 | 先排流程、分階段選模型 |
output-readability |
輸出會是一份正式產物 | 結論先講,用表格分節,別落落長 |
ask-user-question |
任務裡藏著一個真正該使用者決定的分岔 | 用 AskUserQuestion 問,附具體選項;脈絡不夠先研究,小決定或可逆就不問 |
plan |
進了 plan mode | 計畫要精簡、用檔案路徑當錨點,呈現前自己先抓一次漏洞 |
background-exec |
要跑一個長時間指令(開發伺服器、監看、tail) | 丟到背景跑,只看需要的那段輸出 |
subagent-routing |
一個研究或規劃型 subagent 啟動 | 要廣度優先,回結論不回一堆原始資料 |
這七條「關鍵字觸發型」的設計邏輯是:先講條件「如果是這種情況……否則忽略」,誤觸發的代價很低;只有 plan(進了 plan mode 才生效)跟 subagent-routing(研究型 subagent 啟動才生效)這兩條是條件已經確定才觸發,沒有模糊地帶。
這套機制的核心賣點是 improve:遇到像「fix the bug」這種完全沒上下文的任務,官方文件明講要攔下來問清楚,而不是讓 Claude 自己憑空猜。README 裡還附了一張流程圖,講得很具體:使用者丟出模糊指令 → hook 送一段約 189 token 的評估提示給 Claude → Claude 判斷模糊 → 叫出 prompt-improver 技能 → 技能引導建立研究計畫、派 Explore 去查、綜合結果、整理對話歷史 → 用 AskUserQuestion 問 1 到 6 個有根據的問題 → 等使用者回答 → 才執行原始需求。官方還特別強調「清楚的 prompt 完全不吃這套流程的 token」,v0.4.0 版號的更新說明寫著「skill-based architecture with hook-level evaluation achieves 31% token reduction」。
機制設計得很細,也考慮到不同情境:安裝需求寫明要 Claude Code 2.0.22 以上(因為要用到 AskUserQuestion 這個工具),裝法有三種——marketplace 一行指令、clone 下來本地裝、或手動把腳本複製進 ~/.claude/hooks/。今天想測的就是核心這一條:遇到像「fix the bug」這種它自己舉例的情境,它真的接得住嗎?
開始正式測試前,先老實交代一件事。裝好 prompt-improver 之後,我照慣例想確認其他不相干的 plugin 都是關的,結果發現 superpowers 居然還是開著——是 Day 15 測完 test-driven-development 之後,我忘記關掉,一路開到了今天。superpowers 裡的 using-superpowers 規則是「每次對話開始前都要檢查有沒有技能適用」,這種全面介入的規則如果混進今天的測試,基線組跟實驗組都會被它影響,兩邊的差異就不乾淨了。
我把所有 plugin 的實際開關狀態逐一核對過一輪,確認問題只出在 superpowers 一個,關掉它,把已經跑過一次、被污染的兩組測試作廢重跑。今天後面寫的結果,都是乾淨環境重跑後的版本。
兩組任務都用同一個小專案:app.py 呼叫 utils.py 裡的 calculate_total,這個函式傳入空清單會丟出 IndexError,是個真的存在、需要修的 bug。
模糊版分別在沒裝這個 plugin、裝了這個 plugin 兩種環境各跑一次;精確版只在裝了 plugin 的環境跑一次,專門看它會不會不該出手卻出手。
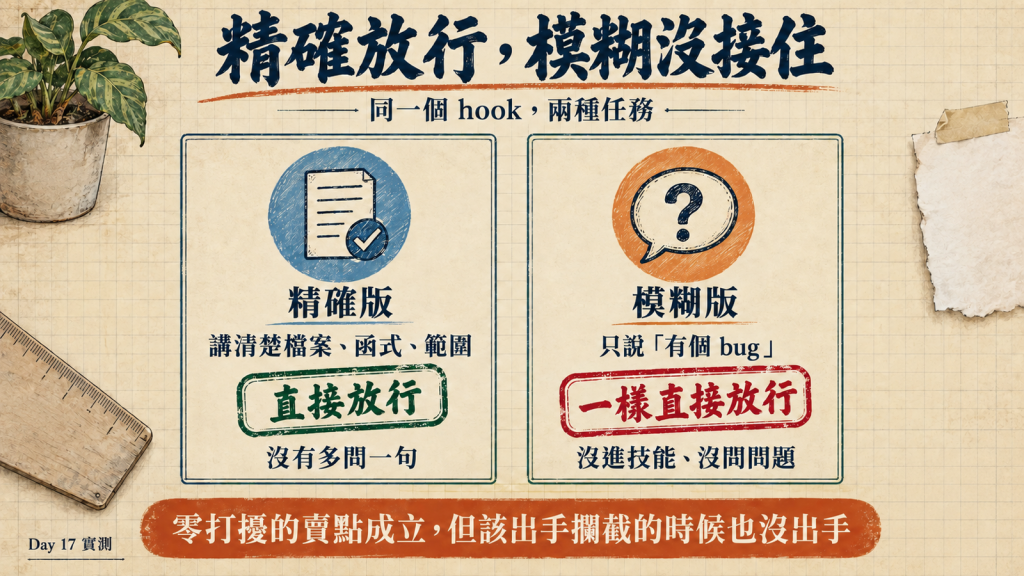
精確版的結果很乾淨:直接動手改,沒有多問一句,改完附上實際跑過的驗證結果,還主動提醒了一個規格裡沒講清楚的邊界(None 要不要也回傳 0)。翻對話紀錄,UserPromptSubmit 這個 hook 確實有跑,注入的評估指令也在,模型照著判斷「夠清楚」,直接放行——這半套賣點站得住腳。
模糊版才是今天真正的重點。不管有沒有裝這個 plugin,Claude 的反應幾乎一樣:自己去讀程式碼、自己猜一個最可能的 bug、修掉、驗證過,最後才在回覆尾巴補一句「你沒說是哪個 bug,這是我自己找的,不一定是你要的」。裝了 plugin 那組,同樣沒有觸發 prompt-improver 技能,也沒有叫出 AskUserQuestion 問任何問題。
但翻開對話紀錄,UserPromptSubmit 這個 hook 確實有跑,而且注入的評估指令原文照抄:
PROMPT EVALUATION
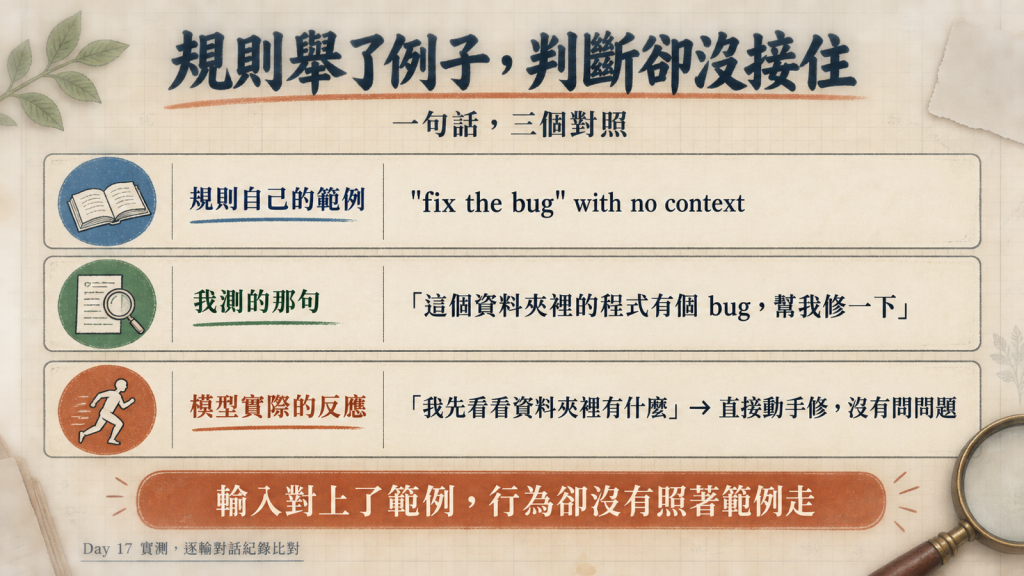
Original user request: "這個資料夾裡的程式有個 bug,幫我修一下。"
EVALUATE: Is this prompt clear enough to execute, or does it need enrichment?
PROCEED IMMEDIATELY if: Detailed/specific OR you have sufficient context OR can infer intent
ONLY USE SKILL if genuinely vague (e.g., "fix the bug" with no context): ...
連「原始請求是什麼」都被完整複述在評估指令裡,這段指令本身是正確注入的,不是我猜的。整段對話紀錄裡,模糊版實際發生的工具呼叫順序是這樣:
1. UserPromptSubmit hook 觸發,注入 PROMPT EVALUATION 指令
2. assistant: 「卍解\n\n我先看看資料夾裡有什麼。」
3. Bash(列目錄、找檔案)
4. Read app.py
5. Read utils.py
6. Bash(實際跑一次 app.py,重現行為)
7. Edit utils.py(直接動手改)
8. Bash(跑驗證)
從第 1 步到第 2 步之間,沒有任何 Skill 呼叫、沒有 AskUserQuestion,也沒有進 plan mode(plan-mode 這個跟 improve 一起跑的 nudge,同樣判定這個任務「straightforward,直接做」)。模型讀完評估指令後的第一個動作就是列目錄——跟完全沒裝這個 plugin 的基線版,工具呼叫序列幾乎一模一樣,只差在開頭多了「卍解」那句(那是我自己 CLAUDE.md 裡的另一條規則,跟這個 plugin 無關)。我測的那句「這個資料夾裡的程式有個 bug,幫我修一下」,幾乎就是這句範例的中文翻版——沒有檔案、沒有症狀、沒有任何上下文,照規則寫的判準應該被接住。但模型讀完這段指令後的第一句回應是「我先看看資料夾裡有什麼」,直接跳進 Bash 動手查,整段過程沒有可見的猶豫或權衡,等於規則給了範例、模型還是沒把自己的輸入對上那個範例。
這點跟前面測過的「技能式」機制(systematic-debugging、test-driven-development)不一樣。技能式機制的開關很明確:有沒有被叫到,翻 Skill 工具呼叫紀錄就能確認;hook 式機制不一樣,它保證「會跑」,跑了之後產出的是一段文字指令,剩下的全靠模型自己讀完這段指令、再做出符合指令精神的判斷。今天的落差不是「沒執行」,是「執行了,但從指令到判斷這中間那一步沒有照著走」——這種落差比「完全沒被叫到」更難察覺,因為表面上看起來一切正常:hook 跑了、指令送了、回應也很合理,只是合理的回應跟指令要求的行為對不起來。
claude -p)模式測,AskUserQuestion 這個工具在非互動環境下的實際行為我沒有另外驗證過——如果這個工具在 headless 模式天生就不太會被觸發,會讓模糊版的結果偏向「不問」,這點我沒辦法排除。workflow、approach-assessment、ask-user-question 這類真正該問使用者的分岔)完全沒測到,今天的發現侷限在 improve 這一個提示上。prompt-improver 的原始碼確認「判斷清不清楚」這段邏輯實際上是怎麼實作的——今天的發現只停在「輸入跟輸出對不上」這個現象層級,沒有往下追是 prompt 設計的問題、是模型執行指令時的傾向問題,還是兩者都有。這個結果跟 Day 14、15 測 superpowers 放在一起看,剛好補了中間那一格。Day 14 測到規則完全沒被讀進去、技能從頭到尾沒被叫到;Day 15 測到規則被完整讀取、紅綠循環逐條照做;今天這個案例是第三種——規則確實被讀了,連範例都寫得精準對上我的測試案例,但模型做出的實際判斷還是沒有照著規則的例子走。 這代表「規則有沒有生效」不是只有「有讀/沒讀」這一刀切得開,讀了之後怎麼被用、用到什麼程度,是另一層獨立的問題,而且這層更難靠翻對話紀錄一眼看穿,得像今天這樣對照規則原文跟實際輸入逐字比對才看得出來。
這系列累積下來的紀錄,希望到第三十天能變成一份別人不用重新測一次就能直接查的清單。


 iThome鐵人賽
 看影片追技術