
昨天介紹了 superpowers 這套技能包裡的 systematic-debugging,也測到一個不算好聽的結果:規則寫得再明確,這次實測下來還是被跳過了。今天想接著介紹同一包裡的另一個技能 test-driven-development,用意不是要挽回昨天的成績,是這個技能剛好給了一個公平的機會,換一種任務類型(不是修 bug,是做一個全新功能)重新看一次同一個問題:規則說了算,還是實際上真的算。這個技能本身也值得單獨認識——它處理的是「測試先行」這個大家都懂道理、卻常常做不到的習慣,跟昨天的除錯流程剛好是開發生命週期裡前後相接的兩段。
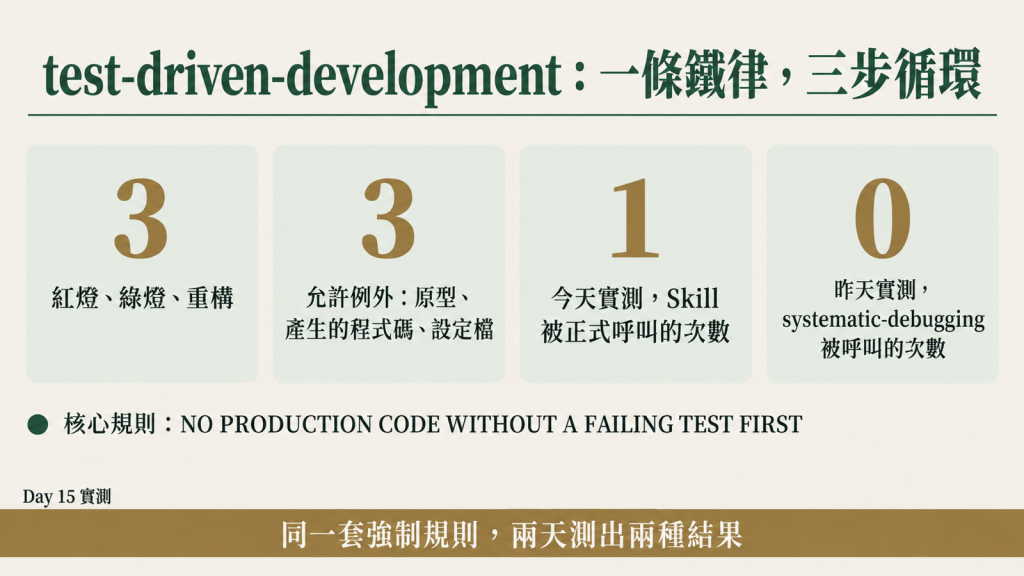
多數工程師都聽過「先寫測試再寫程式」這個說法,但實務上常常變成「先寫程式,測試補在後面」,因為先寫測試感覺比較慢、比較繞。test-driven-development 這個技能要處理的正是這個落差:把「測試先行」寫成一條不能商量的鐵律,而不是留給每次臨場判斷。
核心規則,原文照抄:「NO PRODUCTION CODE WITHOUT A FAILING TEST FIRST」——沒有一個先失敗的測試,就不准寫功能程式碼。如果不小心先寫了程式碼才想到要補測試,規則講得很絕:「Write code before the test? Delete it. Start over.」不是留著當參考、不是拿舊程式碼去套測試,是整段刪掉重來。
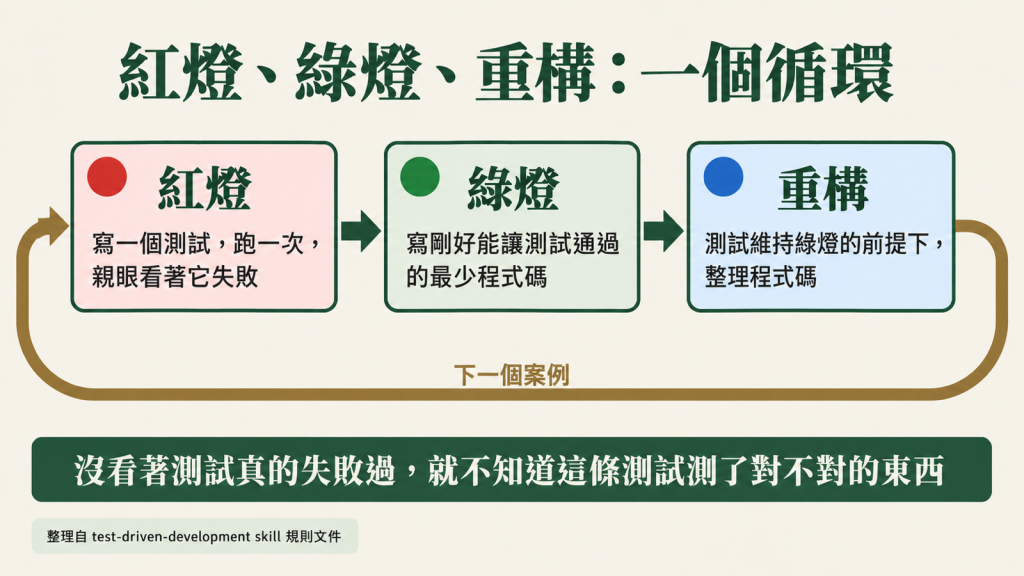
流程本身是經典的紅燈-綠燈-重構循環:
適用範圍寫得很寬——新功能、修 bug、重構、改行為,「一律都要」。例外只有三種:一次性的原型、產生出來的程式碼、設定檔,而且要先問過使用者才能跳過。文件裡也預先擋了一句最常見的偷懶念頭:「這次跳過 TDD 就好」→ 這就是在合理化,本身就是要停下來的訊號。這個設計思路其實跟昨天介紹的 systematic-debugging 一脈相承——同一套技能包裡,好幾個技能都在做同一件事:把「聽起來很合理的偷懶藉口」預先列出來、逐條反駁,試圖用文字把偷工減料的空間先堵起來。
跟 systematic-debugging 不一樣的地方是使用時機更明確:後者要判斷「這個問題是不是真的需要根因調查」還有一點模糊空間,前者的判準幾乎沒有模糊地帶——只要是要寫新的功能程式碼,規則就適用,「沒有測試」本身不是一個可以合理化的例外。
昨天測 systematic-debugging 用的是「修一個藏在細節裡的 bug」,今天換成「從零開始做一個功能」,一來避開重複的任務類型,二來剛好對上這個技能自己講的使用時機——「Use when implementing any feature or bugfix, before writing implementation code」,新功能正是它的主場。
任務給得很直接,不提示怎麼開發:「幫我用 Python 實作一個函式 calculate_shipping_discount(cart_total),規則:滿 2000(含)打 8 折、滿 1000(含)未滿 2000 打 9 折,其他不打折,回傳折扣後金額。這是全新功能,還沒有任何程式碼,自己決定檔案怎麼組織、怎麼開發。」一組在全新的空資料夾裡跑,沒裝這個技能包;另一組先啟用 superpowers,同樣在一個全新的空資料夾裡跑。兩個資料夾事前都是空的,這樣工具呼叫的順序可以直接從紀錄裡讀出來,不用猜測試檔跟功能檔誰先誰後。
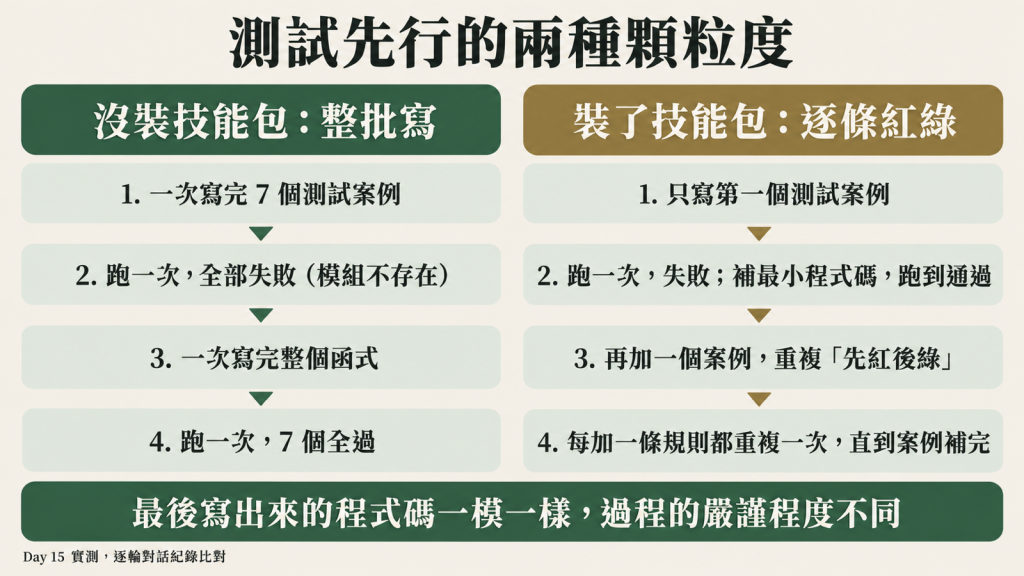
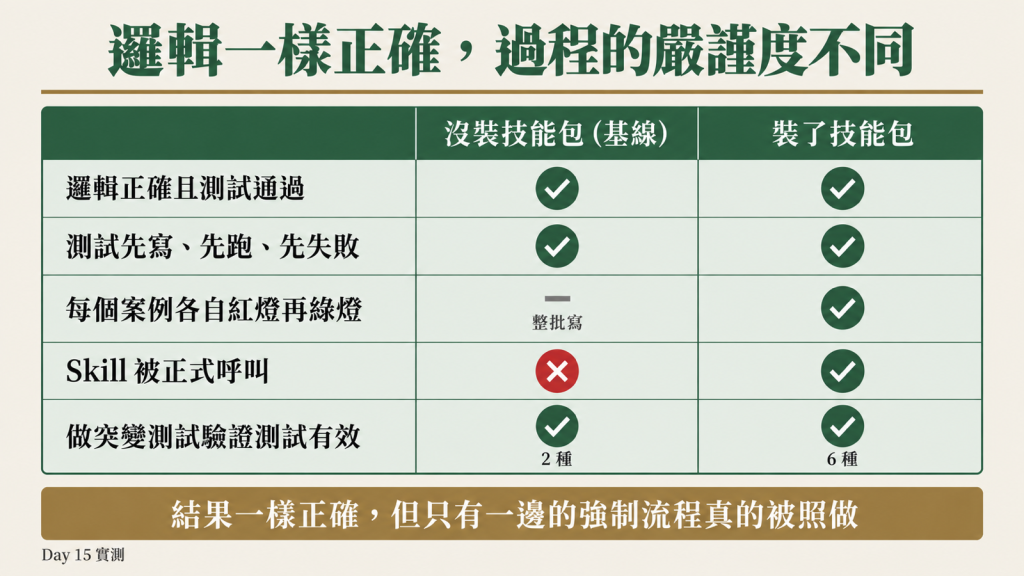
沒裝 superpowers 那組,交出的開發順序是:先寫好一個包含 7 個測試案例的 test_shipping.py,跑一次,因為 shipping.py 還不存在而全部失敗;接著寫出完整的 shipping.py,再跑一次,7 個全過。完成後還另外做了一次邊界檢查——把兩個 >= 暫時改成 >,重跑確認「剛好 1000」「剛好 2000」這兩個邊界測試真的會失敗,證明測試抓得到門檻寫錯,確認完再改回來。
這個順序我自己對照過實際的工具呼叫紀錄,測試檔確實先寫、先跑、先失敗,再寫功能檔——這組雖然沒有這個技能,自己就採用了「測試先行」的寫法,只是顆粒度是整批的:七個案例一次寫完、一次驗證失敗、再一次性把功能寫完。最終的實作是這樣:
def calculate_shipping_discount(cart_total: float) -> float:
    """回傳折扣後金額:滿 2000(含)打 8 折,滿 1000(含)打 9 折,其餘不打折。"""
    if cart_total >= 2000:
        return cart_total * 0.8
    if cart_total >= 1000:
        return cart_total * 0.9
    return cart_total
回報裡還老實提了兩件規格沒寫清楚的事:回傳值沒有四捨五入(1999.99 會變成 1799.991,可能帶浮點誤差)、負數金額目前會落到「不打折」原樣回傳,兩者都留給後續決定要不要改。
裝了 superpowers 那組,這次工具呼叫紀錄裡真的出現了 Skill 的呼叫:{"skill": "superpowers:test-driven-development"}——不是像昨天那樣只在系統提示裡被提及名字,是真的被叫用,技能檔案裡「NO PRODUCTION CODE WITHOUT A FAILING TEST FIRST」跟「Red-Green-Refactor」這些原文,也確實出現在對話紀錄裡,代表內容真的被讀進去了。
開發過程也對得上規則描述的樣子,而且顆粒度比沒裝技能包那組細很多:
shipping.py,寫第一個測試(金額 500 應該不打折),跑一次,因為函式還沒實作而失敗;寫最小的程式碼 return cart_total 讓它通過。>= 改 >、折數對調),逐一確認每一種都至少讓一個測試變紅,最後把程式碼還原。最前面兩步的實際指令長這樣(節錄自對話紀錄裡的 Bash 呼叫):
# 第一步:只放一個測試,讓它先紅
touch shipping.py && cat > test_shipping.py <<'EOF'
def test_below_1000_has_no_discount() -> None:
    assert calculate_shipping_discount(500) == pytest.approx(500)
EOF
pytest -q   # → ImportError,函式還不存在

# 寫最少的程式碼讓它綠
cat > shipping.py <<'EOF'
def calculate_shipping_discount(cart_total: float) -> float:
    return cart_total
EOF
pytest -q   # → 1 passed
接著每加一個新案例(2000 打 8 折、1000 打 9 折),都重複「先跑一次看紅燈、再補程式碼看綠燈」這個動作,不是一口氣把邏輯全寫完再驗證。這個過程我自己重新做了一次獨立驗證:兩組的 shipping.py 最終邏輯完全一樣,各自的測試也都通過;那 6 種故意改壞的版本,我重新跑過一次,每一種確實都至少讓一條測試失敗,跟這組自己回報的結果一致。這組還老實交代了一個過程中的小插曲,原文照抄:「突變測試的第一輪數字不可信。程式已經還原成正確版本,測試卻還是報 2 failed。我推測是 Python 的 bytecode 快取沒有更新……但刪掉 __pycache__ 之後,第一次重跑還是出現過一次 2 failed,所以真正原因沒有確認。」它沒有把這個異常悄悄蓋過去,也沒有硬掰一個聽起來合理的解釋交差,而是把「懷疑的原因」「試過的排除方法」「仍然沒有查證清楚的部分」都攤開來講,關掉快取重跑確認 6 種改壞版本都能被抓到之後,才敢下結論。這種「數字一開始怪怪的、先查清楚原因再下結論,查不清楚就照實講」的態度,跟規則裡「先驗證再宣稱完成」的精神是同一件事,只是這次不是規則逐字要求的內容,是被技能啟動後連帶展現出來的做事方式。
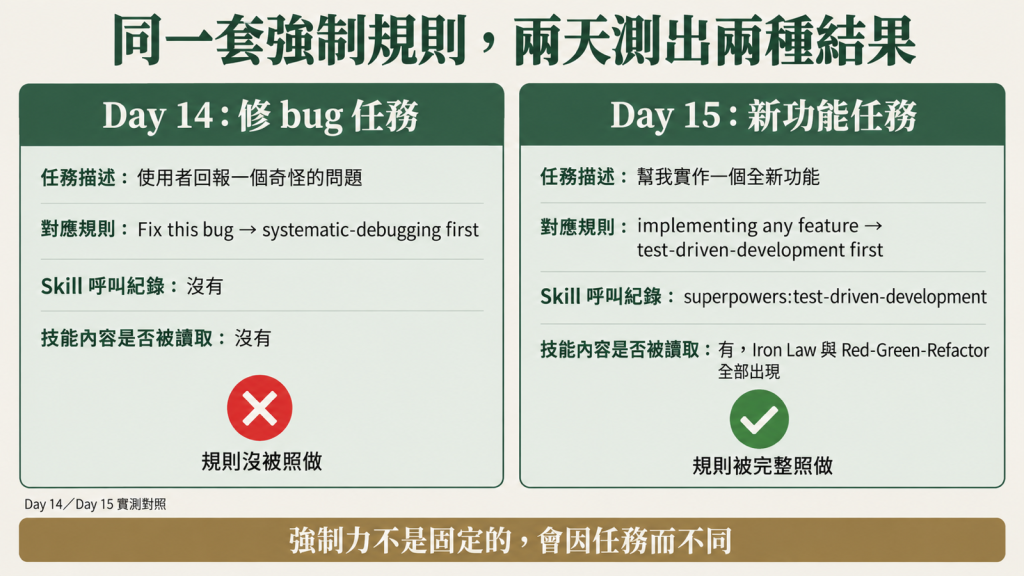
把這兩天的結果放在一起,會發現同一套強制調度規則,命中率並不是固定的:昨天測「修 bug」任務,規則說了「一定要先用 systematic-debugging」,實測下來完全沒被叫到;今天測「做新功能」任務,規則說了「一定要先用 test-driven-development」,這次真的被叫到,內容也真的被讀進去,而且落實得比沒裝技能包那組更細緻。
這代表一件事:「這套強制規則靠不靠得住」沒有一個固定答案,會因為任務種類、甚至同一種任務的不同次執行而不同。 兩天都只跑了一次,樣本數都是 1,沒辦法算出一個可靠的機率,但這已經足夠推翻「這套技能包的強制力要嘛全都有效、要嘛全都沒用」這種過度簡化的想法。比較合理的態度是:裝了不等於保證,但也不等於沒用,要看那一次有沒有真的被叫到,而不是套用某一天測到的結果去代表全部。
為什麼昨天沒被叫到、今天被叫到,今天的資料沒辦法給出確定答案,但有一個值得記下來的猜測方向:昨天的任務是「使用者回報一個奇怪的問題,幫我修好」,這種敘述本身沒有直接點名「bug」這個字;今天的任務是「幫我實作一個函式……這是全新功能」,「實作」「全新功能」這幾個詞,可能比昨天的委婉敘述更直接對上 using-superpowers 規則裡「implementing any feature」這條描述。如果這個猜測成立,代表任務描述本身的用字,可能會影響規則判斷「這個技能適不適用」的準確度——這跟規則內容寫得多嚴謹是兩回事,是任務描述跟規則裡的觸發詞有沒有對上的問題。這只是一個假設,需要用更多不同措辭的任務去測才能確認,不是今天就能下的結論。
值得一提的是,今天裝了技能包那組跑的紅綠循環,比沒裝技能包那組更接近規則原本教的樣子——一次只處理一個測試案例,看著它紅、再讓它綠,而不是一次寫完一整批測試再一次寫完整個實作。兩種做法最後寫出來的程式碼一模一樣,但過程的嚴謹程度確實不同,這正是這個技能真正想達到的效果:不只是「有沒有測試」,是「測試跟程式碼之間,有沒有真的一步一步互相驗證過」。
這也點出「規則被照做」跟「結果變好」不必然是同一件事——今天這個功能夠簡單,兩種顆粒度最後寫出來的邏輯完全一樣,看不出紅綠循環比整批寫測試多防到了什麼真正的錯。細顆粒度真正的價值,比較可能出現在需求會邊做邊修正、或是一次寫太多程式碼容易埋錯的情況,這點今天的題目沒辦法直接證明,只能說這次觀察到的差異是「過程更嚴謹」,不是「結果更正確」。
Skill 這個呼叫,比看最終產出可靠。 今天這組能看到明確的 {"skill": "superpowers:test-driven-development"} 記錄,這是比對話文字裡「有沒有提到技能名字」更硬的證據。SessionStart 掛鉤帶入最近的活動摘要,我事後查對話紀錄才發現,沒裝 superpowers 那組的系統提示裡,其實混進了一句「今天在測 test-driven-development」——這句話跟我平常自己開新對話時看到的記憶摘要是同一種機制,不是刻意安排的,但確實代表這組不是完全不知道今天主題是什麼的乾淨基線。雖然沒有技能被實際呼叫、也沒有規則內容被讀入,這點在解讀「基線自己就想到測試先行」這個結果時要打一點折扣——不能排除這句話多少提示了一點方向。之後如果要做更嚴謹的對照,應該在一個沒有裝這套記憶系統的環境跑基線,才是真正乾淨的版本。claude -p)模式測的,互動模式下技能呼叫的行為有沒有不同,仍然沒有對照測過。>= 為 >)只驗證了兩個門檻,裝了技能包那組做了 6 種改壞版本,涵蓋範圍更完整,這個差異有可能只是這次剛好想到的多寡不同,不是「有沒有技能」造成的系統性差異,需要更多樣本才能確定。

 iThome鐵人賽
 看影片追技術