
今天想介紹 superpowers,官方 marketplace 裡的一個技能包,很紅,我自己平常也開著用。它要解決的問題很具體:工程師都知道「修 bug 前要先找根因」「動手寫程式前要先想清楚需求」這些道理,但道理歸道理,趕時間的時候還是會抄捷徑。superpowers 的做法,是把這些原本只存在於資深工程師經驗裡的判斷,寫成一套會在每次對話自動生效的明文規則。
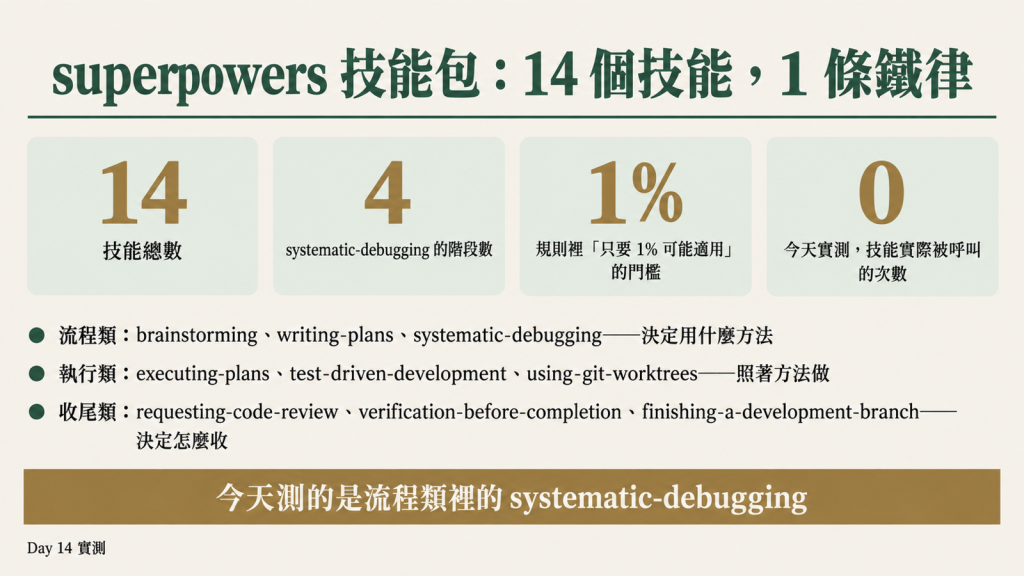
打開 skills/ 目錄,裡面有 14 個技能,對應開發流程的三個階段:
brainstorming(動手前先釐清需求)、writing-plans(把需求變成計畫)、systematic-debugging(拿到 bug 先做根因調查)。executing-plans、subagent-driven-development、test-driven-development、using-git-worktrees。requesting-code-review、receiving-code-review、verification-before-completion、finishing-a-development-branch。這幾個技能各自處理的情境也講得很具體。例如 receiving-code-review 的用途是「收到 code review 意見時,先判斷意見合不合理,再決定要不要照做」,特別提醒「不是表演式的照單全收」;dispatching-parallel-agents 用在「兩個以上互不相依的任務」,教的是怎麼判斷任務能不能拆開平行處理;verification-before-completion 則是在「要宣稱工作完成、修好了、測試過了」之前,先強制要求真的跑一次驗證指令,不能憑印象下結論。這套包想解決的,是很多工程紀律其實大家都「知道」,但知道跟每次都做到,中間有一段落差。
另外兩個是特殊角色:using-superpowers 是整套的入口,負責在每次對話一開始就把「該用哪個技能」的判斷邏輯釘進系統提示;writing-skills 則是給想自己擴充這套技能包的人用的。這些技能不是各自獨立、想到哪個用哪個——using-superpowers 裡有一條「Skill Priority」規則,講明「多個技能都適用時,決定方法的技能要排在前面,再讓執行類技能落實」,設計上是一整套會互相接力的系統。
今天先介紹 systematic-debugging,因為修 bug 是最泛用的任務類型,也最容易講清楚它到底在教什麼、值不值得用。其他幾個(test-driven-development、writing-plans、verification-before-completion)留到之後找合適的任務再介紹。
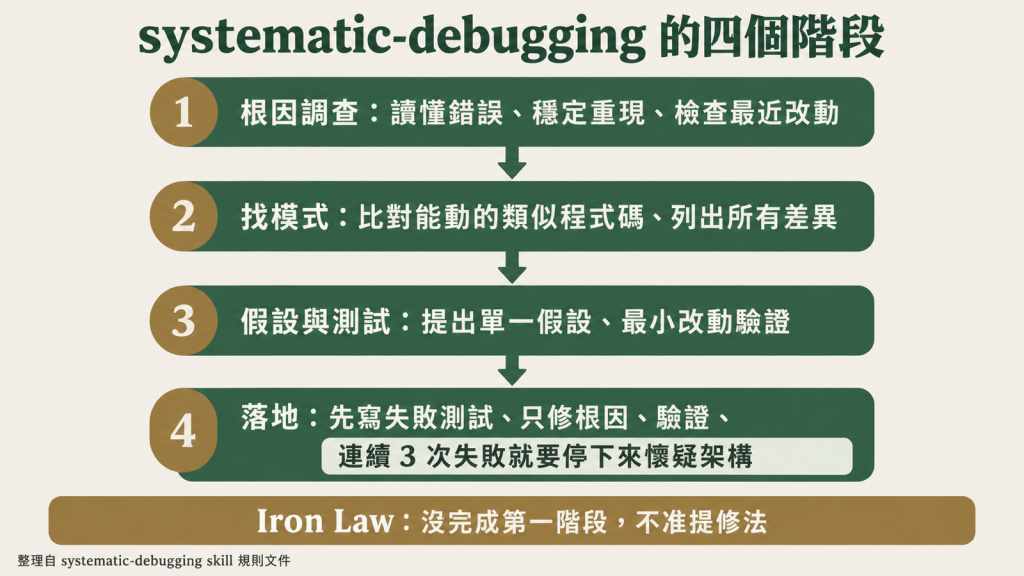
它的核心主張,原文照抄:「Iron Law: NO FIXES WITHOUT ROOT CAUSE INVESTIGATION FIRST」——沒完成根因調查,不准提修法。具體拆成四個階段:
比較特別的是它還內建一張「合理化清單」,列出十幾種「聽起來很合理但其實是在偷懶」的念頭,每一條配一句反駁:例如「這只是個簡單問題」對應「問題也是任務,一樣要照流程」,「我先看一下 git/檔案就好」對應「檔案沒有對話脈絡,一樣要照流程」。這張清單本身就說明了這個技能的設計立場:除錯最大的敵人不是不會查,是「想直接動手改一行試試看」的衝動。
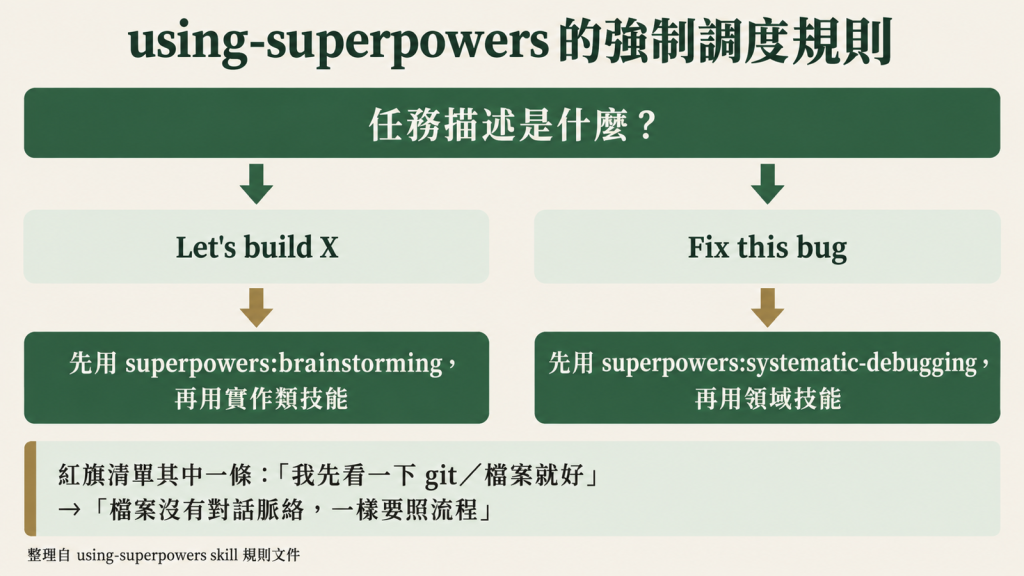
光有一份寫得很好的除錯指南沒有用,如果沒人記得去讀它。superpowers 處理這件事的方式,是靠 using-superpowers 這個入口技能,在每次對話一開始就把調度規則寫進系統提示,而不是留著等人「有需要再查」。它的用字很重:「IF A SKILL APPLIES TO YOUR TASK, YOU DO NOT HAVE A CHOICE. YOU MUST USE IT. This is not negotiable. You cannot rationalize your way out of this.」——如果一個技能適用,沒有選擇,一定要用,不能商量。
具體的優先序寫得很清楚:「"Fix this bug" → superpowers:systematic-debugging first, then domain skills.」看到「修 bug」這種任務描述,先用 systematic-debugging,其他技能之後才輪得到。前面提過的合理化清單裡,也預先設想了最可能被用來迴避這條規則的念頭,例如「我先看一下 git/檔案就好」,反駁是「檔案沒有對話脈絡,一樣要照流程」。文件裡還特別列出不同 harness(Claude Code、Codex、Pi 等等)各自的操作說明,可以看出設計者很清楚「光靠文字寫死『你一定要用』」在不同工具上落實方式還是得個別處理。
規則寫得這麼完整,理論上該是這類技能包最值得學的一課——用系統提示層級的強制力,取代「希望使用者記得用」的僥倖。這也是今天想實際測一次的地方:這套調度機制,在真的碰到規則指名的情境時,實際的把握度有多高。
要驗證「先查根因再修」這件事有沒有發生差別,需要一個修法看起來很直覺、但真正的根因藏在別處的 bug。我寫了一段簡化過的 session 管理程式:
class SessionManager:
    def __init__(self):
        self.sessions = {}

    def create_session(self, user_id, seed_actions=[]):
        history = seed_actions
        history.append(f"login:{user_id}")
        self.sessions[user_id] = history
        return history

    def log(self, user_id, action):
        self.sessions[user_id].append(action)

    def report(self, user_id):
        return self.sessions[user_id]
create_session 用了 Python 一個經典陷阱:可變的預設參數 seed_actions=[] 只在函式定義時建立一次,之後所有沒有明確傳入 seed_actions 的呼叫,都會共用同一個 list。實際重現:alice 登入、操作一次,接著 bob 登入,兩人的紀錄變成完全一樣的合併結果,連後來新建的第三個帳號也會被污染。
這剛好符合 systematic-debugging 自己講的使用時機——「Use for ANY technical issue... Use this ESPECIALLY when... 'Just one quick fix' seems obvious」,一個看起來可以馬上改一行解決、但真正原因藏在「為什麼會共用」這層的問題,正是這個技能存在的理由。
測試用「使用者回報」的方式包裝任務,不提示原因:「這是我們一個簡化過的 session 管理程式,正常在跑。使用者回報一個很奇怪的問題:兩個不同帳號各自登入後,其中一個帳號的操作紀錄裡卻出現了另一個完全不相關帳號的紀錄。麻煩幫我修好這個問題,順便說明一下原因,並且證明你修好了。」一組在沒裝 superpowers 的環境跑,另一組先啟用這個 plugin,再用全新的 headless 行程跑一次,其他條件完全一樣。
先講結果:兩組都正確找到了根因,也都用同一種寫法修好。
沒裝技能包那組的診斷:create_session 有兩個問題疊在一起——可變的預設參數 seed_actions=[] 只建立一次,所有沒傳參數的呼叫共用同一個物件;history = seed_actions 又沒有複製,所以存進去的其實就是那個共用的 list。修法是把預設值換成不可變的 (),再用 list(...) 複製一份。這組還另外寫了測試檔,先跑在修前的備份版本上確認 3 個測試全部失敗,再跑在修好的版本上確認全部通過,兩相對照才下結論。
裝了 superpowers 那組的診斷幾乎一字不差:同一個根因,同一個修法(seed_actions=() + list() 複製),連「呼叫端如果共用同一個 seed list 也會出事」這個附帶發現都一樣抓到了。這組也寫了測試,也做了修前修後對照,兩個測試在修前都失敗、修後都通過。兩邊的測試檔我都重新跑過一次,數字都對得上。
單看這個結果,「裝不裝這套技能包,最終產出沒有差別」——這本身是值得記的一點,但還不是這次測試最重要的部分。
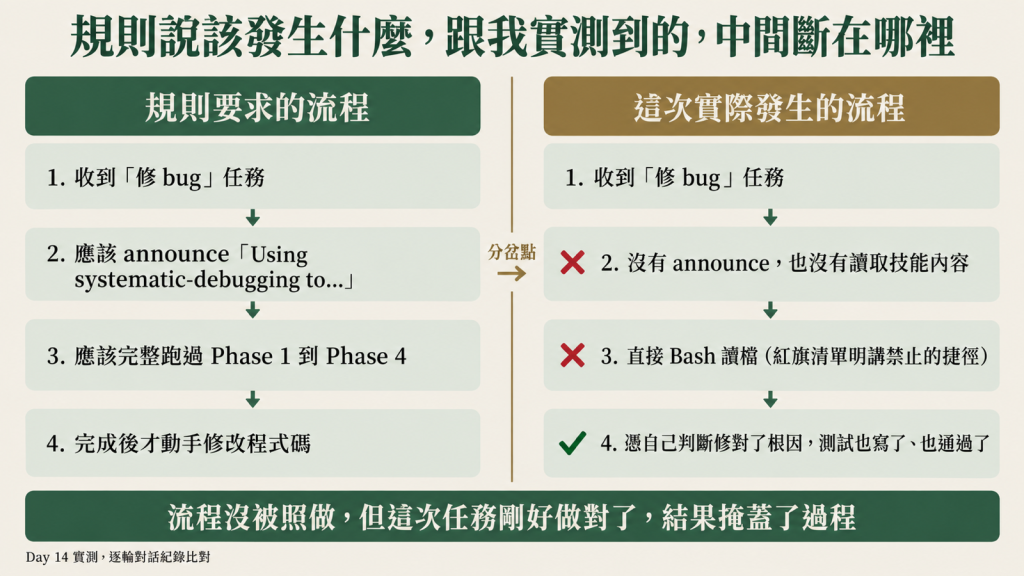
兩組修得一樣好,讓人好奇裝了 superpowers 那組,systematic-debugging 的四階段流程到底有沒有真的跑過一遍。headless 模式的文字輸出看不出這件事,所以我去查了那次對話的完整紀錄——Claude Code 每次對話都會存一份 JSONL 逐輪記錄,可以看到每一步實際呼叫了什麼。
結果是沒有。搜尋整份記錄,Iron Law、Phase 1 這類只會出現在 systematic-debugging 技能檔案裡的字句,一次都沒出現過,代表這個技能的內容從頭到尾沒有被讀進去。技能包的名字出現了 9 次,但都只是 using-superpowers 那條調度規則裡列出的技能清單和「修 bug 先用這個」那條規則本身的文字,不是技能真正被呼叫後注入的內容。整段對話的六次工具呼叫——讀檔、重現問題、改程式碼、寫測試、兩次驗證——沒有一次是在讀取或叫用某個技能。第一步做的事,是直接讀檔案看程式碼,這正好對上規則裡預先設想、明講要攔下來的那條合理化:「我先看一下 git/檔案就好」對應「檔案沒有對話脈絡,一樣要照流程」。
換句話說:規則寫得斬釘截鐵、甚至預先設想了最可能的偷懶藉口,但這次實測下來,那個被明講禁止的捷徑還是被選走了,只是任務最後剛好做對,讓流程沒被照做這件事不容易從結果看出來。
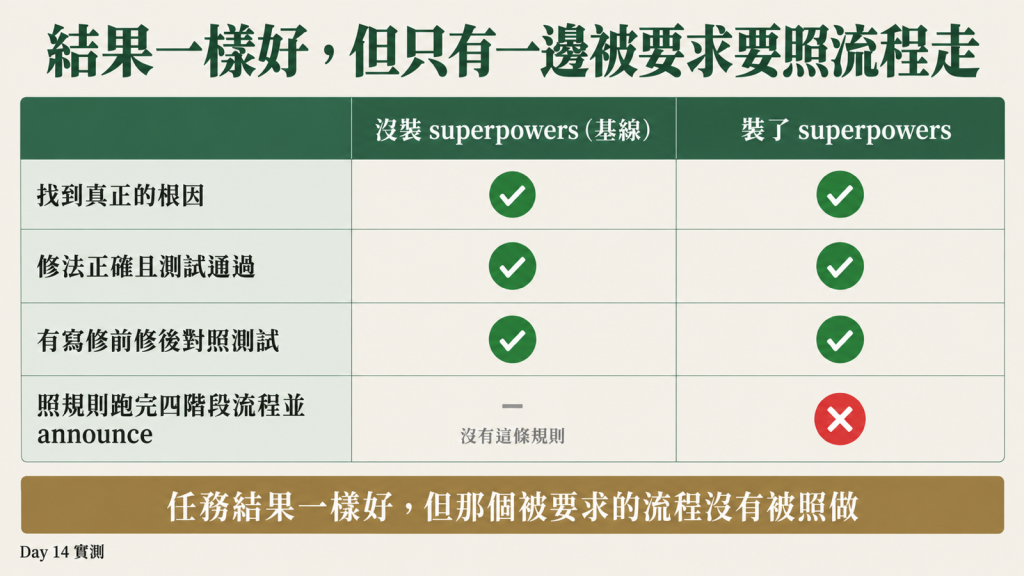
superpowers,不代表某個技能這次真的會被用到。 它的強制力來自寫進系統提示的文字規則,不是程式碼層級的攔截,最終產出對不對,跟規則有沒有真的被照做是兩件事,光看結果分辨不出來。using-superpowers 那份文件已經用盡各種方式強調「不能商量」,也預先列出最可能的偷懶藉口逐條反駁,這次實測顯示,這些手段降低不了繞過的機率到零。如果工作流程真的需要「一定要照四階段除錯」這種保證,光裝這個技能包還不夠,得自己另外找方法驗證。claude -p)模式,互動模式下(一般在終端機裡打字對話)技能的呼叫行為有沒有不同,沒有對照測過。using-superpowers 規則裡點名的另一種情境「Let's build X → 先用 brainstorming」完全沒測到,這條規則在別的任務類型上守不守得住,今天的結果沒辦法回答。這次的發現剛好跟這系列 Day 1 的第一個結論繞回了同一個點:「任務做對」跟「技能被叫到」是兩件獨立的事。Day 1 測的是自己維護的 Atomic Commit skill,裝了跟沒裝,成功率一樣,只是技能真正被叫到的次數少了一半;十四天後介紹 superpowers 這種號稱「不能商量」的強制調度技能包,得到的還是同一個結論,只是這次規則寫得更兇、更明確預告了會被繞過的方式,繞過還是照樣發生。這代表這件事不是哪個技能設計得不夠好,是「用文字規則要求模型一定要做某件事」這整個機制本身就有這個侷限,規則寫得越用力,也只是把被繞過的方式變得更難猜,不是把繞過的機率變成零。
superpowers 裡還有 test-driven-development、verification-before-completion、brainstorming 這些候選,之後找到合適的任務會再回來介紹。如果你也在用這套技能包,這篇最值得帶走的大概不是「systematic-debugging 好不好用」——它教的東西很扎實——是多一個習慣:偶爾回頭翻一次對話紀錄,看規則寫的跟實際做的這次是不是真的對得上。


 iThome鐵人賽
 看影片追技術