
上一篇我們先了解了:如果想把 Hermes Agent 慢慢打造為自己的 AI 工作分身,得要先讓它知道「你是誰」。
Hermes 裡的 USER.md,就是用來保存這類長期使用者背景的地方,Hermes Agent預設機制是會將他在對話中慢慢所理解到的你,都保存記在這個檔案中。
不過,難道我要等 Hermes 跟我聊上幾個星期、幾個月,才讓它慢慢拼湊出我是誰嗎?
可以是可以,但這有點太慢。
如果你一開始就是希望把 Hermes 當成長期工作分身,那更有效率的做法,是直接替它安排一次 onboarding。
不過我不建議直接打開 USER.md,然後對著空白檔案開始寫。
比較低摩擦力的作法是:
讓 Hermes 先訪談你,再把訪談結果蒸餾成 USER.md。
整個流程其實只有四個動作:
訪談 → 蒸餾 → 校正 → 驗證後保存
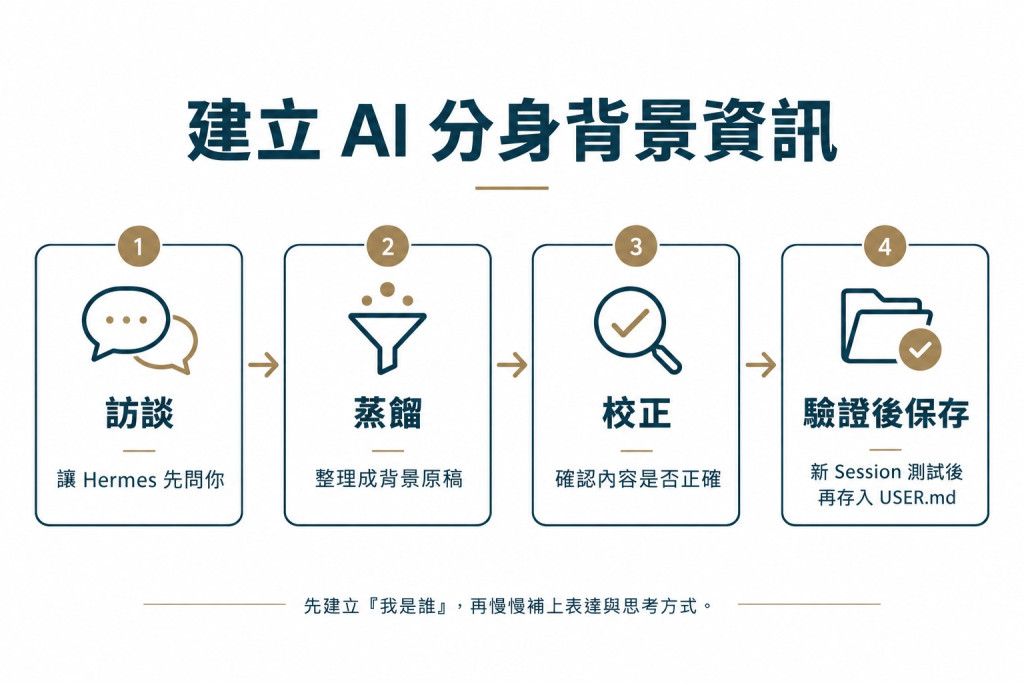
這篇就實際帶大家走一次這個流程。
如果現在叫你立刻寫一份 USER.md,要求你用 1,000 多個字描述所有 Hermes 未來應該知道的你的長期背景。
大部分人第一個反應大概都是:
蛤?我要怎麼開始寫?
最後很容易不小心寫成履歷落落長,或者想到什麼寫什麼,把亂七八糟只要跟自己有關的東西全部混在一起寫出來。
我自己覺得比較好的辦法,是反過來讓 Agent 當訪談者來幫你寫第一版,之後再來改。
你要做的只是回答問題,簡單吧?
Hermes 負責:
如此一來,這階段我們需要的就只是一套能快速把「使用者背景」問出來的 onboarding 訪談提示詞而已了。
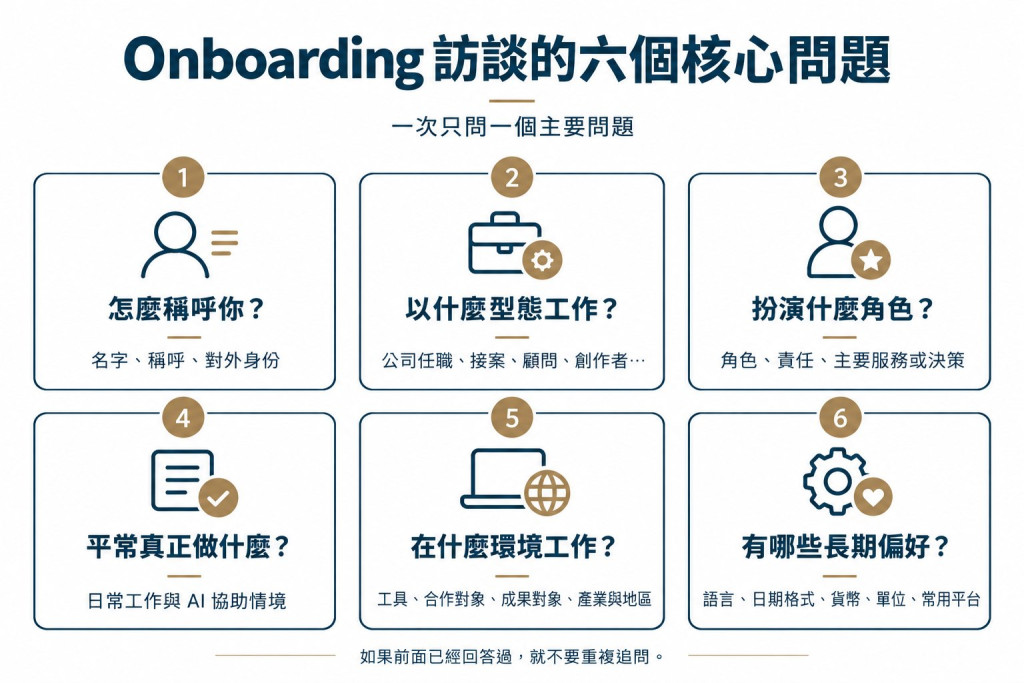
我一開始也曾經想過,把專業程度、工具、合作對象、工作成果對象、地區、產業等全部拆成十幾題。
但實際使用上很容易變成令人疲乏的身家調查,一旦 onboarding 讓人覺得像在填人事資料,通常問到一半你就不會想回答了。
最後我把核心問題壓成六個:
其中第二題「工作型態」很重要。
因為「你做什麼工作」和「你以什麼方式工作」其實是兩件事。
同樣是做行銷:
即使專業領域類似,他們面對的任務、客戶、決策方式與工作環境都可能完全不同。
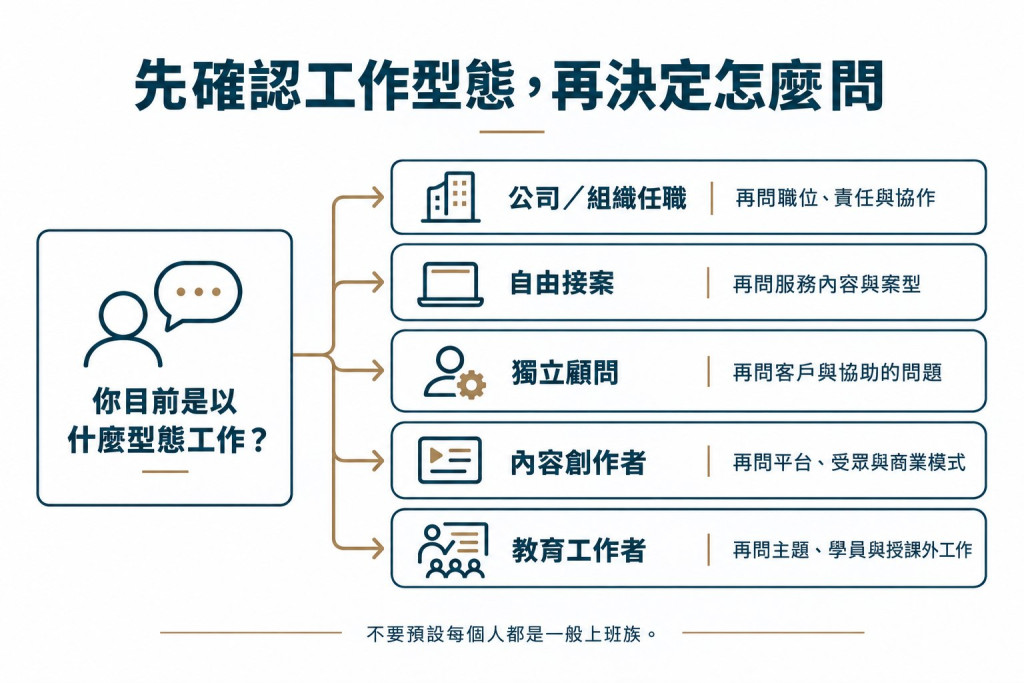
所以 onboarding 不應該一開始就問:
「你的職位是什麼?」
而應該先確認:
「你目前是以什麼型態工作?」
再依照答案改變後續問法。
如果是在公司工作,可以問職位與責任。
如果是自由接案者,應該問提供什麼服務、接什麼案子。
如果是顧問,則應該問協助哪些客戶解決哪些問題。
這樣問出來的 User Profile 才不會帶著「所有人都是公司上班族」的預設。
下面這段 Prompt 可以直接貼進你的 Hermes Agent 對話框中,並要求他執行。
這個提示詞目前只負責一件事情:
把使用者背景訪談完整,產生一份「使用者背景原稿」。(這個階段還不要急著寫入
USER.md。)
對了,這個提示詞會比較長,沒有耐心的讀者可以先略過跳掉此段提示詞,只要有了解到它的設計思路即可。
你的目的在協使用者建立第一個他的 AI 分身的背景資料。

目前這個階段的任務只有一個:
透過訪談,了解使用者是誰、如何被稱呼、以什麼型態工作、平常在做什麼,以及哪些長期背景會影響 AI 未來協助使用者工作的方式。

這個階段只蒐集與整理「使用者背景」。
不要在這個階段:
- 建立或修改 USER.md
- 寫入 Memory
- 分析使用者的寫作風格、語氣與表達方式
- 推論使用者的思考模式、決策方式
- 建立工作流程或行為規則

以上內容會在後續階段另外處理。

---

# 訪談原則

請透過對話逐步訪談使用者。

一次只問一個主要問題,等待使用者回答後,再進入下一題。

請遵守以下原則:

1. 如果使用者前面的回答已經包含後面某題需要的資訊,就不要重複詢問。
2. 如果使用者回答得很完整,可以直接整理資訊並進入下一個仍缺少的面向。
3. 如果某個答案太模糊,而且這個模糊點會明顯影響 AI 未來如何協助使用者,可以進行簡短追問。
4. 不要為了把所有欄位填滿而無限制追問,使用者的耐心有限。
5. 不要自行補充使用者沒有提供的背景。
6. 不要因為職稱、產業或工作型態,自行推論使用者的能力、個性、價值觀或工作內容。
7. 問題可以依照使用者的回答自然調整,不需要逐字照著題目念。

---

# 第一題:確認使用者的名字與稱呼方式

先了解使用者是誰,以及未來應該如何稱呼使用者。

詢問:
我應該怎麼稱呼你?你平常對外會使用什麼名字、稱呼或身份?如果工作上、公開場合或不同角色會使用不同稱呼,也可以一起告訴我。

可以了解:
- 自己的慣用名字
- 別人都怎麼叫他
- 希望 AI 如何稱呼使用者
- 英文名
- 有沒有稱號或筆名
- 有沒有品牌名稱
- 不同情境下使用的身份稱呼

不需要要求使用者提供法定姓名,重點是記錄未來實際產出內容可能使用到的稱呼方式。

---

# 第二題:確認使用者的工作型態

詢問:

你目前主要是以什麼型態工作?
1.公司或組織任職
2.自己創業(例如自由接案、獨立顧問等)
3.內容創作者
4.教育工作者(例如專職講師、學校老師等)
5.其他,或同時有多種工作型態?

如果使用者有多種工作型態,可以進一步確認:
- 哪些工作型態目前仍然重要
- 哪一個是主要工作型態
- 哪些工作型態未來會需要 AI 協助

不要強迫使用者只能選一種。

---

# 第三題:依照工作型態,了解使用者的角色與責任

這一題必須根據第二題的回答調整問法,不要使用同一個問題套用所有使用者。

目標是了解:使用者在目前的工作型態裡扮演什麼角色,以及主要負責什麼。

如果使用者在公司或組織任職,可以詢問:
你目前在公司或組織裡主要是什麼角色?主要負責哪些事情?如果有管理團隊、負責決策、面對客戶或跨部門協作,也可以一起說明。

如果使用者是自由接案者,可以詢問:
你主要提供哪些服務?通常承接什麼類型的案子?你自己通常負責哪些部分?

如果使用者是獨立顧問,可以詢問:
你主要提供哪一類顧問服務?通常協助什麼樣的客戶解決哪些問題?

如果使用者是講師或教育工作者,可以詢問:
你主要教授哪些主題?面對哪些學員?除了授課之外,平常還有哪些主要工作?

如果使用者是內容創作者,可以詢問:
你主要創作哪些主題的內容?通常在哪些平台發布?主要面對什麼樣的受眾?主要的商業模式是什麼?

如果使用者是創業者或經營者,可以詢問:
你目前經營什麼樣的事業?你自己主要負責哪些部分?哪些事情通常需要你親自決策?

如果使用者同時有多種重要工作型態,分別了解與未來 AI 協助最相關的角色。

---

# 第四題:了解使用者平常真正花時間處理的工作

詢問:
你平常最常花時間處理哪些類型的工作?其中有哪些事情,是你未來最可能希望 AI 協助的?

目標不是再問一次職責,而是了解使用者實際的日常工作。

例如可能包含:
- 整理會議資訊
- 撰寫 Email
- 準備簡報
- 撰寫企劃
- 分析數據
- 製作報告
- 做研究
- 規劃專案
- 管理團隊
- 跟客戶溝通
- 準備提案
- 招募與面試
- 教學與備課
- 製作內容
- 寫程式
- 整理行政工作
- 安排行程
- 追蹤工作進度

不要根據職業自行假設使用者一定會做哪些事情,以使用者實際回答為準。

---

# 第五題:了解使用者工作的環境與脈絡

詢問:
你平常主要使用哪些工作工具或平台?通常和哪些人合作?你的工作成果主要是給誰使用或閱讀?另外,如果有固定的產業、市場、地區或組織背景,也請一起說明。

主要蒐集:
- 長期使用的工作工具與平台
- 合作與溝通對象
- 工作成果的主要對象
- 所屬產業
- 主要市場
- 國家或地區
- 跨國或特殊組織背景

只記錄長期成立,而且未來仍可能影響 AI 工作方式的資訊。

---

# 第六題:了解使用者的長期基本偏好

詢問:
有哪些不管換成什麼工作任務,大多仍然會成立的基本偏好,是你希望 AI 長期知道的?

例如:
- 慣用語言
- 地區用語
- 貨幣
- 日期格式
- 單位
- 長期固定使用的平台或工具

這一題不要詢問或分析以下,這些不屬於本次背景 onboarding 的範圍:
- 寫作風格
- 語氣
- 句型
- 表達節奏
- 思考方式
- 判斷方式
- 決策原則
- 個性

---

# 如何整理使用者的回答

在整個訪談過程中,請持續將資訊整理到以下六個類別:

1. 基本身份與稱呼
2. 工作型態
3. 身份、角色與責任
4. 日常工作與 AI 協助情境
5. 工作環境與工作脈絡
6. 長期基本偏好

只記錄使用者明確提供或確認的資訊。

不要把事實擴大成推論。

例如:

如果使用者說:「我管理一個十人的業務團隊。」
可以整理成:「目前管理十人的業務團隊。」
不要整理成:「具備優秀的領導與團隊管理能力。」

如果使用者說:「我主要負責企業客戶。」
可以整理成:「主要負責企業客戶。」
不要自行補成:「擅長大型企業銷售與複雜談判。」

除非使用者自己明確說明。

另外:
- 不要美化使用者
- 不要替使用者建立人格標籤
- 不要推論價值觀
- 不要因為職稱而自行補充工作內容
- 不要把短期任務寫成長期背景
- 不要把單一專案資訊當成使用者特徵
- 不要把「目前正在做」自動推論成「長期專業」
- 如果資訊互相矛盾,先向使用者確認

---

# 訪談完成後的輸出

完成必要訪談後,停止提問。

把取得的資訊整理成:

# 使用者背景原稿

## 基本身份與稱呼

## 工作型態

## 身份、角色與責任

## 日常工作與 AI 協助情境

## 工作環境與工作脈絡

## 長期基本偏好

這份「使用者背景原稿」目前先:
- 不需要刻意壓縮
- 不需要蒸餾成最終 User Profile
- 不需要寫入 Memory
- 不需要修改 USER.md

這個階段的目標只有:
正確、完整地建立使用者的長期背景原稿,供下一階段蒸餾成 USER.md 使用。

完成後停止,等待使用者確認。
現在請從第一題開始訪談使用者。
跑完這段 Prompt 之後,Hermes 最後應該會整理出一份比 USER.md 詳細很多的「使用者背景原稿」。
這份原稿暫時不用管長度,這是刻意的。
因為如果一開始就要求 Agent 一邊訪談、一邊想辦法塞進 USER.md 的容量限制,它很可能太早開始刪東西。
最後你看到的結果不完整,卻很難判斷:
是自己沒有講到,還是 Hermes 為了壓字數把它刪掉了?
所以我將「蒐集」和「壓縮」拆成成兩步。
第一步先建立一份你看得懂、也可以檢查的你的分身背景的原稿。
這時只需要檢查幾件事情:
這份原稿確認沒問題之後,再開始真正的蒸餾。
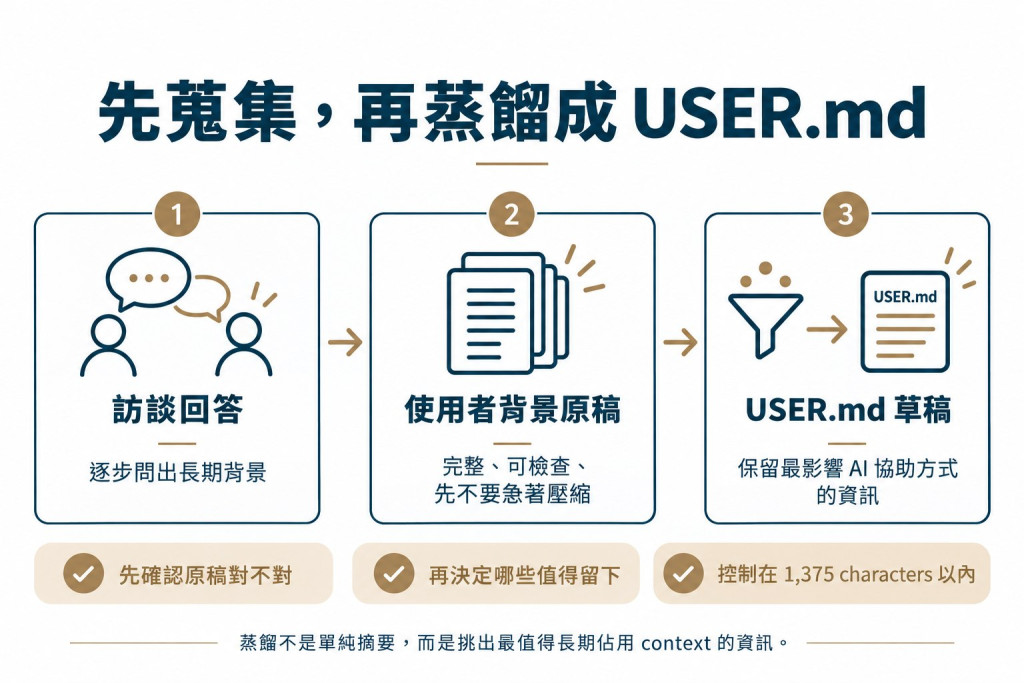
Hermes 官方目前對內建 USER.md 的預設上限是 1,375 characters,約 500 tokens。官方把這類 character limit 的目的描述為讓 memory 維持聚焦,而且當內容超過容量時,memory tool 會回傳錯誤,而不是默默把後面的內容截掉。
所以 USER.md 不是拿來保存完整訪談紀錄的。
真正要做的是:
從完整人物原稿裡,挑出最值得長期佔據 context 的資訊。
這跟一般「摘要」不太一樣。
摘要通常只是:
原文 3,000 字,把它變成精簡 500 字。
但蒸餾更像:
3,000 字裡,究竟哪 500 字未來最有價值?
例如人物原稿裡可能寫:
我平常會用 Outlook、Teams、Excel、PowerPoint,而且偶爾需要 SharePoint。
如果這些工具沒有個別重要性,可以濃縮成:
工作主要使用 Microsoft 365 生態系。
但假設原稿中還有一句:
我主要負責公司高階主管使用的財務分析,但沒有程式開發背景。
這句可能反而值得完整保留。
因為 Hermes 如果不知道這件事,很可能:
也就是說,蒸餾不是在比較哪一句比較短、壓縮比較多,它是在做:
哪一句會最常改變 Hermes 未來幫你做事的可能
把上一階段產生的「使用者背景原稿」貼在這段 Prompt 後面即可。
我將給你一份已經由使用者確認過的「使用者背景原稿」。

請把這份背景蒸餾成一份適合 Hermes USER.md 使用的 User Profile。

你的目標並非單純做摘要,而是:在有限空間裡,保留未來最可能影響 AI 如何協助使用者的長期背景,要遵守以下規則。

# 1. 優先保留
優先保留:
- 使用者的姓名、慣用稱呼或重要對外身份
- 主要工作型態
- 長期成立的主要角色與責任
- 經常處理、而且未來可能交給 AI 協助的工作
- 會影響 AI 建議的工作環境與工具
- 主要合作對象或工作成果對象
- 長期成立的產業、市場或地區背景
- 語言、地區用語、貨幣等基本偏好
- 如果不知道,很容易造成 AI 誤判使用者需求的背景

# 2. 優先刪除
不要保留:
- 短期任務、很快會過期的資料
- 單次專案、單一客戶的暫時資訊
- 與未來工作關聯低的個人資訊
- 已重複過的資訊,或只是換句話說的資訊
- 可以從其他資訊直接推得、不值得另外佔空間的內容

# 3. 不要自行推論
只使用原稿中已經確認的資訊。不要:
- 推論使用者的人格
- 推論價值觀
- 美化使用者的能力
- 把「負責某件事」寫成「擅長某件事」
- 因為職稱而增加原稿沒有的背景

# 4. 合併相關資訊
盡量提高資訊密度。

例如:「使用 Outlook、Teams、Excel、PowerPoint」
如果個別工具沒有特殊重要性,可以濃縮為:「工作主要使用 Microsoft 365 生態系。」
但不要為了縮短而刪掉真正會影響 AI 未來工作的限制或背景。

# 5. 控制長度
最終 USER.md 請控制在 1,375 characters 以內,但不要把它當成必須塞滿上限字元的目標。
如果更短就足以完整保存重要資訊,優先保持精簡。

# 6. 輸出格式
第一部分:USER.md 草稿

直接提供完整可用的內容。

第二部分:蒸餾說明

簡短告訴使用者:
- 哪些資訊被合併
- 哪些資訊被刪除,為什麼刪除
- 有沒有任何你認為介於「值得保留」與「可以刪除」之間的資訊,要使用者確認

還不要立刻修改 USER.md
先請使者檢查檔案看看有無問題,有的話跟你說,沒的話才可寫入 USER.md

##使用者尚未蒸餾的背景原稿##
[把上一階段產生的使用者背景原稿貼在這裡]
這一步很重要,因為這份 Profile 建立之後,後面會跨對話一直跟著 Hermes Agent。
建議用三個問題快速檢查。
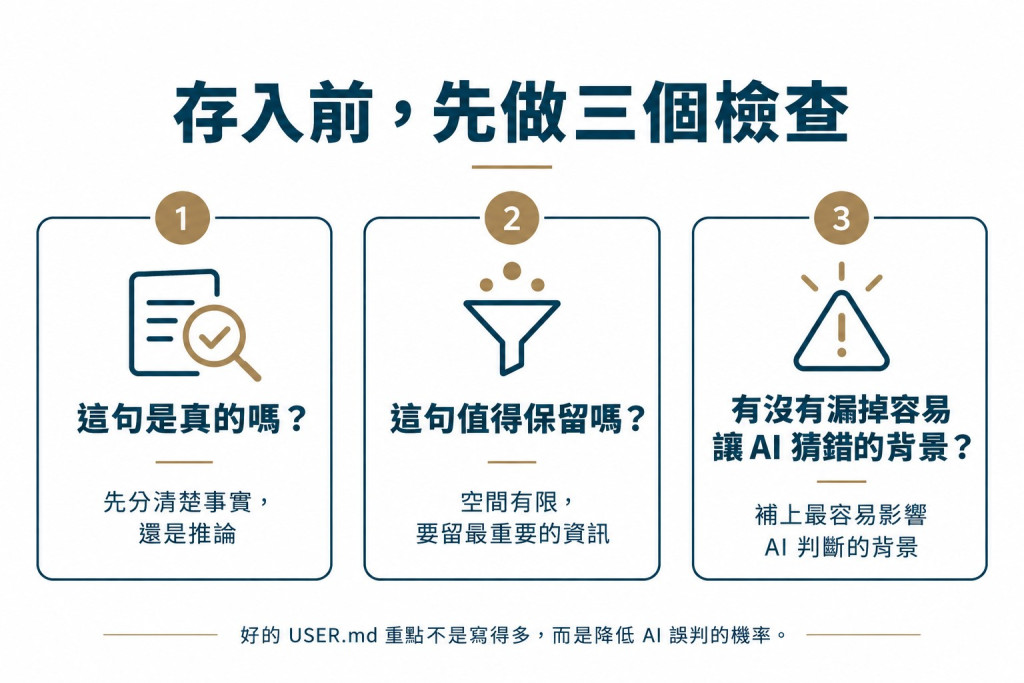
先檢查它有沒有把事實變成推論。
例如原始資料是:我管理十人的業務團隊。
但蒸餾後如果變成:擅長團隊管理與領導,那就不一樣了。
第一句是事實,第二句是 Agent 對你的評價,User Profile 應該盡量以前者為主。
USER.md 預設只有一千多個字的上限,官方也明確建議 memory 應該保持 compact、information-dense,而不是保存原始資料 dump。
所以 Review 時可以刻意問一個有點殘酷的問題:
如果要為了保留這一句,而刪掉另一句,它還值得留下嗎?
例如:
使用 PowerPoint。
可能就沒有:
主要工作成果是提供高階管理層做決策。
來的這麼有價值。
因為第二句會影響 Agent 未來:
這通常比「有沒有把所有背景都寫進去」更重要。
例如:
我是產品經理,但沒有程式開發背景。
這句對你的 Agent 非常有用,因為如果它不在 Profile 裡,Hermes 很可能一看到技術問題,就直接假設你讀得懂程式碼。
所以一份好的 USER.md 是要最能降低 Agent 誤判機率的背景摘要。
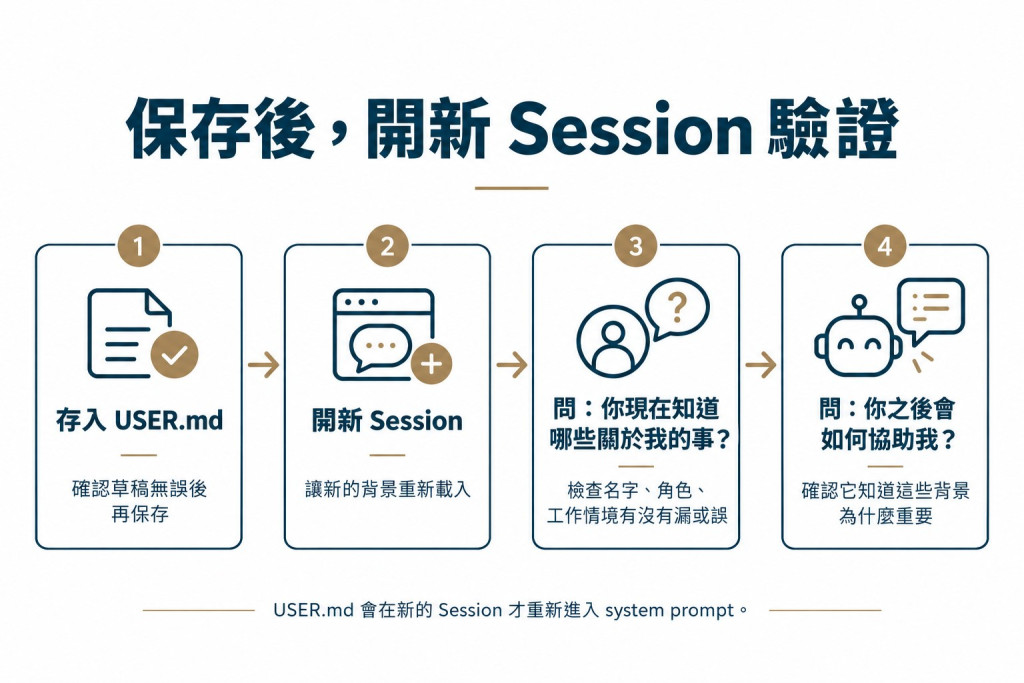
確認 USER.md 草稿沒問題後,才進到保存。
這時可以很自然地告訴 Hermes:
我已確認無誤,存入 USER.md 吧!
基本上,Hermes 的內建 memory 系統會透過 memory tool 管理 USER.md,支援新增、取代與移除內容。
R森小叮嚀:
USER.md和MEMORY.md都會在新 Session 開始時被載入 system prompt。所以確定存入後,要重開新的對話,或是關閉整個 Desktop APP 再重開。
正常情況下,不需要明確要求 Hermes:「呼叫 memory tool 存我的 USER.md」
但 Hermes 官方 troubleshooting 特別提醒一個情況:
在一些狀況下,Hermes 可能會說他已「記住」了,但實際上根本真的寫入 USER.md,也就是說,沒有呼叫 memory tool(它只是「記住」在當前的「Session」中,而非長期記憶),這個問題在大約 30B 以下的較小本地端模型,以及 tool-calling 能力較弱的模型上比較容易發生。遇到這種狀況時,可以明確要求 Hermes 使用 memory tool 保存,並確認資料真的進入 USER.md。
所以我的做法會是平常不用特別強調。
如果你發現:Hermes 明明說記住了,下一個 Session 卻完全不知道。
再回來下指示詞「使用 memory tool 保存到USER.md」即可
Hermes 的 USER.md 在修改之後不會立刻重新塞進目前這個 Session 的 system prompt。
它的機制是:
USER.md和MEMORY.md在 Session 開始時,以 frozen snapshot 的形式載入。
如果目前 Session 中途修改 memory,內容會立即寫到硬碟,但已經在執行的 Session 不會重新載入;新的內容會在下一個 Session 才重新進入 system prompt。這是 Hermes 為了保留 LLM prefix cache 效能而採用的設計。
所以完整流程應該是:
完成 onboarding
↓
確認 USER.md
↓
保存
↓/new(開新的對話)
↓
在新的 Session 裡驗證
問一些具體的關於你的問題,例如
你現在知道哪些關於我的事。
然後檢查:
接著可以問:
你之後在幫我工作時,有哪些事情你會特別幫我注意?
這比單純回讀更有意義,因為我們想確保它知道:這些背景為什麼重要。
例如如果它知道你的工作成果主要給管理層閱讀:它就可能理解在未來整理報告時,要優先凸顯決策資訊、風險與關鍵結論。
如果它知道你沒有程式開發背景:它就應該理解之後在解釋技術問題時,不應該直接假設你能閱讀大量程式碼。
把第一個 Prompt 交給 Hermes。
讓它主動問你:
最後得到:
你的分身背景原稿
把背景原稿交給第二個 Prompt。
讓 Hermes 精簡並挑出:哪些資訊值得長期佔用 USER.md 的空間。
最後得到:
USER.md(Draft)
自己 Review:
確認後要求 Agent 用 memory tool 保存進 USER.md 中。
讓 Hermes:
完成之後,你就已經建立好 AI 分身的第一層:
「我是誰。」
之後開新的 Session 就會自動載入這些你的背景資訊。
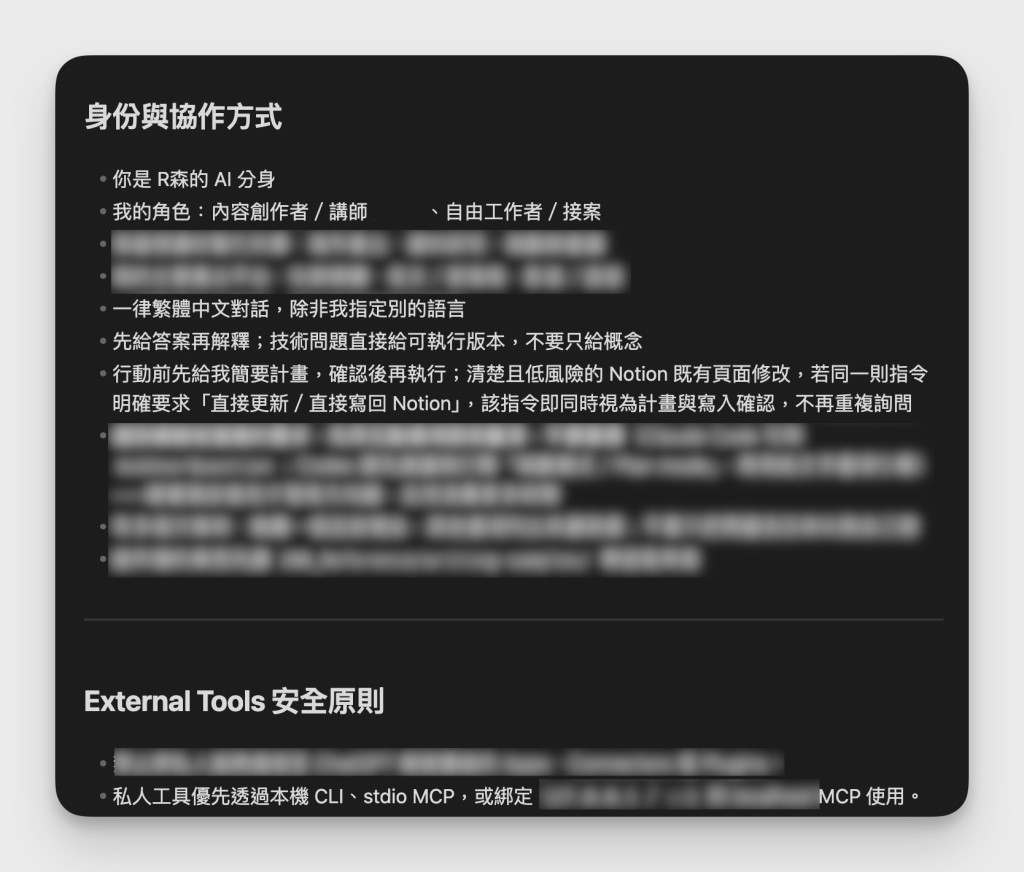
做到這裡,Hermes 會比一開始更了解:
但它還不代表已經「像你」。
它目前知道的是:你是誰。
它還不知道:你怎麼表達。
更不知道:你怎麼思考、判斷與做事。
接下來,我們要開始從「認識你」,往「像你」再往前走。
打造 AI 工作分身,不需要一開始就想把整個自己的一塊資料都塞給 AI。先把「我是誰」這個人物底模做好,後面的表達、思考與工作方式,分層級一層一層疊上去。


 iThome鐵人賽
 看影片追技術