

昨天做完 Guided Learning 之後,Visual Learning Lab 終於不只是把教材整理好放在畫面上,而是會真的排出一條學習順序,帶著使用者一個 Step 一個 Step 往下走,最後再用 Knowledge Check 確認自己到底有沒有理解。
但實際測完之後,我馬上又看到一個問題。
假設最後三題只答對一題,畫面會很誠實地告訴我:
Knowledge Check: 1 / 3 correct
然後呢?
其實就沒有然後了。
系統明明已經知道我錯了哪兩題、我選了哪一個錯誤答案、正確答案又是什麼,甚至還知道這兩題原本跟 Guided Learning 的哪幾個 Step 有關。
結果最後卻只是丟一句 Not quite 給我。
我覺得有點浪費。
所以 Day 13 我決定把 Knowledge Check 往後再接一段:
Adaptive Review Mode。
它不是只記錄「你答錯了」,而是開始利用這個錯誤,決定接下來應該複習什麼。
Day 12 的流程大概是:
Guided Learning
↓
Knowledge Check
↓
顯示答對幾題
↓
結束
Day 13 之後則變成:
Guided Learning
↓
Knowledge Check
↓
找出答錯的題目
↓
回到相關 Learning Step
↓
Focused Review
↓
Retry Check
我覺得這兩個版本看起來只差後面幾步,但產品感其實差滿多的。
前一個版本是在「測你」。
新的版本開始試著利用測驗結果,改變下一步要給你的內容。
要做到這件事,第一個要補的其實不是 AI,而是資料結構。
昨天產生 Knowledge Check 時,每一題本來都有 question、options、correct answer、explanation 和 source pages,但它其實不知道自己跟哪一個 Guided Learning Step 有關。
所以 Day 13 先在 checkpoint question 裡加入 related_step_ids。
例如一題是在考 phase shift,它可能就會指向前面「Interpret period and phase」這一個 learning step。
這個 mapping 很重要,因為之後使用者答錯時,根本不用再問 AI:
「這一題錯了,我應該回去複習哪裡?」
系統直接看 structured data 就知道了。
也就是說,Review Queue 本身完全可以在本地產生,不需要 API。
如果兩題都指向同一個 Step,還會把重複的 Step 合併;如果是不同 Step,就按照原本的 learning path 順序排回去。
這次我還是用 Sinusoids 的教材測試。
三題我故意只答對一題,最後得到:
Knowledge Check: 1 / 3 correct
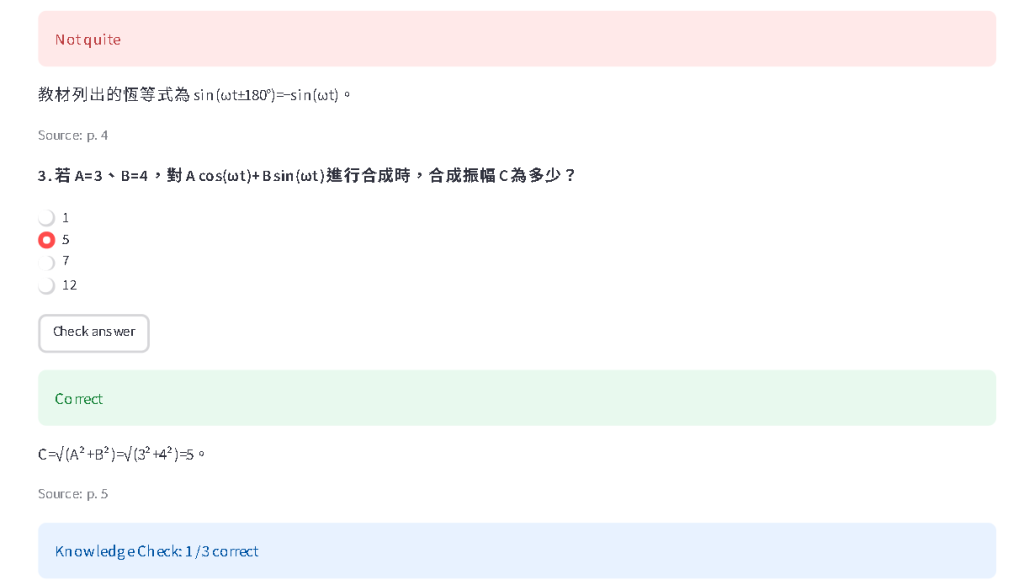
接著系統開始整理這次需要回頭看的內容。
最基本的版本不是直接再生一大篇 AI 回答,而是先建立 Review Queue,告訴我哪些 Guided Learning Step 跟這次答錯有關。
如果按下 Review step,它會直接把原本 Guided Learning 的 current step 切回那一頁。
整個過程不會重新分析 PDF,也不需要重新產生一份課程。
這點我滿喜歡的,因為前面花時間建立的 stable step ID 終於開始有用了。
一開始做 Structured Outputs 時,我只是覺得「有固定格式比較好處理」;做到後面才發現,這些 ID、Relationship、source page、step mapping,全部都開始變成後面互動功能的基礎。
單純把我送回原本課程還不夠。
因為我真正想知道的不是:
「這一章你沒看懂。」
而是:
「你到底誤會了什麼?」
所以這次另外加入了一個 Build focused review。
這個按鈕才會真的再呼叫一次 OpenAI API。
但它不是重新把整份 PDF 再分析一次,也不會把原始 PDF 整包重傳。
送出去的是已經整理好的相關 context,包括答錯的題目、使用者剛才真的選了哪一個錯誤選項、正確答案、原本的 explanation、相關 learning steps、Key Concepts、Relationships、Visual Evidence,以及那些 Step 對應頁面的 extracted text。
最關鍵的是這一段:
模型會看到我實際選了什麼錯誤答案。
這讓它可以針對錯誤本身解釋,而不是只重新講一次課本內容。
這次其中一個錯誤是把 V_m 跟水平位移混在一起。
Focused Review 沒有只重新介紹「什麼是正弦波」,而是直接指出:
不要把
V_m視為水平位移參數。
接著再重新區分 V_m 和 θ:
V_m 控制的是波形垂直方向的峰值大小,而 θ 才決定相對參考波形的水平位移或起始相位。
這就是我今天最想看到的結果。
因為系統不是只知道:
Question 1 = Wrong
而是真的知道:
使用者在 Question 1 選了這個錯誤答案,所以可能把兩個參數的角色搞混。
另一題我故意把「增加 180° 相位」理解成波形保持不變。
Focused Review 也直接針對這個誤解重新說明:增加 180° 等於把正弦波移動半個週期,sin(x+180°) = -sin(x),所以每一點的值都會反號。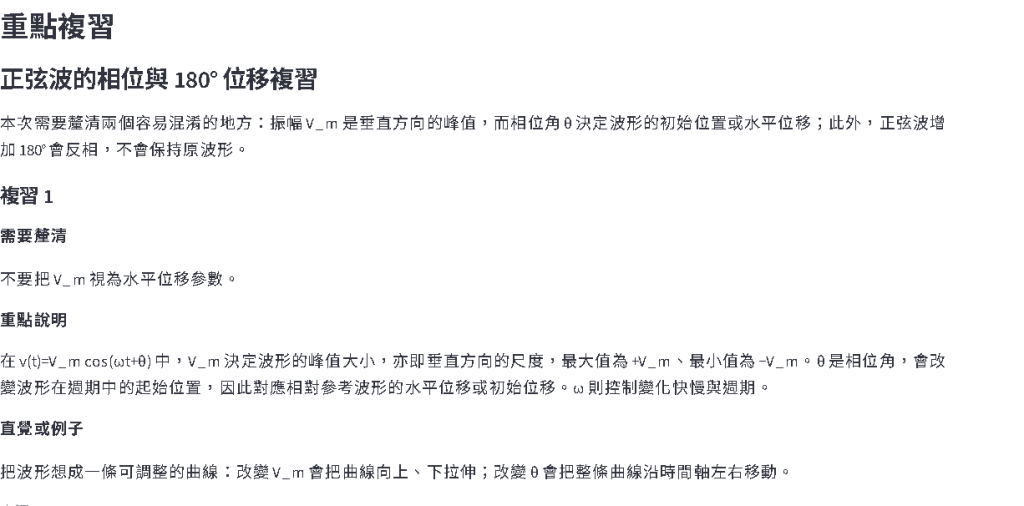
這裡我覺得已經比普通的「答錯後顯示詳解」更接近我想做的東西。
普通 Quiz 的 explanation 通常是在解釋:
為什麼正確答案是 B?
現在我比較想讓系統回答:
為什麼你剛剛會選到 D,而且 D 跟 B 到底差在哪裡?
這兩個其實是不太一樣的。
因為這次開始增加第二種 API request,所以 cache 也變得更重要。
如果同一份教材、同樣兩題答錯,而且連選錯的 option 都一樣,那再次按 Build focused review 不應該又重新呼叫一次 API。
所以 Focused Review 的 cache identity 不只看 material hash,還會把「錯了哪些題」以及「選了哪些錯誤 option」一起算進去。
概念上大概是:
material identity
+ incorrect question IDs
+ selected wrong option IDs
這樣如果錯誤模式完全相同,可以直接重用之前的 review。
但如果這次第二題改答對、只剩第三題錯,incorrect-answer pattern 就變了,舊的 Focused Review 也不能直接拿來用。
這件事情如果沒處理好,很容易出現一個很荒謬的狀況:使用者明明已經改答對了,系統還在叫他複習上一輪的錯誤。
Focused Review 做完之後,下面還有一個 Retry Check。
這次也不是把剛剛三題原封不動再出一次。
Focused Review 的 Structured Output 會另外產生一小組 retry questions,通常是兩題,而且應該針對剛才真正答錯的概念重新設計。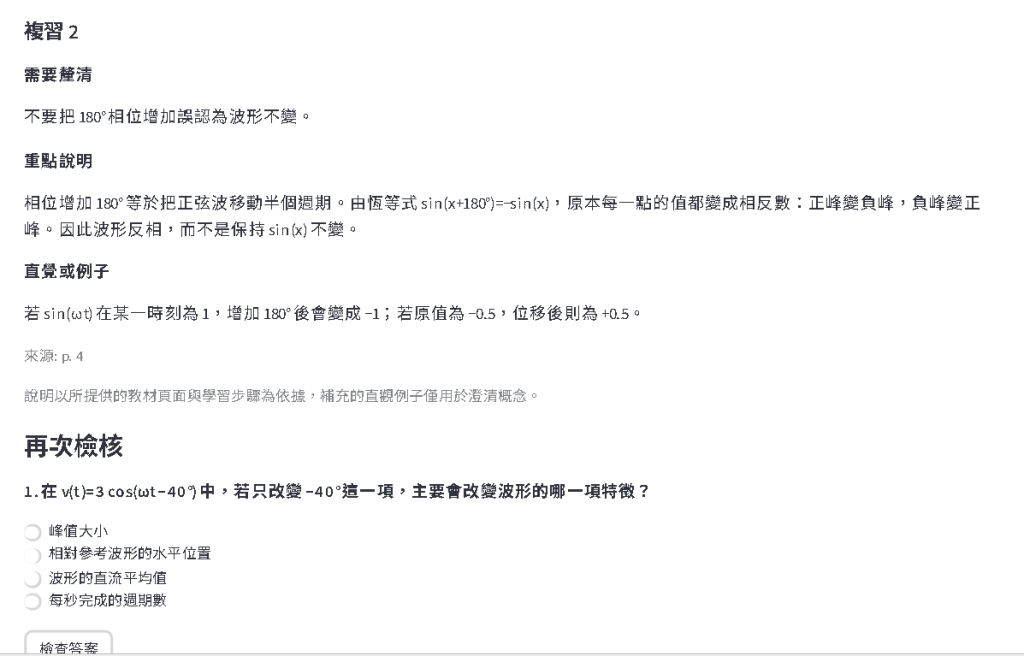
像這次第一題直接改成問:
在
v(t)=3 cos(ωt-40°)中,如果只把-40°改成-40°之外的相位值,主要改變波形哪一項特徵?
也就是重新檢查使用者到底有沒有分清楚 amplitude、frequency 和 phase。
另一個錯誤則會換一種方式再測 180° phase shift,而不是把剛才的題目重新貼一次。
跟 Day 12 一樣,Retry Check 的作答本身完全不需要 API。
因為 correct option 和 explanation 已經在產生 Focused Review 時一起回來了。
所以使用者選答案、按 Check answer、顯示 Correct 或 Not quite,全部都是本地判斷。
目前 API 行為變成:
| 操作 | OpenAI API |
|---|---|
| 第一次分析教材 | 1 次 |
| Guided Learning 導覽 | 0 次 |
| 原始 Knowledge Check | 0 次 |
| 建立 Review Queue | 0 次 |
| Review step | 0 次 |
| Build focused review | 1 次 |
| Retry Check | 0 次 |
我越做到後面越覺得這個區分很重要。
AI 應該用在真的需要重新推理、重新生成內容的地方,而不是每一個互動都丟給模型。
Day 12 做完 Guided Learning 時,雖然看起來已經很像一個學習流程,但其實每個人拿到的路線還是一樣。
只要輸入教材相同,AI 產生的 learning path 相同,Step 1 到 Step 5 基本上就是固定的。
Day 13 第一次開始不一樣。
因為使用者的 Knowledge Check 作答,真的會影響後面的畫面。
答對三題的人,不需要 Focused Review。
答錯 phase 的人,會被帶回 phase。
把 amplitude 和 phase 搞混的人,Focused Review 就會針對這兩個參數的差別重新解釋。
答錯 180° phase shift 的人,Retry Check 也會再測相關概念。
所以現在整個流程開始變成:
教材內容
↓
決定第一條學習路徑
↓
使用者作答
↓
使用者的錯誤
↓
決定下一段複習內容
這可能是目前 Visual Learning Lab 第一次真的出現一點「adaptive」的感覺。
Day 13 的 app.py 大約又增加了 800 多行。
除了原本 Guided Learning 和 Quiz 的 state,現在還多了 Review Queue、Focused Review Structured Output、錯誤 pattern cache、Retry Check state,以及新教材載入後的 adaptive state reset。
功能確實開始變複雜。
但我覺得至少目前這些複雜度都還是圍繞著同一件事情:
讓教材理解的結果變成真正可以互動的學習流程。
而不是為了功能數量一直塞東西。
Day 13 做完後,我自己最喜歡的不是 Retry Check,也不是又多了一個 AI request。
而是產品面對錯誤的方式開始變了。
以前是:
Not quite.
現在比較像:
你剛才在這裡把
V_m和θ搞混了。
我們先回去看這一步。
接著換一個方式重新解釋。
最後再用另一題確認一次。
這才比較接近我想像中的學習工具。
因為真正學習時,答錯本來就不應該只是得到一個紅色框框。
錯誤本身其實就是一個訊號,告訴系統:
下一步應該教什麼。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab


 iThome鐵人賽
 看影片追技術