

今天做的不是再多加一張圖,而是把 Visual Learning Lab 的底層往前推一層:同一個教材概念,開始可以同時用 Sample Space、集合圖、機率樹、公式和 Monte Carlo 模擬來理解,而且它們共用同一份狀態。更重要的是,這一天也是目前為止我跟 Codex 來回最多次的一天——第一次它跟我說功能完成、測試也全過,但我真的把教材丟進去之後,畫面幾乎還是 Day 16。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
前幾天做到 Interactive Lab 和 Dynamic Simulation 之後,我原本其實滿開心的。公式可以拉參數、圖會即時改變,碰到有時間演化的模型還可以直接播放動畫,整個網站已經比一開始單純整理教材完整很多。
但我後來拿另一份機率筆記測試,馬上發現一個問題。
那份教材在講樣本空間、事件、聯集、交集、補集、De Morgan 定律和基本機率,可是 Visual Learning Lab 還是很努力地把內容整理成 Concept Map,再加上一大串 Relationships。
結果畫面大概就是「樣本空間包含事件」、「聯集和事件有關」、「補集和事件有關」這種文字。
不能說錯,但看完沒有比較懂。
尤其集合這種東西,本來就是非常適合用圖理解的內容。E ∩ F 與其寫一行「同時屬於 E 與 F」,直接把兩個集合中間的交集塗起來不是更清楚嗎?丟兩次硬幣的 (H,H)、(H,T)、(T,H)、(T,T) 也不應該只是一串文字,它明明可以同時變成 Sample Space 和 Probability Tree。
所以 Day 17 我開始想一件更大的事情:
如果同一個知識本來就有很多種表示方法,為什麼系統每次只能生出其中一張圖?
這次我把新的架構叫做 Learning Scene Compiler。
目前的想法是先讓 AI 從教材裡整理出一份比較接近「知識模型」的資料,例如有哪些 outcome、event、event 裡包含哪些 outcome、有沒有分階段實驗,以及這些物件之間的關係。
接著再由程式裡固定的 Validator 檢查這份資料,最後交給不同 Renderer 呈現。
整個概念大概是:
教材
  ↓
AI 理解內容
  ↓
Learning Scene Compiler
  ↓
Semantic Model
  ↓
Validator
  ↓
Shared Semantic State
  ↓
Sample Space / Set View / Probability Tree / Formula / Monte Carlo
這裡我刻意延續 Day 15、Day 16 的設計:AI 不能直接丟一段 Python 或 JavaScript 給程式執行。
它只負責告訴系統「這個世界裡有哪些東西」。
真正怎麼計算集合、怎麼跑 Monte Carlo、怎麼決定哪一條 Probability Tree 路徑要亮,全部由程式自己的 runtime 處理。
第一版我沒有貪心一次做所有領域,先從 Probability / Sets 開始。
(H,T),現在可以在不同圖裡一起看到這次測試的教材裡有一個很標準的例子:丟兩次硬幣。
樣本空間是 S = {(H,H), (H,T), (T,H), (T,T)}。
Day 17 做完後,畫面上會同時出現 Sample Space、集合視圖和 Probability Tree。
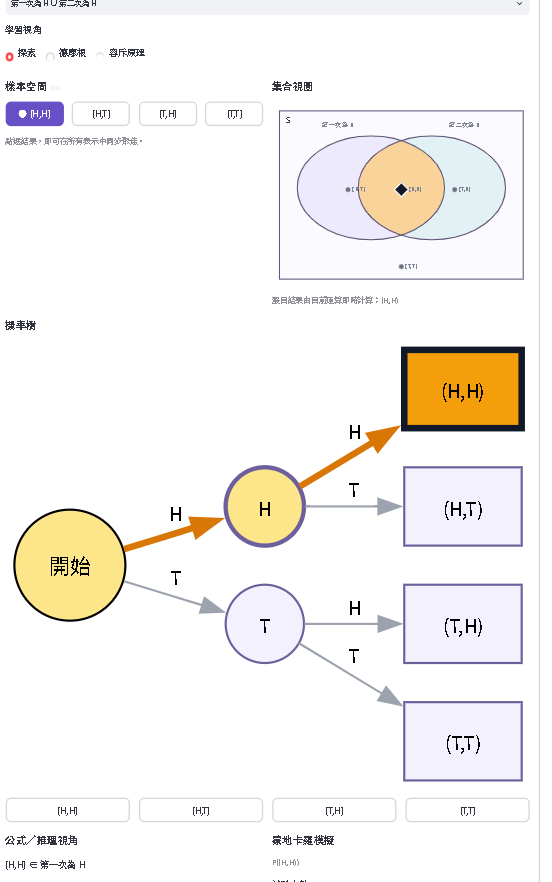
真正讓我覺得這次和以前不太一樣的地方,是我點其中一個 outcome 時。
例如我點 (H,T)。
Sample Space 裡的 (H,T) 會保持選取,Probability Tree 同時把 開始 → H → T 這條路徑亮起來,集合圖也會標出它所在的區域,下面的 Formula / Reasoning Lens 則改成顯示 (H,T) 到底屬於哪些事件。
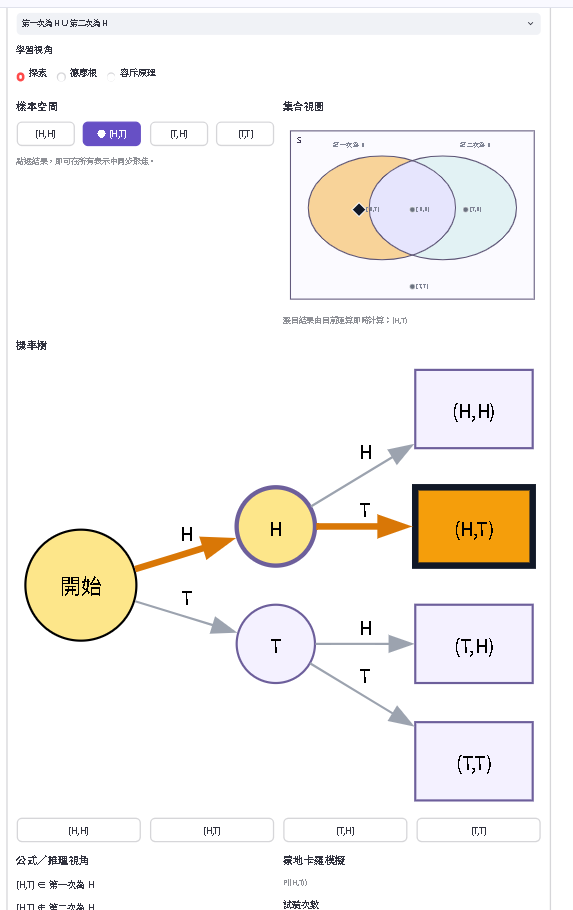
再換成 (T,H),Tree 就變成 開始 → T → H。
換 (T,T) 時,它會落到兩個事件外、但仍然在樣本空間 S 裡的位置,Probability Tree 也一起切到 開始 → T → T。
我這次最想做出的其實就是這個感覺。
使用者不是在「操作某一張圖」。
他選的是 (H,T) 這個概念,然後每一種 representation 都用自己的方式告訴他 (H,T) 代表什麼。
這一天中間也發生一件我覺得很值得記的事情。
Codex 第一版確實成功產生集合圖,但它把 Sample Space S 也當成一個 event,於是畫面上變成一個叫 S 的圓和另一個 E 的圓重疊。
乍看有兩個圓,很像 Venn Diagram。
但數學上其實完全不對。
Sample Space S 應該是最外面的 universe,Event E、F 才是裡面的集合,所以後來 Validator 和 Renderer 都重新調整,現在 S 會變成整個外框,真正的事件才畫成裡面的區域。
這也讓 complement 比較有意義。
例如 Eᶜ 不是另一個神奇的圓,而是「S 裡所有不屬於 E 的部分」。
而且現在切換 E、F、E ∪ F、E ∩ F、補集或差集時,集合圖會根據真正的 outcome membership 去改變著色區域,不只是畫兩個裝飾用的圓。
第二個問題是 Probability Tree。
第一次做完時,明明教材裡有 (H,H)、(H,T)、(T,H)、(T,T),畫面上卻完全沒有 Tree。
後來才發現 AI 產生的 Scene Spec 把這段資料判斷成「不是 staged experiment」,所以 Validator 看到沒有 stage path,就很合理地把 Probability Tree 拿掉了。
但這四個 outcome 其實已經完整形成一個兩階段 Cartesian product。
因此後來我和 Codex 加了一個比較保守的 recovery:只有當 tuple outcomes 足夠完整,而且真的可以安全還原路徑時,程式才重新建立 staged paths。
像這次就可以還原成第一次 H/T、第二次 H/T,所以最後成功得到完整的四個 leaf。
如果 outcome 不完整,就不亂猜。
這個處理我自己滿喜歡,因為它不是單純「AI 說什麼就全部照做」,程式還會再檢查一次資料本身有沒有足夠結構。
更有趣的是,我第一次看到 Sample Space 可以點的時候,本來還以為 Shared State 成功了。
結果實際測試才發現,點 (H,T) 之後只有那顆按鈕變紫色。
Venn 沒變。
Tree 沒變。
Formula 也沒有真的跟著走。
等於畫面上雖然擺了很多圖,但它們還是各玩各的。
後來 Codex 追下去才找到問題:outcome button 更新 shared state 的時間點太晚了,有些 view 已經先 render 完才收到新的 selection,因此畫面上看不到同步。
最後改成使用 Streamlit callback 先更新同一份 semantic_focus,再讓所有 renderer 在同一輪 rerun 裡讀這份 state。
修完之後,才真的變成現在看到的效果。
這也是我這幾天越來越有感的一件事:做 AI 產品時,「資料結構設計正確」和「使用者真的感覺得到它正確」其實是兩回事。
Learning Scene 下方還有 Formula / Reasoning Lens。
例如目前選到 (T,H),它會根據 scene 裡面的 membership 顯示 (T,H) 屬於哪些事件、不屬於哪些事件。
這些內容不是再丟一次 API 問模型,而是直接讀 normalized scene。
因此點 (H,T)、(T,H) 或其他 outcome 時,Formula Lens 只是重新從同一份 semantic state 解讀。
另外像 Inclusion–Exclusion 也開始改成由程式自己算:
P(E)、P(F)、P(E∩F) 先從 event membership 得到,再組成 P(E∪F)=P(E)+P(F)-P(E∩F)。
第一版這裡也曾經出現過很醜的運算式,幾個 fraction 和 decimal 全部黏在一起,看起來比沒算還難懂。後來才改成逐項呈現,至少能看出每個數值從哪裡來。
這次 Learning Scene 的下面還放了一個 Monte Carlo Simulation。
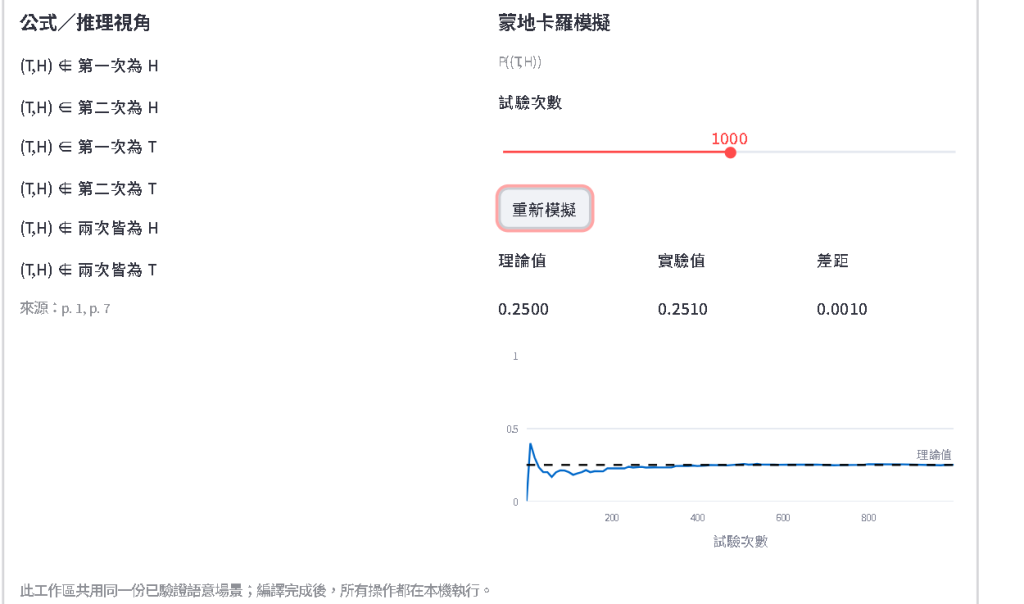
像截圖這次的結果,理論值是 0.2500,1000 次模擬後得到的實驗值是 0.2510,差距 0.0010。
下面的曲線則可以看到實驗次數增加後,empirical probability 慢慢靠近 theoretical probability。
這個功能我覺得特別適合機率。
因為學生平常看到 P(E)=1/4,很容易把它當成一個固定答案,但 Monte Carlo 可以直接讓他看到「如果我真的一直重複做這個實驗,比例會怎麼慢慢靠近 1/4」。
而且按「重新模擬」、調整試驗次數、切換不同 outcome,都不會再呼叫 OpenAI API。
Scene 建好之後,這些都只是本機運算。
Day 17 也是我目前最想留下 Codex 開發過程的一天。
第一次我把整個需求交給 Codex,最後它回報 Learning Scene Compiler、Validator、Runtime、測試全部完成,當時完整 regression suite 是 64 passed。
我看到 report 還滿開心的。
結果真的打開 Streamlit,首頁甚至還寫 Day 16/30。
把那份機率 PDF 丟進去之後,Learning Scene 入口完全看不到。
後來找到 root cause:PDF 的文字主要放在 page_texts,但 candidate detection 看的是另一條資料路徑,所以 backend 寫了一大包,真實 PDF 卻根本進不去。
修完後測試增加到 66 passed,這次入口終於出現。
接著又抓到 S 被當 event、Probability Tree 缺失、outcome selection 只有自己變色等問題。
後面一輪一輪修,最後 Day 17 focused tests 做到 19 / 19 passed,完整 regression suite 則是 72 / 72 passed。
我覺得這比單純寫「Codex 幫我快速完成了一個大型功能」有意思很多。
這次比較像:
| 階段 | 實際發生的事 |
|---|---|
| 第一版 | Backend 與 tests 都完成,但真實 PDF 根本進不了 Learning Scene |
| 第二版 | 入口出現,但集合語意錯、Tree 缺失 |
| 第三版 | 圖都有了,但只有按鈕自己變,Shared State 沒真的同步 |
| 最終版 | Outcome、Set View、Tree、Formula、Monte Carlo 開始共享同一份 semantic focus |
這也讓我開始重新理解怎麼跟 Codex 合作。
大型規格、模組拆分、Validator、測試,它真的很適合一次處理很多東西。但最後還是需要我自己真的拿一份教材進去點、去看,因為很多「測試全部通過但產品體驗根本不對」的問題,光看 code 很難發現。
Probability Workspace 現在還只是第一版。
介面上還有一些地方可以繼續整理,例如部分英文還沒有完整繁中化、Probability Tree 目前佔的空間很大、來源頁碼偶爾還太廣,Quiz 目前也還是原本的固定題數,還沒有我前幾天想加的「繼續出題、難度調整、避免重複」。
但這些我先不塞進 Day 17。
因為今天最重要的東西已經出現了:
同一個 concept 可以有很多 representation,而且它們開始共享同一個 state。
這個架構如果之後繼續往其他 domain 延伸,我真正想做到的會像三相感應馬達:3D Motor、Rotating Magnetic Field、Current Waveform、FFT Spectrum、Slip、Torque 全部連在一起;或者軌道力學裡的 3D Orbit、Velocity Vector、Angular Momentum、Energy Graph 共用同一個物理狀態。
到那時候,改一個參數不會只是「某一張圖變了」。
整個教材世界都會一起跟著變。
Day 17 還只是從最單純的機率教材開始,但我覺得 Visual Learning Lab 到今天終於開始長出一個我原本真正想做的核心:
不是幫教材生更多圖,而是讓教材本身變成一個可以探索的世界。


 iThome鐵人賽
 看影片追技術