
Day 17 我第一次讓 Sample Space、集合圖、Probability Tree、公式和 Monte Carlo 共用同一份 semantic state。做到那裡之後,我開始想:如果這套架構真的不是機率專用,那它應該也能處理更麻煩的物理系統,而且不能只是多畫幾張圖,而是讓波形、向量、空間位置、公式和時間真的代表「同一個系統」。
所以 Day 18 我直接把難度拉高,這次也刻意拿 Codex 的 GPT-6.1 Sol、較高推理深度去壓一個很大的任務:把 Learning Scene 延伸成 Spatial Learning World。第一個測試不是簡單的拋物線,而是三相旋轉磁場;後面又拿拋體運動和等速圓周運動去測它到底是不是寫死的 Demo。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
目前線上版本仍以私人測試為主,主要是避免公開使用時直接消耗我的 API 額度。
Day 17 的概念其實很單純:同一個 (H,T) 可以同時出現在 Sample Space、Venn Diagram 和 Probability Tree,而且點其中一邊,其他視圖也知道現在選到的是哪一個 outcome。
Day 18 我想把這件事往物理世界推。
這次系統裡不只有「選到了哪一個概念」,還要有時間、參數、向量、位置、波形和衍生量。於是整個資料流變成:
教材
  ↓
Semantic Learning World
  ↓
Shared Physical State
  ↓
Spatial View
Waveform
Vector / Phasor
Equation / State
3D / Camera View
  ↓
所有視圖共同讀取同一個時間與參數
這裡最重要的其實不是 3D。
真正困難的是:如果時間現在是 t=0.6 s,那空間中的向量、波形上的游標、右邊的瞬時電流、相量方向,都必須是在描述同一個 0.6 s。
如果其中一張圖自己偷偷用另一個時間,畫面再漂亮也沒有意義。
我先拿三相平衡系統測試。教材裡有 Ia(t)、Ib(t)、Ic(t) 三個彼此相差 120° 的電流,同時又有三個空間方向,以及三個分量合成後形成的 resultant field。
這種內容很適合拿來測「同一個系統,多種 representation」。
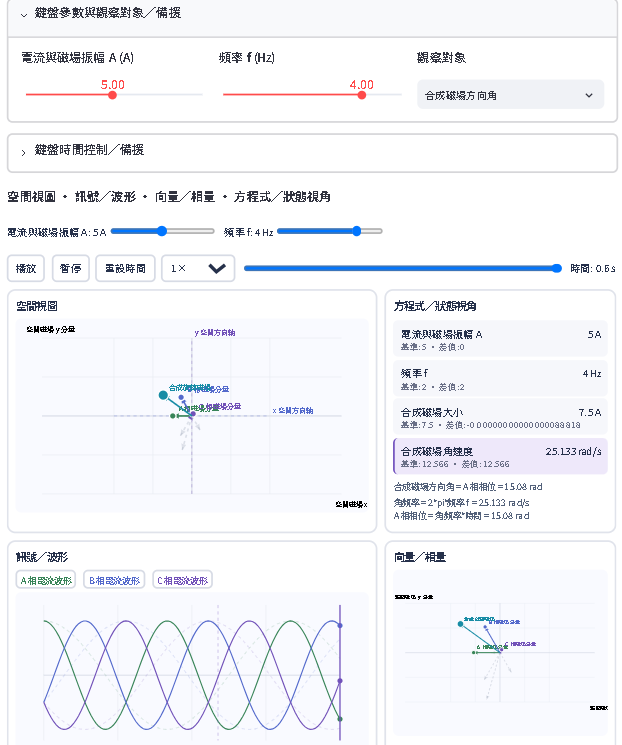
現在畫面裡可以同時看到三相波形、空間中的相軸與向量、Vector / Phasor View,以及 Equation / State Lens。上方只有一個共同的時間控制,Amplitude 和 Frequency 也不是某一張圖自己的 slider,而是整個世界共同使用的參數。
實際測試時,我改 Frequency,波形的時間尺度會變,右側的週期與角頻率跟著重新計算;改 Amplitude,三相波形和合成磁場大小一起變。這些操作都留在本機,不會重新叫 OpenAI。
我後來還測了一個更重要的方向:直接在 waveform 上選時間點。
以前都是 state → visualization,也就是 slider 改了,圖跟著改。Day 18 開始出現反過來的路徑:我在波形上選了一個位置,系統會把它換回 canonical time,其他視圖再一起跳到同一個物理狀態。
這是我第一次覺得它比較像在「操作一個系統」,而不是操作四張各自獨立的圖。
Day 15 的 Interactive Lab 已經有 baseline comparison,但這次 baseline 開始變成整個 Learning World 的 state snapshot。
例如先把目前的振幅和頻率設為比較基準,再改參數,畫面裡會保留原本的 ghost / baseline,同時顯示目前狀態。按「回到基準狀態」時,不是只有一張圖回去,而是整個 world 一起回去。
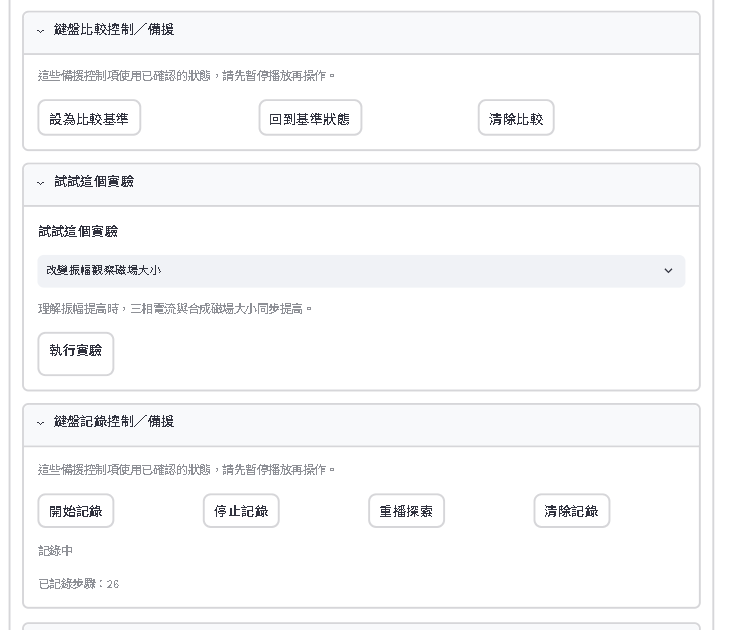
這次還多了一個 Declarative Experiment。
例如系統可以給一個「改變振幅,觀察磁場大小」的實驗。按下執行之後,它不是重新問 AI「接下來怎麼做」,而是直接操作目前已經存在的 semantic state。
也就是 AI 只是在建立世界時提供一份受限制的 experiment recipe,真正執行還是在本機。
這個概念我滿喜歡,因為它開始比較像:
「AI 幫教材建立一個實驗環境。」
而不是:
「每做一步都再問 AI 一次。」
Day 18 Ultra 裡我還故意塞了一個壓力測試:Exploration Recording & Replay。
它不是錄螢幕,也不是什麼鍵盤側錄。第一版中文翻譯真的一度叫「鍵盤記錄控制」,看到的時候超像 keylogger,後來才改成比較合理的「探索紀錄與回放」。
它實際記錄的是 semantic state change。
例如我先改 Frequency,再把時間拖到另一個位置,接著切到 Phase B。停止記錄後,按 Replay,它會照順序把這些狀態重新走一次。
這代表紀錄的其實不是 UI 上「滑鼠點了哪裡」,而是:
frequency changed → time changed → focus changed
這點我覺得滿重要,因為未來老師甚至可能操作一次 Learning World,就產生一段可以重播的互動示範。
目前 Replay 還有 UX 可以改,最早的版本真的跑太快,一個 state 一個 state 直接跳過去,很難看懂。後來才補上比較合理的 replay pacing,讓每一步至少有時間被觀察。
Day 18 也加入了 3D / Camera View。
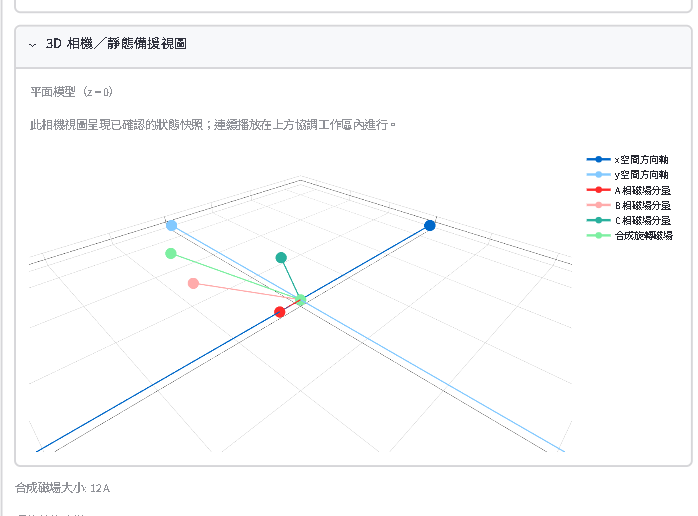
這張可以旋轉 camera、看不同方向的向量狀態,而且參數或時間改變後會跟著更新。
但我這裡不想硬把它寫成「完整 3D 模擬」。
目前這個三相場景本質上仍然是 z=0 的平面物理系統,只是可以放進 3D camera 裡觀看。Codex 最後的報告也特別註明沒有把它宣稱成完整立體物理,這點我反而覺得比較好。
中間其實還抓到一個同步問題:播放狀態下,主要 waveform 和 vector 在動,但 3D snapshot 一開始要等暫停才會追上目前 state。後面的修正才把 camera / playback synchronization 再整理一次。
這種 bug 也讓我開始發現,真正困難的地方往往不是「3D 能不能畫」,而是所有 representation 到底有沒有真的活在同一個時間裡。
三相旋轉磁場如果做成功,其實還不能證明什麼。
因為完全有可能我只是偷偷做出一個很厲害的 Three-phase Demo。
所以第二個 acceptance case 我直接換成完全不同的拋體運動。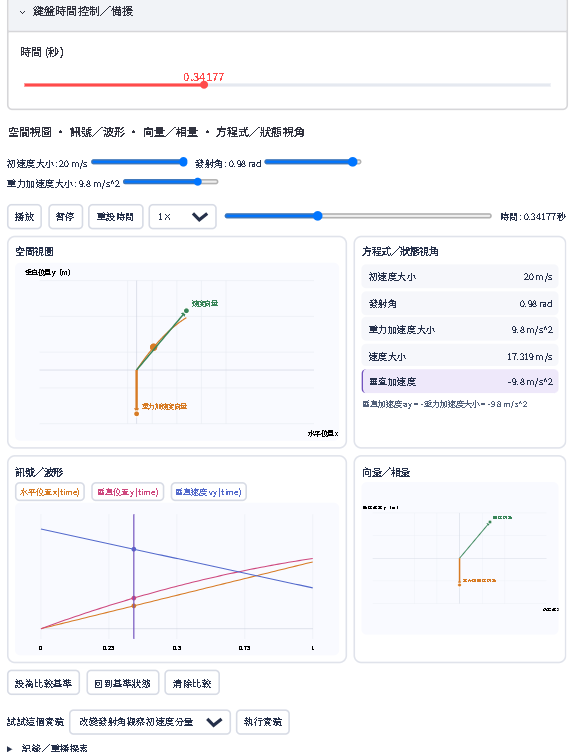
這次場景裡變成物體位置、完整 trajectory、velocity vector、gravity vector、x(t)、y(t)、速度分量,以及同一條 timeline。
結果它真的可以用同一套 runtime 跑。
這點對我來說比三相 Demo 本身更重要。
因為這代表 Spatial View 裡的物件不是「馬達專用元件」,Binding Engine 也不是只有 frequency → rotating field 這種寫死的規則。
同一套 primitive、state 和 binding 開始可以拿來描述另一個完全不同的物理系統。
不過拋體也馬上暴露下一個問題。
第一版播放到大概 1 秒就停止,但球其實還在半空。
原因是 runtime 還在用偏通用的固定時間範圍,沒有理解「這個物理事件應該在落地時結束」。
後來才把 time domain 也拉進 semantic model。拋體可以根據目前的 v0、θ、g 得到有效飛行時間,而且改參數後,timeline 的終點也應該在本機重新計算。
這其實是一個很有意思的轉變。
一開始我只覺得「動畫怎麼沒播完」。
後來才發現真正的問題是:
時間範圍本身也是物理模型的一部分。
拋體測試又抓到另一件事:參數範圍太小。
角度只能動一點點、速度也只能在 baseline 附近調,雖然技術上是 interactive,但實際上沒有太多探索價值。
所以後來又加入 Parameter Range Policy。
現在比較理想的規則是:教材本身如果給範圍,就優先尊重教材;沒有的話,再使用 validated pedagogical range;真的都沒有,才從 baseline 和參數語意決定安全 fallback。
而且像發射角這種東西,使用者應該看到的是 45°,不是 0.785 rad。內部數學照樣可以用 radians,但 UI 沒必要故意增加理解成本。
這個改動看起來很小,卻讓我開始覺得「可以操作」和「適合拿來學」其實是兩回事。
第三個測試是等速圓周運動。
結果第一次直接出現:
「互動學習場景資料不完整或不符合安全規則」。
幸好這幾天我們已經把 validator 的精確 rejection reason 留在 terminal,所以這次沒有再用猜的。
真正原因是:
Spatial projection for horizontal_axis lies outside its declared axes; axes must cover the full legal parameter/time range.
翻成人話就是:
AI 說半徑 R 可以拉到某個範圍,但它自己產生的 viewport 卻沒有大到可以容納最大合法半徑。
這個 Validator 其實擋得對。
如果 R 可以拉到 10,但畫面只顯示 -2 ~ 2,使用者一拉 slider,整個物件就飛出畫面。
所以後來又多了一層:
Parameter Range → Time Domain → Spatial Bounds → Viewport
不能讓 AI 四個地方各填各的。
而且我不希望解法變成「那就把 R 的範圍縮小」,因為這又回到前面那個問題:為了讓 Demo 看起來不壞,犧牲真正的探索能力。
比較合理的是 world 自己根據合法參數範圍決定鏡頭應該看到多大的空間。
Day 18 中間我看過很多次 unsafe。
但慢慢測下來,這些 unsafe 並不是模型在做什麼危險的事情,而是我們把 AI 生成的 Scene Spec 當成不可信輸入,所以只要有一個 expression、binding、viewport、experiment step 不符合規則,就可能被 Validator 擋掉。
例如真實測試裡陸續抓過:
t 沒有被正確視為 canonical time3.0000000000000004 > 3
set_time target/value 不符合 DSL 規則其中最後一個還暴露另一個設計問題:如果只是一個「Try this experiment」壞掉,不應該害整個 Spatial World 一起死亡。
這些都不是一開始做漂亮 Demo 時會想到的問題,但真的開始讓模型自動生成世界之後,它們就全部跑出來了。
Day 18 的 Codex prompt 非常大。
除了 Spatial Scene、waveform、phasor、shared state 之外,我還故意塞了 bidirectional binding、baseline comparison、declarative experiment、consistency checker、record/replay、第二個 domain 和安全測試。
一開始其實有點像故意看它會不會爆掉。
最後我覺得比較有意思的不是「它一次寫了多少 code」,而是過程中真的可以看到 abstraction 一層一層被逼出來。
Day 17 的 Shared Semantic State 可以直接沿用,但到了物理世界之後,又必須補 time domain、spatial bounds、parameter policy、inverse interaction、recorded state patch 等新的概念。
這一輪最後的測試結果是:
Day 18 focused tests:71 passed
完整 regression suite:143 passed
完整 regression 跑了約 142 秒,而且沒有新增 Python dependency,3D camera 也使用本地已有的 Plotly 資產。
這些數字現在對我來說滿重要,因為功能越來越多之後,我最怕的其實不是新功能失敗,而是 Day 18 做好了,結果 Day 17 的 Probability Workspace 或 Day 15 的 Interactive Lab 被我偷偷弄壞。
Day 16 的 Dynamic Simulation 已經會動。
Day 17 開始有多視圖共享 semantic state。
Day 18 則第一次讓我看到,一份教材真的有機會被轉成一個「可以操作的物理世界」。
同一個時間可以同時存在於空間位置、向量、波形和公式。
同一個參數改變,可以讓整個世界一起重新計算。
操作甚至可以反過來從 waveform 回寫到 canonical state。
還可以保存 baseline、跑一段實驗、記錄探索過程再重播。
當然它現在還不完美。3D 還不是完整立體物理世界,真實 AI 生成的 spec 偶爾還會撞上 Validator,參數範圍和 viewport 也還在持續修,而且我很清楚「三個成功案例」離真正泛化到所有工程教材還很遠。
但我覺得今天至少驗證了一件事:
Visual Learning Lab 不一定只能替教材「做一張互動圖」。
它開始有機會把教材裡的數學、時間、空間與訊號編譯成同一個可以操作的系統。
而這也是我目前最想繼續追下去的方向。


 iThome鐵人賽
 看影片追技術