

上一篇把前半段的資料流程走完:品牌與商品資料已經整理成可審核、可以被系統使用的形式。接下來換到另一端:這些資料要怎麼真的被使用者找到?這也會是接下來幾篇的新主題:Search / Ranking。
假設使用者想找這樣的商品:
想找一個適合露營用的隨行杯,最好是不鏽鋼、風格簡單。
這句話很符合人的思考方式:用途、材質和風格,很自然地被放在同一句話裡。但搜尋系統真正要使用這段資訊時並沒有想像中簡單。這篇文章想處理的是:一段自然語言進入搜尋系統後,哪些資訊要拿來判斷「相關不相關」,哪些又可以變成明確的篩選條件。
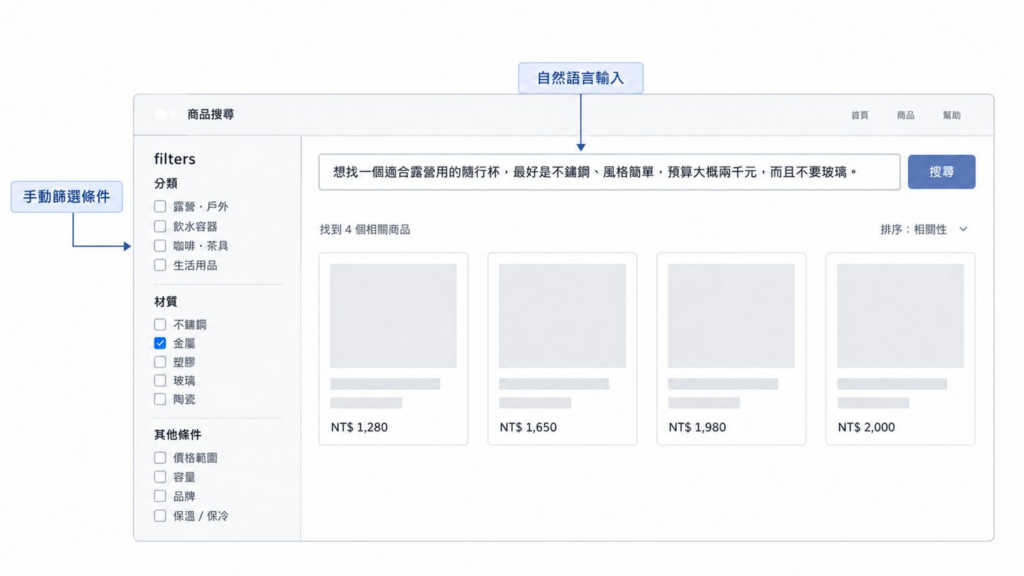
從使用者的角度來看,第一次搜尋其實很單純:先輸入一句話,讓系統找出一批看起來相關的商品。若最後搜尋得到的結果還太多、太雜,再進一步利用分類、材質等篩選條件縮小範圍。
這兩者彼此相輔相成:
自然語言主要用來判斷哪些商品比較符合使用者描述的需求;篩選條件則是在決定哪些商品可以留在這次搜尋範圍裡。
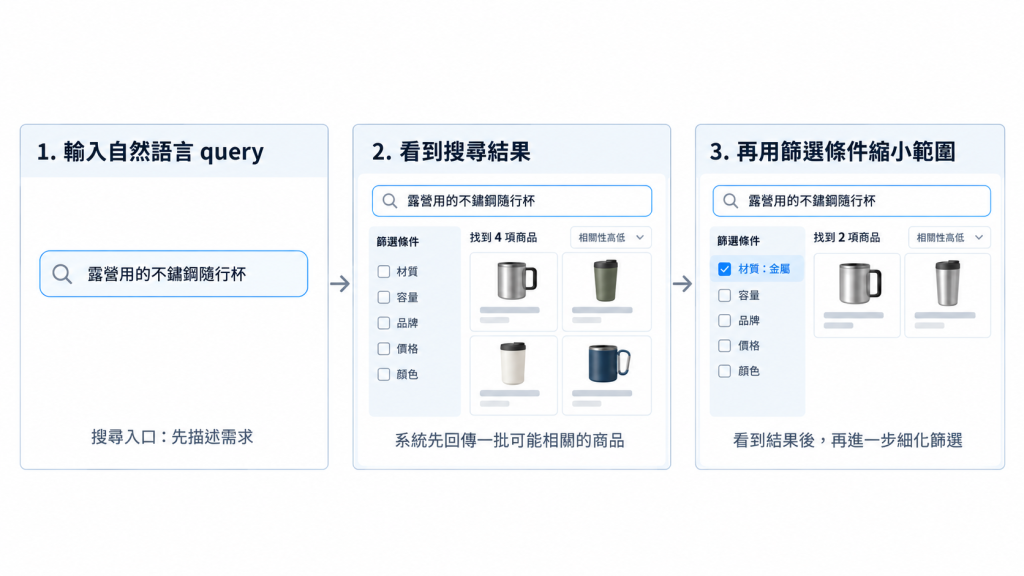
當使用者選擇「材質=金屬」時,系統不是單純把金屬商品往前排,而是直接排除不符合材質條件的商品。因此,篩選條件的判斷必須比一般的相關性判斷更保守:條件一旦設錯,使用者可能完全找不到原本應該出現的商品,而不只是排序比較後面。
回到前面的搜尋句:
想找一個適合露營用的隨行杯,最好是不鏽鋼、風格簡單。
對系統來說,這句話同時包含兩種不同性質的資訊。
所以自然語言進入搜尋後,我們其實要同時回答兩個問題:
這兩個問題在目前的實作裡會分別由意圖解析器(Intent Parser)和 embedding(向量表示)這兩條路徑處理。
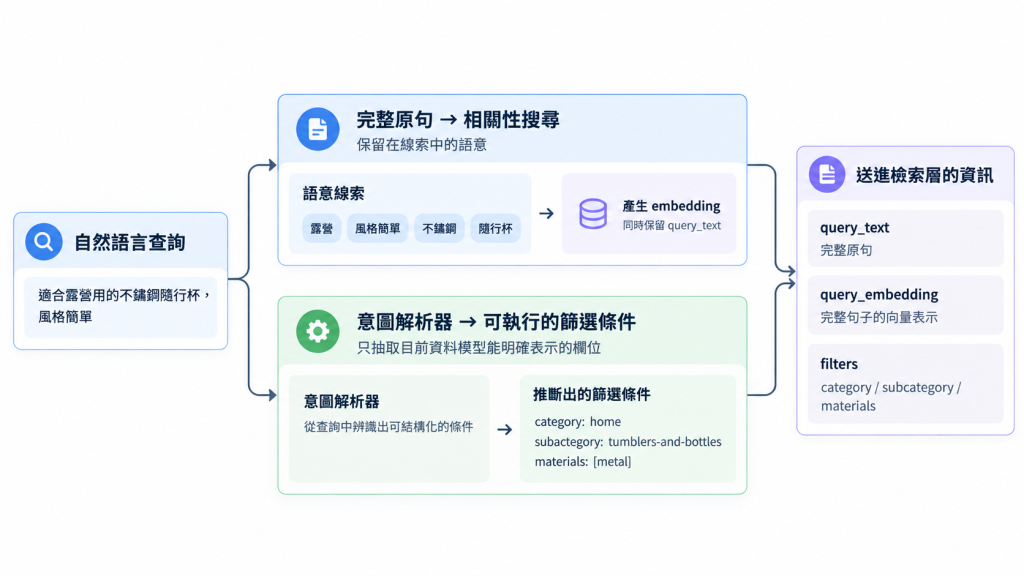
意圖解析器(Intent Parser)的工作,不是搜尋商品,也不是重寫使用者原本的句子,而是從完整 query 裡找出目前資料模型已經能夠明確表示的資訊。以本文的例子來說,「隨行杯」有機會對應到既有的 subcategory,「不鏽鋼」則有機會對應到 material 的類別。
目前的流程會把既有的 L1 / L2 分類與材質清單放進 system prompt,明確要求模型只能從這些既有值中選擇,不確定時就留空;模型的輸出再透過 Structured Outputs 與 Zod schema 驗證。
把實作簡化後,大致可以理解成:
const intentParseShape = z.object({
  category: z.enum(L1_SLUGS).nullable(),
  subcategory: z.string().nullable(),
  materials: z.array(z.enum(MATERIAL_SLUGS)),
});

const result = await client.chat({
  system: SYSTEM_PROMPT, // 提供既有分類與材質清單
  user: query,
  schema: INTENT_PARSE_JSON_SCHEMA,
  json: true,
});

const parsed = parseAndValidate(result.content, intentParseShape);
if (!parsed.success) return null;

return validateSubcategory(parsed.data);
也就是說,LLM 負責判斷自然語言和既有分類、材質清單之間的對應關係,程式則負責限制「哪些答案可以被接受」。解析成功後,一個可能的示意結果會是:
{
  category: "home",
  subcategory: "tumblers-and-bottles",
  materials: ["metal"],
}
前面我們先從 query 中抽出可以對應資料模型的明確資訊,但很多自然語言描述沒有辦法直接轉成欄位。以前面的例子來說,「適合露營」和「風格簡單」描述的是需求與情境,雖然無法直接變成篩選條件,仍然可以拿來判斷商品和這句需求有多接近。
我們會在下一篇再具體探討 embedding 的細節;這裡可以先把它理解成:把一段文字轉成一組數值表示,讓系統可以比較不同文字在語意上有多接近。
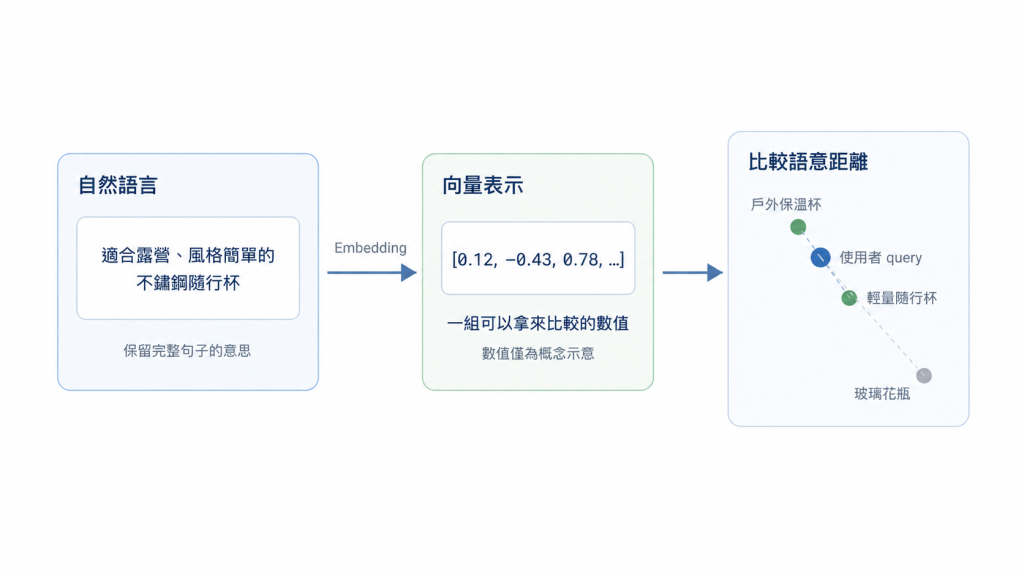
例如使用者搜尋「適合露營、風格簡單的隨行杯」,某個商品介紹裡不一定真的出現「露營」兩個字,但如果它描述的是輕量、戶外攜帶、保溫等特徵,即使兩段文字沒有完全相同的關鍵字,它們的向量表示仍可能彼此接近,讓後續的檢索系統把這件商品找出來。
前面先把兩條路各自負責什麼說清楚之後,再來看目前 codebase 的實際流程。
搜尋函式先把使用者輸入的 query 做基本 normalization,接著在 Intent Parser 啟用時,同一段完整文字會同時進入意圖解析與 embedding:
const [intentOutcome, embedResult] = await Promise.all([
  intentParsePromise,
  doEmbed(),
]);
這裡沒有「先解析 filter,再開始做 embedding」的先後關係;兩條路是並行執行的。
等兩邊都準備好之後,才把結果一起送進後面的檢索流程:
const rpcParams = {
  query_text: normalized,        // 完整原句
  query_embedding: embedding,    // 完整原句的向量表示
  filter_category: ...,
  filter_subcategories: ...,
  filter_materials: ...,
};
所以更精確的理解是:同一句自然語言,一邊被拿來找出可執行的篩選條件,一邊完整保留下來做文字與語意上的相關性判斷。如果 Intent Parser 解析失敗,搜尋也不應該整個停掉。這時只是少了系統推斷出的結構化條件,完整 query 與 embedding 路徑仍然可以繼續。
這一篇先把自然語言進入搜尋系統後的兩條路徑整理清楚:明確條件交給 Intent Parser,完整句子的語意則保留下來做 embedding。
下一篇會沿著 embedding 這條路繼續往下走。當 query 被轉成向量表示之後,我們就可以把它和商品的向量表示拿來比較,這會形成 vector retrieval(向量檢索):用語意距離找出和需求比較接近的候選商品。
不過實際的 Retrieval 並不只靠 embedding,精確的字詞仍然很有價值,因此系統還會保留 lexical retrieval(文字檢索)。下一篇會從這兩種檢索方式開始,看看它們各自擅長什麼、會漏掉什麼,以及最後怎麼透過 Hybrid Retrieval 把兩邊的候選結果合併起來。


 iThome鐵人賽
 看影片追技術