
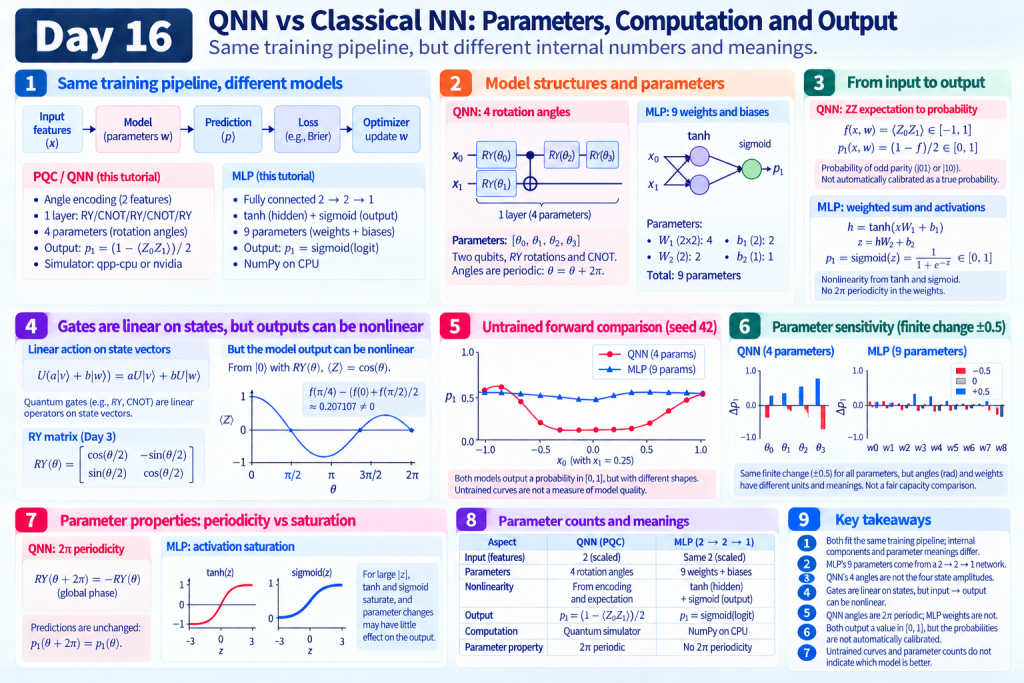
Day 15 已經能把量子電路接到分類流程。今天先不要比誰準,先問更基本的問題:兩邊看起來都能「輸入 → 預測 → 算誤差 → 調參數」,但內部的數字各自代表什麼?
把兩台都接到同一個儀表板的機器想成:一面板顯示 0 到 1 的分數。一台用齒輪與角度驅動;另一台用加權求和與壓扁函數。儀表數字長得像,不代表引擎一樣,也不能用未調校的曲線形狀判斷誰比較適合上路。
在本系列,QNN(量子神經網路)特指前幾章那種「參數化量子電路給出可訓練輸出」的模型;它能接入機器學習流程,但不是把一般神經網路的神經元換成量子位元。文獻裡 QNN 也可能指別種架構;本文聚焦 Day 14–15 的可調電路分類器。
今天用相同二維輸入與單一數值輸出介面,比較一個四參數 PQC 與九參數 MLP。程式:models.py、demo.py、experiment.py。兩者都重新初始化,不載入 Day 15 權重,不做準確率排名。
Day16 compares an untrained four-parameter PQC and a nine-parameter MLP on shared scaled inputs. Tables and checks separate linear gate action on states from nonlinear input-to-output maps, rotation periodicity from MLP weights, and ZZ-based scores from sigmoid scores—without ranking models or claiming quantum advantage.
輸入特徵 → 模型與權重 → 預測 → 計算誤差 → 最佳化器更新權重
特徵描述樣本;損失衡量差多少;最佳化器依誤差選新參數;前向計算固定參數從輸入算到輸出。
兩邊都能給最佳化器一個損失數字,但內部計算、參數意義與成本不同。NVIDIA 的 Hybrid QNN 教學示範過「一般層+量子期望值」的組合。[D15] 本日不安裝 PyTorch,也不移植該版教學的梯度程式。
| 項目 | 本日 PQC/QNN | 本日 MLP |
|---|---|---|
| 輸入 | 兩個已縮放特徵 | 同一組 |
| 內部 | RY 編碼+一層 RY/CNOT 模板 | 2→2→1 全連接 |
| 參數 | 四個旋轉角度 | 連接權重與偏差,共九個 |
| 非線性從哪來 | 角度編碼與期望值對輸入/參數的函數 | 隱藏層 tanh+輸出 sigmoid |
| 單一輸出 | p1=(1−ZZ)/2 |
sigmoid(logit) |
| 誰在算 | qpp-cpu 或 nvidia 模擬器 | NumPy 在 CPU |
GPU 後端只影響 QNN 模擬;MLP 兩次實驗都在 CPU NumPy。本日不做速度比較。
全連接層:上一層每個輸出連到下一層每個單位,每條連線一個權重;偏差(bias)再加一個常數。2→2→1=兩個輸入、兩個隱藏單位、一個輸出。
活化函數把加權和換成另一個數,讓模型能彎折:tanh 壓到 (−1,1);sigmoid 壓到 (0,1)。
h = tanh(x W1 + b1)
z = h W2 + b2
p1 = sigmoid(z)
| 部分 | 形狀 | 個數 |
|---|---|---|
| W1 | 2×2 | 4 |
| b1 | 2 | 2 |
| W2 | 2 | 2 |
| b2 | 1 | 1 |
| 合計 | 9 |
程式把九個數排成一條向量:前四個排成 W1,接著 b1、W2,最後 b2。
hidden = np.tanh(x @ w[:4].reshape(2, 2) + w[4:6])
logits = hidden @ w[6:8] + w[8]
p1 = 0.5 * (1 + np.tanh(logits / 2))
最後一行等價於 sigmoid,避免直接算巨大 exp。測試用「逐個隱藏單位手算」核對批次矩陣版,並檢查零權重輸出 0.5、只有輸出偏差時的解析結果。
這是刻意選的最小 MLP,不是為了跟 QNN「容量對等」而搜尋出來的架構。
一層模板有四個 RY 角度;兩個位元的純態也剛好有四個複數振幅——但這兩個「四」不是一對一。
白話:權重決定「怎麼轉」;振幅是轉完之後狀態裡的係數。振幅還受正規化(機率總和為 1)與整體相位(全體同乘一個長度為 1 的複數,不影響預測)約束,不能當成四個獨立神經元來調。四個角度也不等於能任意指定四個複數振幅;本例從實數 RY 出發。
CNOT 改變兩位元關係,但不新增一個浮點權重。加層會加旋轉參數與電路成本,不能直接對應成「MLP 隱藏層變寬」。
固定量子閘 U 對狀態向量是線性的:先組合再作用=先作用再同係數組合。
U(av + bw) = aUv + bUw
實驗用 Day 3 的 RY 矩陣核對。測試向量不必已正規化;這是在查矩陣性質,不是說任意組合都是合法量子態。
但從 |0⟩ 做 RY(θ) 再讀 Z:
f(θ) = cos(θ)
f(π/4) − [f(0)+f(π/2)]/2 ≈ 0.207107
θ → f(θ) 不是線性。θ 若再依賴輸入 x,整條「輸入 → 編碼 → 電路 → 期望值」也可以對 x 彎折——不必在振幅上硬塞一個 tanh。
請分開三句話:
U 對狀態向量:線性ψ† O ψ;對密度矩陣:Tr(ρ O) 線性不要簡化成「量測=ReLU」或「量子閘=非線性神經元」。本例精算期望值就會出現上述彎折,不需要靠抽樣噪音才產生。
單一 RY 角度加 2π,該閘只差整體相位 → 本例預測不變;測試會逐個權重核對。MLP 的連接權重沒有同樣的 2π 週期。
輸入很大或很小時,tanh/sigmoid 會貼近上下限(飽和),某些參數改了輸出幾乎不動。QNN 也可能因狀態、閘或可觀測量而不敏感。本日只做固定點的有限步長掃描,不是梯度、可訓練性或貧瘠高原的證據。
實驗固定特徵 [0.25, -0.4]、種子 42,對每個參數加 −0.5/0/+0.5:QNN 12 組、MLP 27 組,共 39 組。兩邊參數單位不同,相同改動量不是公平容量比較。
| QNN 的 p1 | MLP 的 p1 | |
|---|---|---|
| 怎麼來 | ZZ 奇數同位性機率(兩位元剛好不同) | sigmoid 分數 |
| 能接分類損失嗎 | 能 | 能 |
| 自動校準成「真機率」嗎 | 否 | 否 |
Day 15 已展示某個已訓練 QNN 可完成小型 XOR。本日畫的是未訓練模型:固定 x1=0.25,x0 從 −1 到 1。曲線彎、平或貼近 0.5,不代表好壞。
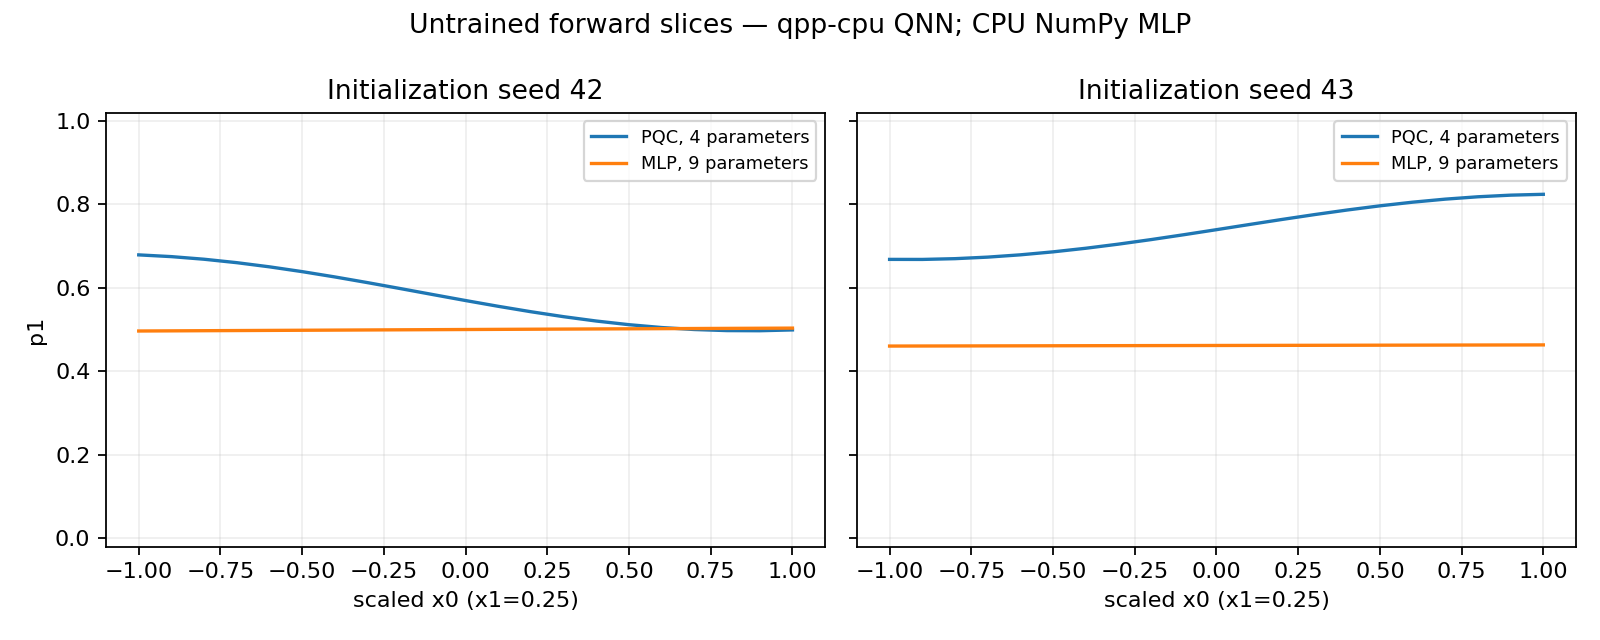
兩種子都用 normal(0, 0.2) 初始化,但參數個數與意義不同;相同種子≠對等起點。圖上沒有標籤、損失或準確率,不能評估泛化。單筆示範(種子 42、[0.25,-0.4])約為 QNN p1≈0.100、MLP p1≈0.502——只是起點不同,沒有勝負。
沿用 .venv 與 Day 15 繪圖套件;固定依賴見 requirements-day16.txt。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day16/demo.py
OMP_NUM_THREADS=1 python articles/day16/demo.py --features -0.5 0.25 --backend nvidia

OMP_NUM_THREADS=1 python articles/day16/experiment.py
OMP_NUM_THREADS=1 python articles/day16/experiment.py --backend nvidia
OMP_NUM_THREADS=1 python articles/day16/plot_results.py
OMP_NUM_THREADS=1 python articles/day16/plot_results.py --backend nvidia
每個後端:2 種子 × 21 個輸入 → 42 組 QNN/MLP 前向比較,加上上述 39 組參數反應。QNN 與 NumPy 參考核對;MLP 由單元測試核對矩陣實作。
輸出:results/day16/<backend>/predictions.json、parameter_response.json、summary.json、forward_comparison.png。可用 --output-dir /tmp/day16-check 另存。
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day16 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY16_TARGET=nvidia python -m unittest discover -s articles/day16 -p 'test_*.py' -v
六個測試涵蓋:MLP 偏差/手算參考/輸入契約、初始化與不變性、QNN 週期與參數反應,以及「狀態線性/角度輸出非線性」的區分。數字見 實驗紀錄。
本日在同一訓練介面下,把 QNN/MLP 的參數語意、線性/非線性層次、週期性與輸出定義分開核對。未訓練曲線或參數個數不能用來判定「誰比較強」。沒有梯度訓練、QPU、速度評比或量子優勢驗證。
Day 17 談梯度怎麼取得;Day 18 才做較公平的經典/量子效能比較;Day 19 談混合模型。
[D15] NVIDIA Hybrid Quantum Neural Networks(CUDA-Q 0.8.0 教學):一般層與量子期望值整合的歷史範例;不作本日 API/梯度正確性依據。查閱日期 2026-09-07,環境 CUDA-Q 0.15.1。
MLP 與線性代數公式均明示並測試;QNN 重用 Day 14。索引見 REFERENCES.md。
[N5] Brian Coyle et al. “Training-efficient density quantum machine learning.” npj Quantum Information 11, 172 (2025);研究論文。原始來源;完整書目。
本章釐清傳統運算與量子量測在模型裡的角色;此研究提供另一種組合方式,可協助區分「模型怎麼接」與「梯度怎麼算」應分開說明。


 iThome鐵人賽
 看影片追技術