
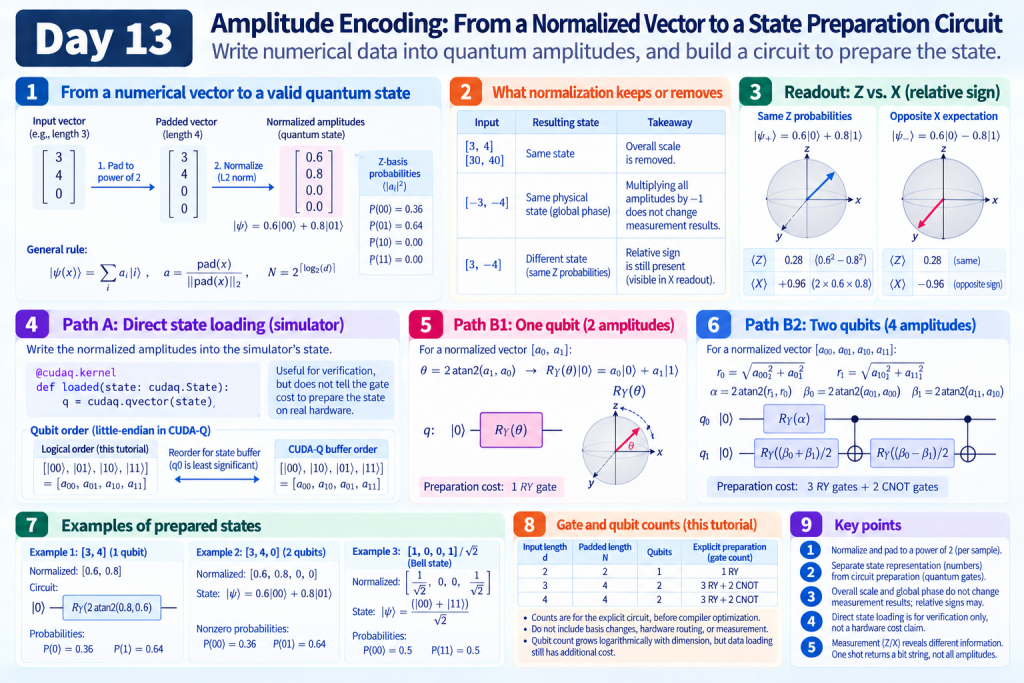
Day 12 把每個特徵轉成一個旋轉角度。今天換一條路:把整筆數字寫進量子態的係數(振幅),並回答兩個常被混在一起的問題——
打比方:先在紙上寫好一份「合法食譜」(係數加總後機率為 1),再進廚房照步驟做出那道菜(量子閘序列)。紙上寫完,不代表菜已經上桌;模擬器若直接把狀態「貼進記憶體」,也還不算告訴你硬體上要付多少閘成本。
程式:amplitude_encoding.py、demo.py、experiment.py。範圍限定 2–4 個有限實數,支援負數與零分支;不支援任意複數或更高維的通用閘分解。
Day13 separates amplitude representation from circuit preparation for short real vectors. Normalization, padding, simulator state loading, and an explicit RY/CNOT preparation are checked against each other on CPU and GPU simulators. The chapter records qubit counts and gate counts without claiming QPU loading costs, classification accuracy, or quantum advantage.
一筆特徵向量就是排好順序的幾個數字。振幅編碼把它們寫成狀態的係數。係數本身不是機率;絕對值平方才是 Z 基底量測機率。機率總和必須是 1,所以要先正規化。
步驟:長度為 d 的非零向量,先在尾端補零到最接近的 2 的次方長度 N = 2^ceil(log2(d)),再除以 L2 長度(各分量平方和再開根):
a = pad(x) / ||pad(x)||₂
|ψ(x)⟩ = Σ_i a_i |i⟩
因此長度 3 補到 4;長度 4 不用補。這與 CUDA-Q 文件的振幅編碼定義一致。[D5] 本日邏輯順序仍是 |q0 q1⟩:
[3,4,0] → [3,4,0,0] → [0.6,0.8,0,0]
|ψ⟩ = 0.6|00⟩ + 0.8|01⟩
P(00)=0.36,P(01)=0.64
每筆資料各自正規化,沒有把整個資料集合併成一個狀態,也不使用 Day 11 那種逐欄最小/最大值縮放器。
amplitudes, metadata = normalize([3, 4, 0])
metadata 記錄轉換過程,不是新的振幅。實作先除以最大絕對值再求長度,降低極大/極小數直接平方造成的溢位或下溢。全零向量長度為 0,無法當除數;NaN、Inf、錯誤維度與複數輸入一律拒絕。d = 2,3,4 是本日閘實作範圍,不是振幅編碼的一般上限。
| 輸入 | 結果 | 白話 |
|---|---|---|
[3,4] 與 [30,40] |
相同狀態 | 整體大小被拿掉了 |
[-3,-4] 與 [3,4] |
只差整體相位(全乘 −1) | 任何量測預測都一樣,算同一物理態 |
[3,-4] 與 [3,4] |
Z 機率相同,狀態不同 | 相對正負號還在 |
若任務需要原始大小,必須在一般程式另外保存長度,或改設計表示方式。
相對符號可用 X 期望值看見:一個位元的 [3, ±4] 得到約 ±0.96;補成四維後讀最後一個邏輯位元的 X1,也是 ±0.96。保真度衡量兩態有多像(本例用正規化向量內積絕對值平方):
|0.6² − 0.8²|² = 0.0784
實驗同時保存精算 X、量測計數與保真度,避免只看機率表而漏掉符號錯誤。
state = simulator_state(amplitudes)
result = cudaq.get_state(loaded, state)
@cudaq.kernel
def loaded(state: cudaq.State):
    q = cudaq.qvector(state)
這是把已算好的振幅寫進模擬器記憶體再讀回,方便核對「表示對不對」。它沒有告訴你:若要在真實量子處理器(QPU)上準備同一態,需要多少閘。不能因為 Python 只寫一行,就說硬體載入成本固定。
CUDA-Q 狀態緩衝區以 q0 為最低有效位。[D3] 本日邏輯順序是 [00,01,10,11],兩位元載入前要重排成 [a00,a10,a01,a11];取出時用 State.amplitude(label) 轉回邏輯順序。測試會逐一載入四個基底態,專門檢查這個邊界。
若只有兩個數,正規化後是 [a0, a1]:
θ = 2 atan2(a1, a0)
RY(θ)|0⟩ = a0|0⟩ + a1|1⟩
atan2(y, x) 依平面座標求角度,能分辨正負與象限,比單靠 acos(a0) 更適合含負數的例子。這條路徑只要 1 個 RY。
對 [a00, a01, a10, a11],先算兩個分支的長度:
r0 = sqrt(a00² + a01²)   # q0=0 的 00、01
r1 = sqrt(a10² + a11²)   # q0=1 的 10、11
α  = 2 atan2(r1, r0)
β0 = 2 atan2(a01, a00)
β1 = 2 atan2(a11, a10)
某分支長度為 0 時,對應的 β 設為 0(該分支沒有振幅),不是對所有輸入都忽略符號。
先用 RY(α) 決定 q0 兩個分支的權重,再讓 q1 在 q0=0 時轉 β0、在 q0=1 時轉 β1。可檢查的電路寫法:
q0: ──RY(α)──────────────●────────────────────●──
                        │                    │
q1: ──RY((β0+β1)/2)──────X──RY((β0−β1)/2)─────X──
q0=0 時,q1 兩次旋轉加起來是 β0;q0=1 時,兩次 CNOT 讓其中一次角度反號,結果是 β1。
ry(angles[0], q[0])
ry(angles[1], q[1])
x.ctrl(q[0], q[1])
ry(angles[2], q[1])
x.ctrl(q[0], q[1])
沒有呼叫通用狀態準備函式庫。此分解也能做出 [1,0,0,1]/√2 的貝爾態(不能拆成兩個獨立單位元純態),與 Day 12 那種「每位元各自轉一下」的乘積態不同。
| 本例維度 | 補零後振幅 | 量子位元 | 明確準備電路(原始計數) |
|---|---|---|---|
| 2 | 2 | 1 | 1 RY |
| 3 | 4 | 2 | 3 RY+2 CNOT |
| 4 | 4 | 2 | 3 RY+2 CNOT |
這是原始電路計數,不含:量測前換基底、硬體繞線、編譯後可能刪掉的多餘閘。特殊輸入下,編譯器可能消掉部分旋轉或 CNOT,表格不是所有編譯輸出的精確帳單。
主控端還要讀完整特徵向量、驗證、補零、正規化——這些陣列工作隨長度增加。位元數隨維度對數成長,不代表整條載入流程也只有對數成本。[D13] 本日只做到兩個位元,不用小例子外推任意高維資料。
另外:硬體每次抽樣通常要「再準備一次再量測」;模擬器可從已算好的分布抽樣。一次 Z 結果只是一個位元字串,讀不回全部振幅與符號。換成 GPU 模擬也不改變這個量測限制。
沿用 .venv;固定依賴見 requirements-day13.txt。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day13/demo.py
OMP_NUM_THREADS=1 python articles/day13/demo.py --values 1 -2 3 -4
OMP_NUM_THREADS=1 python articles/day13/demo.py --values 0 0 -3 4 --backend nvidia

OMP_NUM_THREADS=1 python articles/day13/experiment.py
OMP_NUM_THREADS=1 python articles/day13/experiment.py --backend nvidia
示範會印出正規化振幅、角度、明確電路圖、機率與保真度。每個後端實驗 12 組案例,涵蓋 2/3/4 維、尺度倍數、整體/相對正負號、不同基底、零分支與貝爾態。
每組用「直接載入」與「明確電路」兩路徑對照目標狀態;明確電路另算精算 X,以及 1,000 次 Z 量測計數。結果在 results/day13/<backend>/:predictions.json、summary.json、circuit.txt。可用 --output-dir /tmp/day13-check 另存。
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day13 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY13_TARGET=nvidia python -m unittest discover -s articles/day13 -p 'test_*.py' -v
六個測試涵蓋:正規化與輸入檢查、錯誤與極端有限值、尺度/整體相位、相對正負號、四個基底載入順序、固定種子的隨機含號向量與零分支。數字見 實驗結果。
本日把振幅表示與電路準備分開核對,用 X 讀出檢查相對符號,並分層記錄位元數、前處理與閘計數。少位元能裝很多振幅,仍要把資料載入成本算進去;不能宣稱已在硬體上免費載入資料。這是無雜訊模擬器上的驗證:沒有 QPU 實測、沒有分類準確率、沒有載入速度排名,也沒有量子優勢宣稱。
Day 14 會把角度編碼與振幅編碼接到同一套可調電路與訓練介面。
State.from_data。索引見 REFERENCES.md。
[N6] Kevin W. Aoun et al. “Quantum State Preparation via Neural Network Encoding in Quantum Machine Learning.” arXiv:2605.31006v1 (2026);預印本。原始來源;完整書目。
本章區分振幅表示與實際狀態準備;這篇研究提供用神經網路產生電路參數的案例,方便比較「寫出目標態」與「建立準備電路」的成本。


 iThome鐵人賽
 看影片追技術