

在軟體開發的世界裡,我們經常落入「快樂路徑 (Happy Path)」的陷阱。開發者看著分類器達到 93.3% 的準確率、狀態機通過了測試、前端介面點擊順暢,便以為大功告成。然而,當專案從開發環境移至真實世界,許多看似完美的 AI 專案會在一瞬間崩潰:一封包含敏感資訊的郵件、一次短暫的服務中斷,就能讓整條流程斷裂且無從追蹤。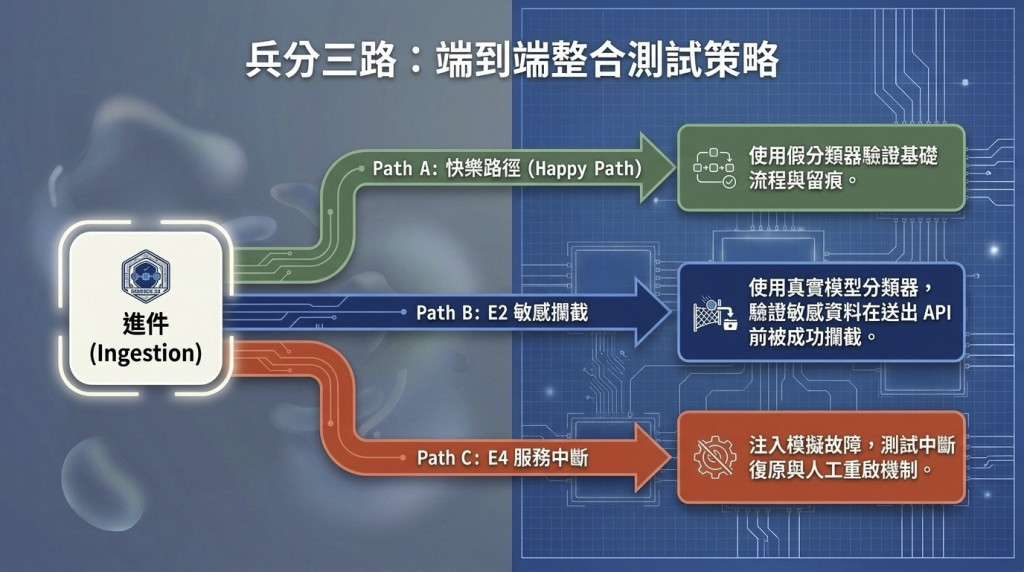
身為架構師,我們必須識別一個核心事實:系統的強度並非由它「能做什麼」決定,而是由它的「邊界」在哪裡決定。我們目前建構的,究竟是一個精美的技術展示 (Demo),還是一個具備韌性的系統?真正的系統與 Demo 的差別,平常看不出來,唯有在面對異常時,那層治理與架構的底蘊才會顯現。
一個 Demo 的特徵是快樂路徑跑得很順,但對於「非快樂路徑」卻往往交不出答卷。例如:當敏感信息進入流程時會發生什麼?當服務中斷後案件流向何方?各模組間的留痕紀錄是否能對齊?
如果驗收測試只專注於一切正常的狀況,那本質上只是在自欺欺人。系統的真實價值在於它如何面對「不快樂」的時刻,例如敏感攔截或服務中斷。這些在開發過程中可能被視為邊緣案例的異常路徑,才是檢驗系統完整性的關鍵指標。
> Demo 跟系統的差別,平常看不出來,出事的時候才看得出來。
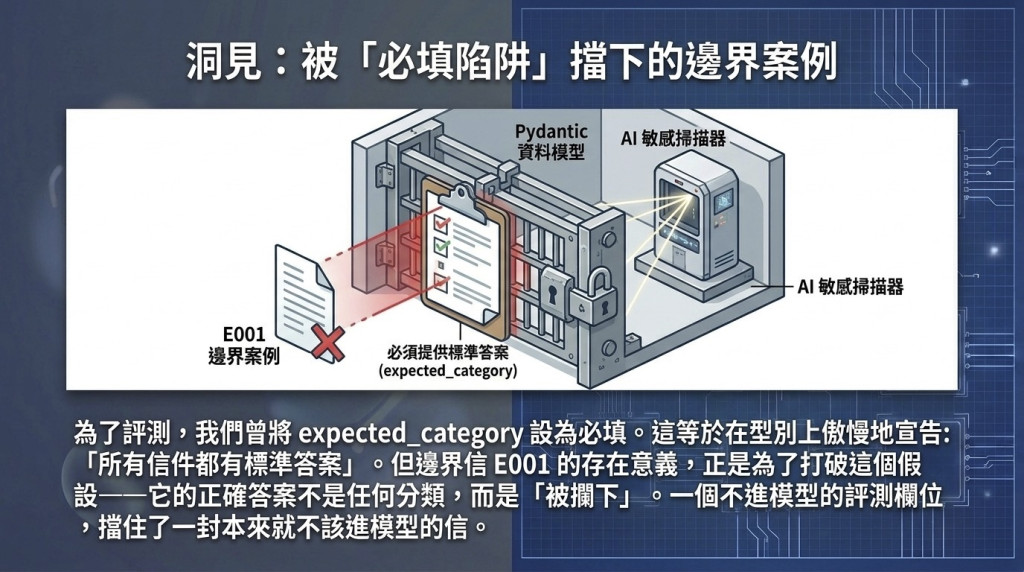
在開發 AI 系統時,我們常會過度理想化資料模型,忽略了現實世界的混雜性。以 SyntheticEmail 的模型設計修正為例,這是一個關於技術負債與「資料契約 (Data Contract)」的深刻教訓。
最初,我們為了便利評測,將「評測標註 (expected_category)」設為必填欄位。在處理標準測試集時運作良好,但當遇到邊界案例(如 E001 郵件)時,系統直接噴出 pydantic.ValidationError。諷刺的是,這個欄位在注記中寫著「評測用,不進模型輸入」,但它卻因為過於僵化的型別約束,擋住了一封本來就不該進入模型的郵件。
這告訴我們:邊界案例的存在意義正是要打破開發者的假設。將評測標註改為「選填」不僅是修正 Bug,更是承認「並非所有資料都有標準答案」。一個成熟的系統,必須學會與這些無法定義的資料共存。
在 AI 輔助流程中,為了追求測試速度,開發者常會用腳本模擬人工審核。但在真正的系統治理中,「人工確認」必須是一條物理上無法繞過的紅線。
在我們的驗收腳本中,核准動作不再是程式模擬,而是必須由真人在終端機上手動輸入姓名(如「王博仁」)與決定 (y/n)。這個動作產生的決定,會連同審核人的身分與時間戳記,確實寫入留痕紀錄中。這種不可代按的機制確保了治理功能的真實性——當出事需要追溯時,我們看到的不是一串自動化的 Log,而是「某月某日由王博仁核准」的真實責任鏈結。
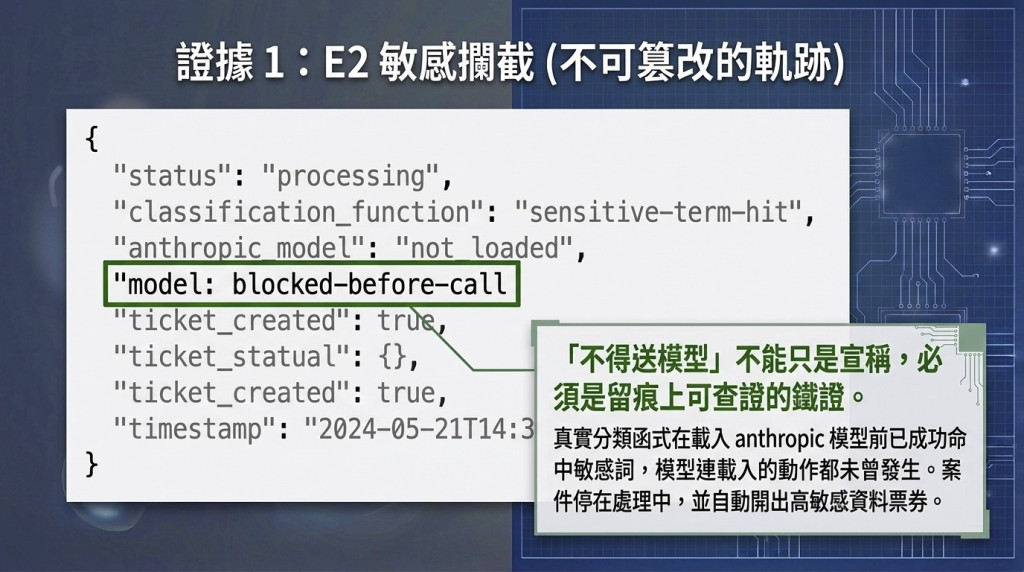
在驗收 E2(敏感攔截)測試時,一項關鍵的挑戰是證明系統「沒有」執行某些動作。真正的系統不僅要記錄發生了什麼,更要能查證「該被攔截的是否真的沒發生」。
在處理高敏感資料時,我們必須在呼叫 AI 模型之前就執行攔截。這時,留痕紀錄中的 blocked-before-call 欄位就變成了技術治理的鐵證。它不是一個口頭宣稱,而是一個具備證據力的留痕,證明敏感資料連載入模型的機會都沒有。
> 「不得送模型」不是宣稱,是留痕上可以查證的欄位。
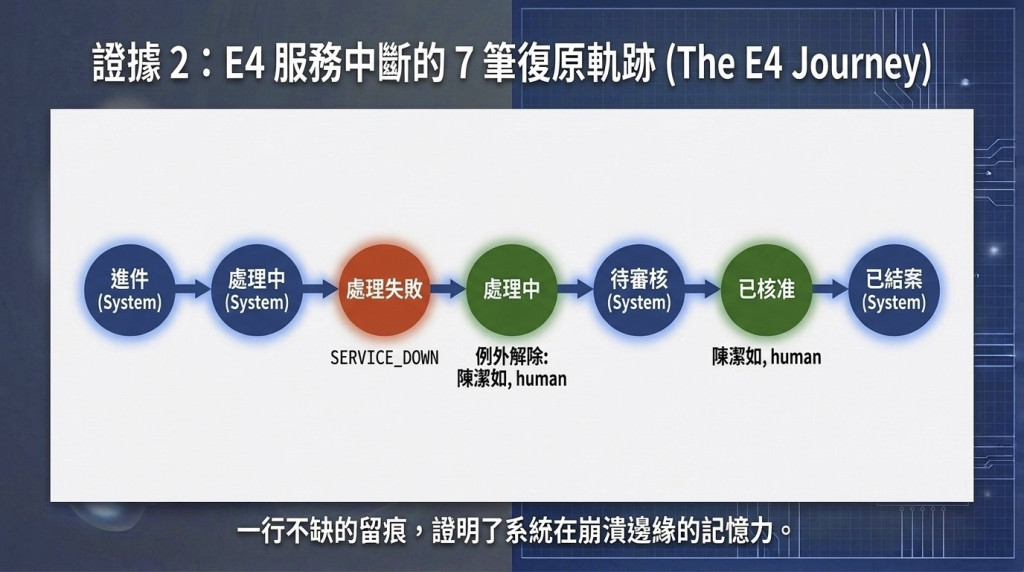
失敗本身並不可怕,可怕的是失敗後留下的資訊斷層。在 E4(服務中斷)的驗收中,我們看到了一段極具透明度的「人機協作」旅程。透過 7 筆連續的留痕紀錄,我們能清晰還原事件現場:
「中斷是系統記的,重啟是人做的。」這段旅程展示了當技術失靈時,系統如何引導人類介入並完成閉環。一致的跨模組留痕,是區分「拼湊而成的 Demo」與「治理嚴謹的系統」的終極指標。
判斷一個 AI 專案是否具備「系統」雛形,我有三條明確的判準:跨模組留痕是否一致、例外是否有去處、以及人工判斷點是否真的繞不過去。
然而,身為專業的架構師,我們也必須誠實地揭露系統的邊界。目前的設計仍處於概念驗證 (PoC) 等級:它還是單人單執行緒、審核人身分仍靠自填、服務中斷仍是模擬注入。承認這些限制並非軟弱,而是專業的表現——知道自己在哪裡,才能規劃如何走向正式營運 (Production-ready)。
在追求 AI 準確度的同時,請反思:你的系統是否已經準備好面對它失敗的那一刻?


 iThome鐵人賽
 看影片追技術