
功能開始跨前端、Worker 後端、Cloudflare D1 資料庫、身份狀態與快取之後,Debug 很容易變成一場猜謎。
使用者只看到一個錯誤畫面,AI 卻可以立刻提出很多可能:
每一個都可能。
問題是,如果一開始就同時追六個方向,模型越會推理,反而越容易把 Context 塞滿,最後得到一個「聽起來很合理」但沒有被證據支持的故事。
Debug 的第一步不是找最像答案的原因,而是用證據把可能出錯的系統範圍一層一層縮小。
工程上常把這個「仍可能出錯的範圍」稱為 fault domain。
Day 11 提過 fresh 員編登入的案例。
畫面最後被導向不預期的 LINE 流程,看起來很像 Auth 壞掉;但沿著資料流往下看,使用者看到的症狀,和最早出錯的那一層,不一定相同。
Day 15 的主案例更直接。
2026-09-21 的便當系統曾在建立訂單時回傳 MUTATION_CONFLICT。如果只從錯誤名稱出發,很容易先懷疑:
但 repo 的 changelog 已經留下確認原因:
系統把不同版本菜單整理成當日可用結果時,沒有保留資料庫既有的
menu_item_id,後續反而拿到臨時產生的 ID。建立訂單時,這個 ID 找不到對應的持久化資料,資料庫外鍵檢查失敗,最後才以MUTATION_CONFLICT浮到上層。
這個事件真正值得留下來的,是下面這個差異:
使用者看到 MUTATION_CONFLICT
≠
最早出錯的位置就在 mutation conflict handling
畫面上的錯誤,只是最後被觀察到的症狀。
遇到這類跨層問題,我會先問三題:
1. 哪一層最早出現「預期值 ≠ 實際值」?
2. 前一層輸出的資料是否仍然正確?
3. 後面的錯誤是不是只是在投影前面已經發生的問題?
我要找的是 first diverging point。
第一次看到這個詞,可以把它直接理解成:
預期資料和實際資料第一次開始不一樣的位置。
以 9/21 這次事件來看,Debug 若只盯著最外層的 MUTATION_CONFLICT,範圍仍然很大。
把資料流攤開後,問題可以改寫成:
資料庫既有餐點
→ 菜單整理層
→ 建立訂單時使用的餐點 ID
→ Worker 建立訂單明細
→ D1 外鍵檢查
→ MUTATION_CONFLICT
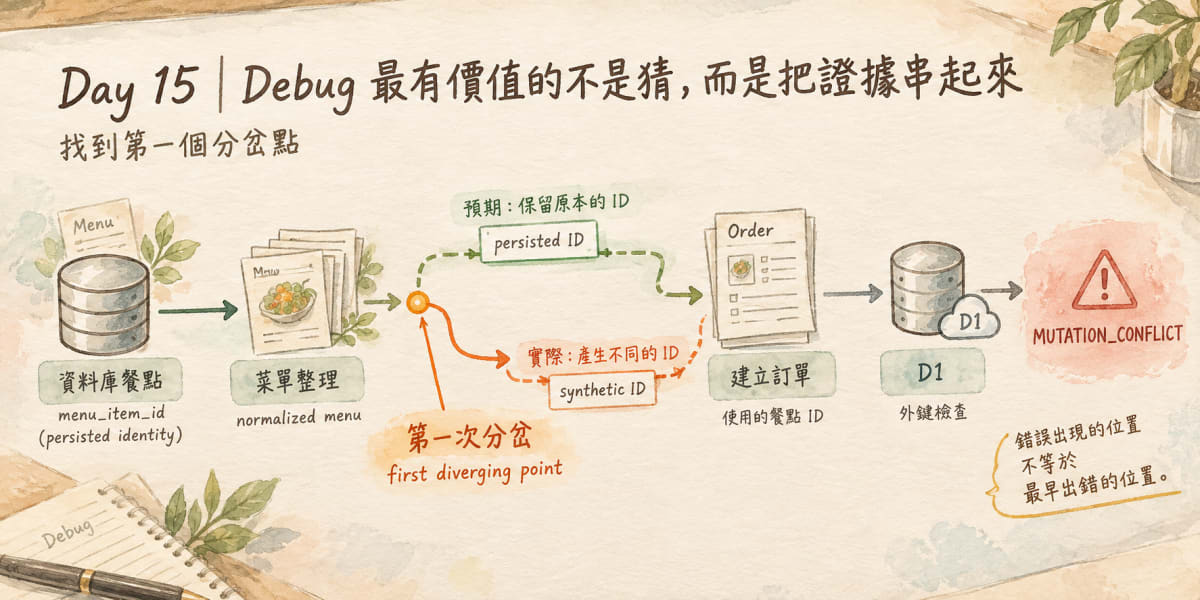
已確認的 changelog 指出:資料庫裡原本的餐點 ID 並沒有被正確帶過整理層,後續流程拿到的已不是同一個 menu_item_id。
這時 first diverging point 就往前收斂到:
資料庫原始餐點 ID
        ↓
菜單整理層
        ↓
餐點 ID 在這裡開始分岔
一旦找到這個點,後面的 foreign-key failure 和 MUTATION_CONFLICT 就比較像「後果」,而不是第一個該修改的地方。
Evidence-first Debug 的重點不在收集更多 log,而在讓每一份 Evidence 都能刪掉一部分可能性。
如果只根據畫面上的錯誤,調查初期可以先列出幾個待驗證的候選假設:
Hypothesis A
order mutation 的 concurrency guard 誤判。

Hypothesis B
calendar / menu 狀態讓這筆訂單變成非法操作。

Hypothesis C
menu identity 在進入 mutation 前已經和 persisted data 分岔。
接著不要問「哪個最像」,而是問每個假設需要什麼證據。
A 需要:
- mutation guard 的輸入
- version / state 是否真的衝突

B 需要:
- 當日 calendar / menu effective state
- 該餐點是否仍可被訂購

C 需要:
- persisted menu_item_id
- normalized overlay 輸出的 menu item identity
- 寫入 order_items 前實際使用的 ID
當已確認的 Evidence 指向「整理層沒有保留原本的 menu_item_id」,其他候選方向就不需要再和這條線用相同優先級繼續追。
Debug 的進度可以直接看「還剩多少可能」:
原本有三個可能,現在只剩一個仍和 Evidence 一致。
這種方法在 Production Data 上更重要。
看到 foreign-key failure,最危險的反應之一,是直接把它理解成「資料壞了」,然後準備修 D1。
但這次 incident 反而提醒我:
資料庫拒絕一個不存在的 synthetic ID,本身可能是在正確保護資料。
如果資料庫裡原本的餐點資料沒有問題,需要修的是中間層如何傳遞餐點 ID,而不是先改 Production Data 去配合錯誤的結果。
所以碰到資料問題時,我會先要求唯讀檢查:
能先用 read-only Evidence 排除的,就不要先用資料修改來猜答案。
「可能是 session 有問題」太寬,因為它沒有告訴下一步要查什麼。
比較可操作的寫法是:
Hypothesis:
normalized overlay 沒有保留 persisted menu identity,
導致 order mutation 使用不存在的 menu_item_id。

Evidence needed:
- persisted menu_item_id
- overlay output identity
- mutation input identity
Evidence 一旦與假設衝突,就刪掉這條線。對 AI 來說,工具結果因此不只是「多一份資訊」,而是能直接剪掉搜尋空間。
Agent Debug 常為了避免漏看,先把所有疑似相關檔案讀進 Context;這有時必要,但不該是第一步。
比較有效的順序是:
畫面上的症狀
→ 最近可觀察的狀態
→ 產生這個狀態的 function / API
→ 上游整理層
→ 原始資料來源
每走一層只問一件事:
這一層的輸出,和預期還一致嗎?
找到 first diverging point 後,已證明正常的區域就能退出調查。這同時省 Context,也降低「剛好讀到某段程式碼,就把它誤認成 root cause」的機會。
9/21 這次 incident 最後留下的修正很有代表性:
菜單整理層應保留資料庫既有的 menu_item_id。
這個修改範圍和 Evidence 對得上。
不需要因為錯誤最後出現在 mutation path,就順手重寫 mutation protection;也不需要因為碰到 foreign key,就去改 schema 或 Production data。
可以把這個原則寫成:
symptom
↓
trace
↓
first diverging point
↓
root cause supported by evidence
↓
smallest justified mutation
這裡的 smallest justified mutation,可以直接理解成:
只修改目前 Evidence 足以證明需要修改的最小範圍。
這也和前幾天的 Scope / Contract / Regression 串得起來:Debug 負責找出「哪裡真的錯」,而不是替一次 incident 打開新的重構範圍。
AI 很擅長補出完整 causal story;工程上更重要的是,這個故事能不能被觀察結果逐段支持:
root cause 能解釋症狀?
↓
和實際 Evidence 一致?
↓
修改後,原本分岔的 Evidence 恢復?
如果三題還答不出來,狀態就應該留在「仍在調查」。
Day 15 最後留下四條規則:
好的 Debug,會讓還可能成立的答案越來越少,而不是讓猜測越來越漂亮。
下一篇會再往 Production 前進一步:root cause 找到、bounded change 完成後,什麼樣的 Evidence 才足以讓 Worker-only 變更直接部署?
這是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app


 iThome鐵人賽
 看影片追技術