
Day 16 的 Worker-only fast path 有一條很明確的排除條件:
不碰 schema,不碰 Production Data。
不是因為 SQL 比 JavaScript 更難,而是資料一旦被改寫,風險不只在「能不能 rollback」。
2026-09-21,我對便當系統的正式 D1 做了一次唯讀 ledger 稽核。結果掃過:
balance_ledger;最值得注意的是另一個結果:
最新一筆依 sequence 排序的 ledger balance,和
users.balance在全體使用者上完全一致。
如果只檢查「現在餘額有沒有對上」,這批資料看起來甚至是正常的。
問題藏在歷史裡。
這 3 個錯誤起點都是 ORDER 扣款。
正常情況應該是:
前一筆 balance_after
+ 本次 amount
= 新的 balance_after
但實際看到的是:
前一筆餘額 800
本次扣款 -100

預期 balance_after = 700
實際 balance_after = -100
另一筆則是:
前一筆餘額 1015
本次扣款 -100

預期 balance_after = 915
實際 balance_after = -100
這些紀錄顯示,舊 writer 很可能沒有從前一筆 ledger balance 往下算,而是從過期或接近零的 users.balance 開始。
Repo 沒有保存「交易發生當下實際讀到的 users.balance 快照」,因此無法直接重播那次讀取;但依 sequence 重建交易鏈,可以確認偏差就是從這幾筆開始。
後續交易即使各自加減正確,只要沿用已經錯掉的餘額,偏差就會一路往後傳:
錯誤起點
→ 下一筆沿用錯誤餘額
→ 後續交易繼續沿用
→ users.balance 最後也更新成錯誤的鏈尾
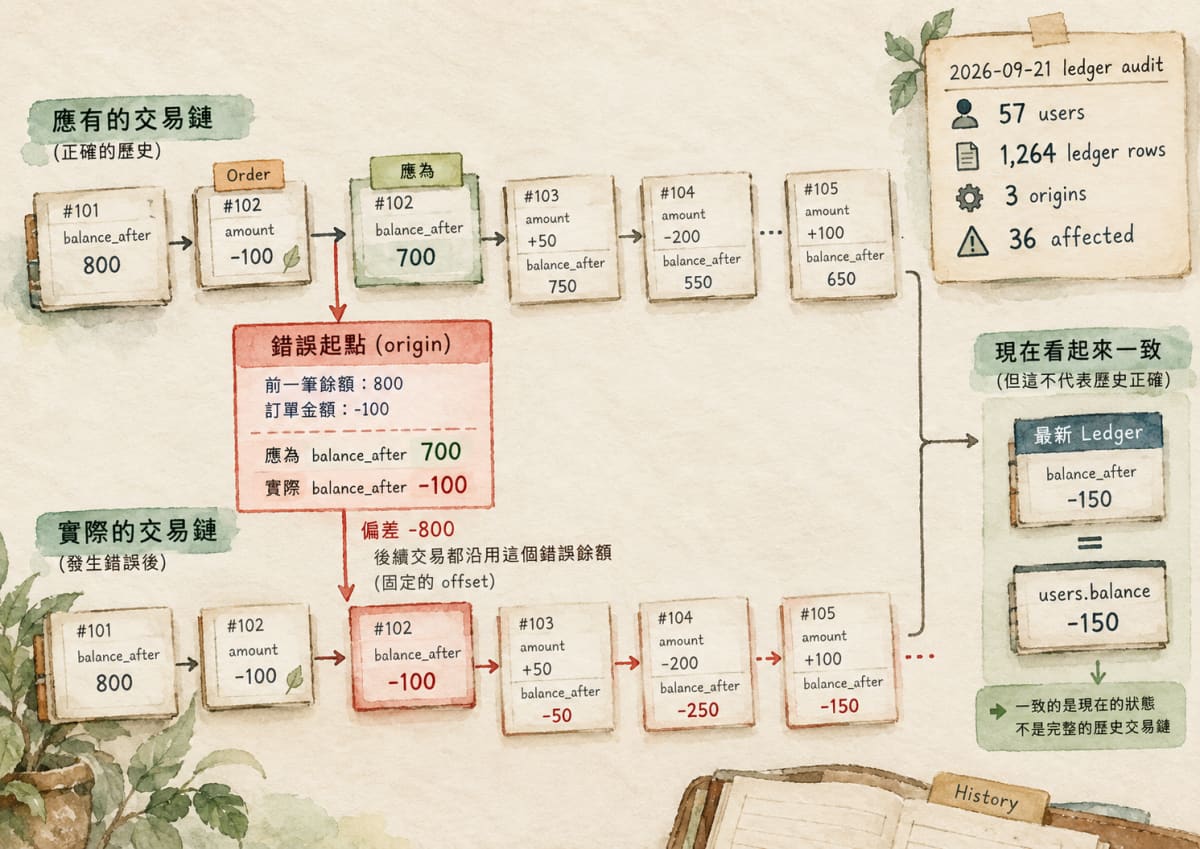
正文圖若用單一交易鏈說明,只負責示意「固定偏差如何往後傳播」;圖中的交易編號與單筆餘額不是某一位使用者的完整 Production ledger。真實稽核範圍仍以前文的 57 位使用者、1,264 筆 ledger、3 個錯誤起點與 36 筆受影響交易為準。
於是會出現最危險的狀態:
現在看起來一致,但歷史其實已經不一致。
users.balance 可以把它理解成方便查詢的餘額鏡像(mirror);這次稽核則以有 sequence 的 ledger 作為交易順序依據。
如果 mirror 已經跟著錯誤鏈尾更新,它和 ledger 一致,只能證明「兩邊現在指向同一個值」,不能證明歷史計算過程正確。
Production Data correction 前,第一個問題因此不是:
哪個欄位要 UPDATE?
而是:
哪一份資料有資格回答「事情當時是怎麼發生的」?
Day 15 的 Evidence-first Debug 到了 Production Data,多了一層後果:判錯資料權威,不只是修錯 bug,還可能把原本可追溯的歷史一起改掉。
Migration 很容易把兩件事黏在一起:
新增欄位
→ 順便把舊資料補滿
其實這是兩個不同決策:
新資料從今天開始,需要什麼 schema?
以及:
過去沒有記錄的資訊,現在有沒有足夠 Evidence 可以回填?
新增可為空的欄位(nullable field),主要影響之後怎麼寫新資料;把所有舊資料的 NULL 猜成某個值,則是在重新解釋過去。
如果舊系統當時根本沒有保存那個語意,NULL 至少誠實表示「不知道」。為了讓資料看起來完整而補上一個推測值,可能把不確定性改寫成不存在的確定答案。
這裡只需要留下這個邊界;歷史資料本身如何成為 Evidence Boundary,後面再另外談。
這次稽核後,其實可以算出一份修正預覽。
因為 3 個錯誤起點的 offset 已知,理論上可以對後續受影響的 balance_after 移除同一段偏差,而不改交易金額、類型、reference 或 timestamp。
例如:
origin delta = -800

後續受影響的 balance_after
都移除這個 -800 offset
數學上不複雜,真正要決定的是:
要不要修改歷史 ledger 本身?
Repo 因此保留兩種策略評估。
balance_after好處是能讓 ledger chain 恢復數學連續。
代價也很直接:
好處是舊 row 不動。
但它不能讓過去錯掉的 balance_after 重新變正確,還可能改變月報加值、扣款與期末餘額的解讀。
所以 append-only 並不等於一定比較正確。
技術上能補一筆,不代表語意上已經修復。
這次 incident 可以拆成兩個目標:
Future correctness
之後的新交易要從正確的餘額來源計算

Historical fidelity
過去哪裡已知、哪裡不確定,要如實保留
前者可以靠 code fix 解決。
便當系統已把共用 ledger mutation 改成優先使用依 sequence 建立的餘額投影;只有沒有 sequenced ledger 時,才退回使用 users.balance。
這能避免新的交易再從過期 mirror 開始。
但它不會自動回答:
舊的 36 筆 affected transaction 要不要重寫?
那是另一個決策。
把 future correctness 和 historical fidelity 分開,才能避免「修好之後」和「重寫過去」被一支 migration 綁成同一件事。
這類 Production Data 問題,我更希望 AI 先做唯讀分析:
這次 repo 裡的 repair proposal 也刻意只做到 SELECT-only preview,沒有直接變成 repair script。
最危險的捷徑不是 SQL 寫錯,而是:
看起來有規律
→ AI 可以推算
→ 直接把推論寫回歷史
分析可以很快,Production Data 的修改權限仍然要另外決定。
Day 16 的 fast path 排除 schema / Production Data,這次 ledger incident 給了很具體的理由:
Code rollback
通常可以重新部署上一版

Schema rollback
有時可以 DROP / ALTER / restore

Historical rewrite
可能改變「我們認為昨天發生了什麼」
對持續累積交易與餘額的系統,更重要的問題不是每個欄位是否乾淨,而是:
這個數字為什麼會變成現在這樣?
只要這條因果還能被重建,資料才仍然有可稽核的歷史。
下一篇會離開資料歷史,改看另一個 Production 邊界:同一份 Code 在 localhost 與遠端環境裡,為什麼可能得到完全不同的結果。
這是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app


 iThome鐵人賽
 看影片追技術