

Day 15 把 Debug 拉回 Evidence:先找到 first diverging point,再只改證據足以支持的範圍。
但修對,不等於可以直接上線。
接下來遇到的問題更現實:
這次修改已經被驗證,而且只碰 Worker backend,還需要每一次都停下來重新問「要不要部署」嗎?
我沒有把答案做成「Production 一律人工確認」,也沒有走到「測試過就自動 deploy」。
便當系統最後長出來的是一條更窄的路:
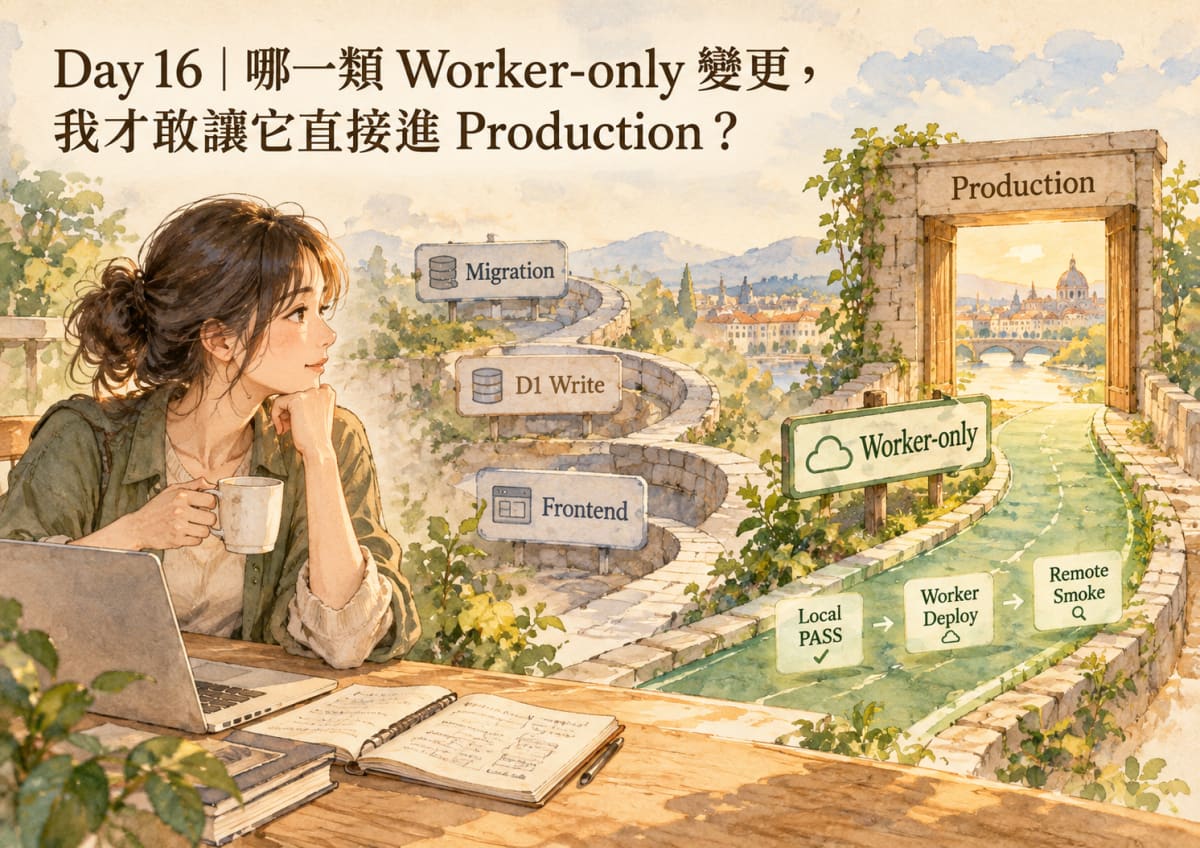
只有範圍被限制清楚的 Worker-only 變更(bounded Worker-only change),才有資格走快速部署路徑(fast path)。
這裡要判斷的是:這類變更是否已經被限制到足以直接前進。
如果只看一句:
tests PASS
資訊其實遠遠不夠。
同樣是測試通過,下面兩種修改的 Production 風險完全不同:
A.
只改 Worker route / domain logic
不碰 schema
不寫 remote D1
不改 frontend
部署後可用 read-only smoke 驗證

B.
新增 migration
回填 Production Data
同時改 frontend
改 auth / authorization semantics
兩者不能因為都叫「測試通過」就走同一條 Release Path。
fast path 先被限制成:
scope 已經明確
→ Worker backend only
→ local / targeted verification(本機/針對性驗證)PASS
→ 沒有 schema / migration
→ 沒有 remote D1 data mutation
→ 不部署 frontend
→ 不改重大 auth / security semantics
→ deploy 後可以用遠端冒煙測試(remote smoke)補 Production runtime evidence
只要其中一項不成立,就退出這條快車道。
便當系統的 Worker 文件已經把這類限制寫進真實工作流程。
例如 repo 裡一個「暫時身份轉正式身份」的綁定流程(provisional employee claim),計畫明確限制:
不 merge main、不 deploy frontend;只有本機實作驗證通過後,才允許 Worker-only remote smoke。
對應的 design 也把 Remote smoke checkpoint 寫得更具體:
implementation
→ local verification
→ deploy formal Worker only
→ 不 deploy frontend
→ 不做 manual remote cleanup
→ 用真實 remote flow 驗證
→ smoke 不符預期就停止
這個順序把部署放進一條連續的驗證鏈:本機測試完成,只代表 source-level Evidence 已成立;遠端 runtime 還需要自己的證據。
這一點很容易在 AI 協作裡被模糊掉。
當 Agent 跑完:
它很容易產生一個語意過大的結論:
已驗證,可以完成。
但 repo 的 Current State 對 Production Boundary 寫得很清楚:
可以直接寫成:
Local verification PASS
≠
Production runtime VERIFIED
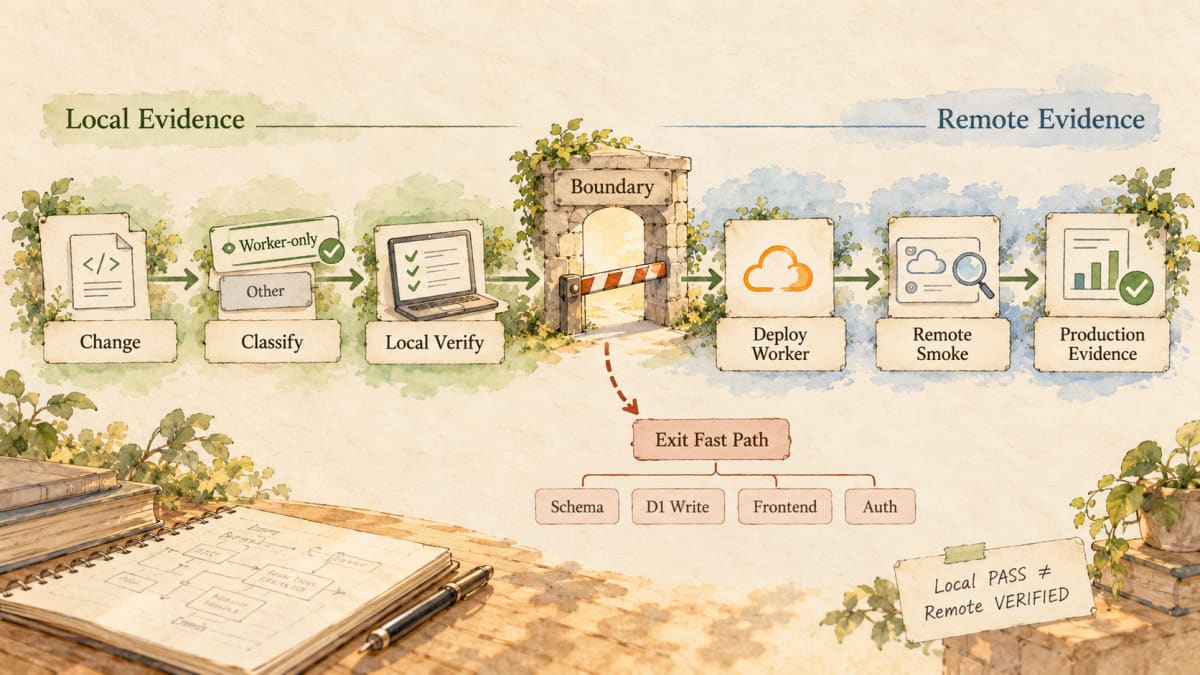
這中間還缺一塊遠端執行證據,這才是 smoke test 要補的位置。
部署後的 smoke test 不需要重做整套 regression。
它回答的是:
這份已驗證的 source,進入真正 remote runtime 後,最核心的假設還成立嗎?
例如 Worker 文件對 CORS 的要求,是在 authorized backend deploy 後,用 read-only smoke 確認 deployed Worker 的 preflight 與實際 response 都能被瀏覽器讀取。
另一條身份流程則要求 deploy formal Worker 後,再用 remote flow 檢查:
三種 Evidence 應該分開看:
Targeted test
證明這次改動的局部 contract

Regression
證明已知業務行為沒有被破壞

Remote smoke
證明已部署 runtime 的核心路徑真的活著
三者各自支撐不同的 claim,不能互相替代。
「低風險修改」這個說法太模糊,更有用的是直接看幾個可觀察的邊界:
Mutation surface 小嗎?
Authority 有變嗎?
資料 schema 有變嗎?
Production Data 會被重寫嗎?
Frontend / backend 要一起切嗎?
失敗後能否直接重新部署上一版?
部署後是否有便宜、read-only 的驗證方式?
只要這些條件能回答得很清楚,才有可能談 fast path。
因此規則不能簡化成「Worker 改動可以自動部署」。更精確的版本是:
只有當變更範圍、資料副作用、權限語意與遠端驗證方式都被限制清楚,Worker-only 才可能進入快速部署路徑。
「不部署 frontend」看起來只是少改一層,實際上會大幅縮小問題空間。
如果 Worker 和 React 同時變:
source change
→ API contract
→ browser bundle
→ hosting
→ cache
→ frontend state
→ Worker runtime
remote smoke 一旦失敗,就要重新判斷錯在 browser 還是 backend。
但 Worker-only change 把前端固定住後,Production 驗證可以更集中:
既有 frontend / client expectation
        ↓
新 Worker
        ↓
既有 D1 contract
少一個 deployment surface,就少一組「哪一邊才剛改過」的不確定性。
這反映的是 fast path 必須刻意減少同時變動的 surface(變更面);問題不在 frontend 或 backend 誰比較危險。
以下任何一項出現,就退出這條 Worker-only fast path:
最後一點尤其重要。
如果 smoke 失敗,正確反應應該是:
STOP
→ 保留失敗 evidence
→ 找出不一致
→ 修 source / config / contract
→ 重新驗證
相反地,不該變成:
smoke FAIL
→ 手動修 remote data
→ 畫面看起來正常
→ 宣告完成
後者會直接破壞 Evidence chain。
AI 讓改 Code 變快之後,很容易把「更快」理解成少一點確認。進入 Production 後,實際需要的是分流:
要保留速度,就要避免讓所有變更都排同一個 Gate。
可以被限制成 Worker-only、沒有資料改寫、沒有 schema、沒有 frontend、可以 remote smoke 的修改,就走窄的 fast path。
一旦碰到資料歷史、migration、跨 frontend deployment 或 authority semantic,就切回更高摩擦的路徑。
這樣 Production governance 才能避開兩個極端:
每件事都很慢

或

每件事都相信 AI
更實際的做法是:
先分類
→ 再決定需要多少 Evidence
→ 再決定能走多快
Day 16 留下的工程判斷是:是否能直接部署,不該只靠一次性的人工直覺,而要由變更類型與 Evidence 共同決定。
下一篇會處理這條 fast path 明確排除的一類:Schema 與 Production Data。
因為 Code 可以重新部署,但歷史資料一旦被改寫,系統對過去的理解不一定能一起 rollback。
這是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app


 iThome鐵人賽
 看影片追技術