
🧰 工具一多,定義會占掉 Context,名字像的也更難分。先把這個 Agent 用不到的拿掉;剩下的常用幾支一直給,其餘先只給名字、用到再載入;搜不搜得到、選不選得對,還是看名稱和說明分不分得開。
昨天在 Day 14,我們把退款工具改成收品項、金額由後端算,回傳和錯誤訊息講清楚做了什麼、為什麼被拒;也看到 MCP 工具進了 Harness,跟內建工具放在同一張工具表,模型拿到的是同一種定義。
快速回顧一下:Day 8 講過,工具定義排在每次 request 的最前面,每一輪都跟著送出去;Day 10 提過,Claude Code 在支援的模型上預設延後載入工具。今天要接著看的是:工具多到兩百支,模型當下該看到哪些。
假設退款的 MCP server 改好之後,團隊把它接回自己寫的客服 Agent,同時接上 CRM(記客戶資料和往來紀錄的系統)、會員系統(帳號和 App 站內信)、郵件和監控的 MCP server,加起來兩百多支工具。這個 Agent 的 loop 每次呼叫模型,都把全部工具定義放進 request,客戶還沒開口,input 就先有好幾萬 token。
王小明那張單照 Day 14 處理完,耳機殼退了 230 元,耳機開了換貨單。他最後說:「好,那把退款怎麼算的跟換貨單號寄到我信箱,我等下再看。」能把東西送到客戶手上的工具有三支:郵件系統的 send_email、會員系統的 send_member_message、CRM 的 create_email,說明各只有一句。收件人照 Day 14 的做法由 Harness 帶入,參數只有主旨和內文。
我照 Day 14 的方式,用 Claude Code v2.1.280 當 Harness 模擬:接上那四支改好的退款工具和這三支假工具,關掉 tool search(Day 10 提過的延後載入),讓工具定義每輪整份送;兩百多支沒有真的接,只接了這 7 支。每次開新的 session,把王小明在 Day 14 說的兩句和最後這句依序送進去,跑了 5 次:
send_email 寄出去。4 次沒寄,跟王小明說沒辦法確定信會寄到他的信箱,請他自己截圖保存;理由是三支都只能填主旨和內文,看不出會寄給誰。send_member_message 發了 App 站內信,回他「這個工具沒辦法直接寄到外部 email,所以用站內信的方式傳給您」。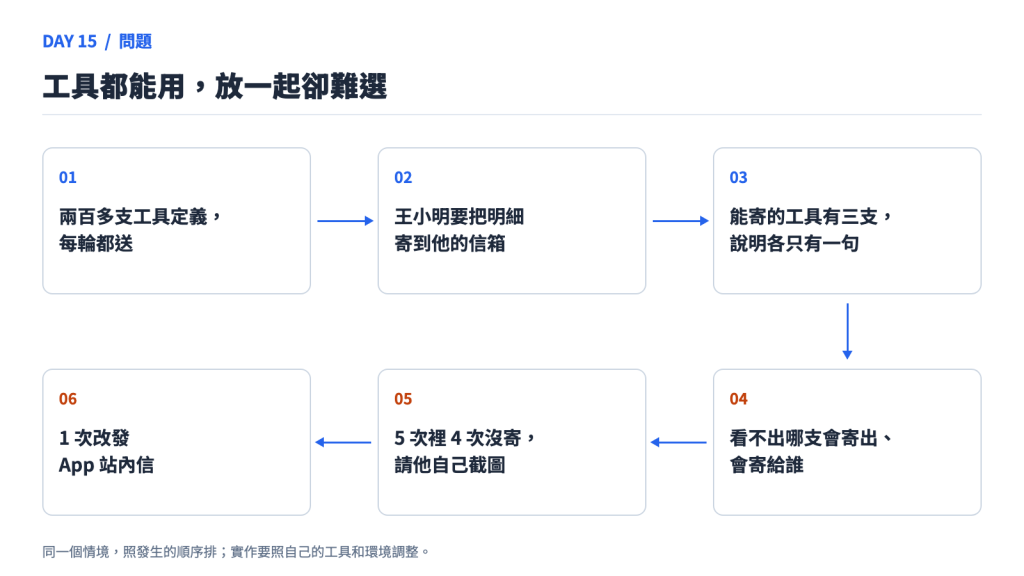
圖:兩百多支工具定義每輪都送 → 王小明要把明細寄到他的信箱 → 能寄的工具有三支,說明各只有一句 → 看不出哪支會寄出、會寄給誰 → 5 次裡 4 次沒寄,請他自己截圖 → 1 次改發 App 站內信。這是示意,實作要照自己的工具和環境調整。
三支的說明都沒寫錯,只是沒寫會不會真的寄出、寄給誰。這裡有兩件事:每輪都在付兩百多支定義的 token;要寄東西給客戶時,模型面前又有三支看起來都可能對的工具。兩件事都從同一個地方開始:一個退款客服 Agent,被接上兩百多支大多用不到的工具。
下面先看工具一多要付出什麼,再看 Claude Code 怎麼先只給名字、用到再載入,以及搜到之後怎麼選對、哪些該拿掉或合併;接著對照其他幾種做法、看自己寫的 Agent 怎麼照做,最後看沒搜到和選錯怎麼分開查。
模型每次被呼叫,手上的工具定義都跟著 request 送進去,包含名稱、說明和參數格式。工具越多,這段越長。Anthropic 介紹 tool search 的工程文章算過一組常見的 MCP 設定:GitHub、Slack、Sentry、Grafana、Splunk 五個 server 共 58 支工具,對話還沒開始就用掉約 55K token;他們內部還看過工具定義在優化前吃掉 134K token。
Day 8 的 cache 能讓每輪重送的定義便宜一點,但定義還是占著 Context,模型也還是得在全部工具裡挑。同一篇文章說,最常見的失敗是選錯工具和填錯參數,名字相近的時候特別容易,例如 notification-send-user 和 notification-send-channel。Claude API 的 tool search 文件也寫,可用的工具超過 30 到 50 支,Claude 挑對工具的能力就會下降。
所以工具多有兩個代價:每輪都要付的 token 和延遲,還有選錯或選不出來、事情沒做成的那幾次。開頭那兩件事剛好各占一個。
Claude Code 內建的做法叫 tool search。它的 MCP 文件寫得很直接:session 開始時只載入工具名稱和 server 提供的使用說明,完整定義等 Claude 需要時才載入,所以多接幾個 MCP server,對 Context 的影響很小。這個功能預設開著,模型要是 Sonnet 4.5、Haiku 4.5、Opus 4.5 或更新的版本。
一次搜尋的流程是這樣:
session 開始
  └─ 模型手上:常用內建工具的完整定義、ToolSearch、其他工具的名字
王小明要把明細寄到信箱
  └─ 模型呼叫 ToolSearch,用關鍵字找,或直接點名要哪幾支
       └─ 回傳 tool_reference:只帶工具名字的參照
            └─ API 把參照換成完整定義,接在對話後面
                 └─ 模型讀到說明和參數,才呼叫 mcp__mail__send_email
session 一開始,模型手上沒有那兩百支的說明和參數,只知道有哪些名字,還有一支叫 ToolSearch 的搜尋工具。
王小明要把明細寄到信箱,模型手上卻只有寄信工具的名字,就呼叫 ToolSearch。它可以給關鍵字,也可以直接點名要哪幾支。
搜尋回來的是一串 tool_reference,每個只寫著一支工具的名字。Claude API 的文件說明,API 會把這些參照換成完整定義再交給模型,而且接在對話後面,前面已經 cache 的內容不動。Day 10 說的「工具清單有變動時只會追加在後面」,就是這一步。
模型讀到完整說明之後,才呼叫業務工具。其他沒被搜過的工具,從頭到尾只占一個名字的位置。
我在 Claude Code v2.1.280 接了三個假的 MCP server,每個放一支開頭那種寄東西的工具,不載入我自己的設定,再用 /context(列出 Context 各部分占多少 token 的指令)看。tool search 開著和關掉各跑一次,擷取相關的幾列:
預設(tool search 開著)
System tools               7.6k
MCP tools (deferred)       171
System tools (deferred)    13.1k

ENABLE_TOOL_SEARCH=false
System tools               23.2k
MCP tools                  172
標 (deferred) 的,是只放了名字、定義還沒載入的部分。三支假工具的說明很短,加起來一百七十幾 token,看不太出差別。差別在 Claude Code 自己的內建工具:開著時一開始只載入 7.6k,另外 13.1k 等用到再載入;關掉就全部一開始載入,是 23.2k。Agent SDK 的文件寫明,Bash、Read、Edit 這些核心工具一律先載入,其他內建工具跟 MCP 工具一樣可以延後。
接著照開頭的方式再跑,這次 tool search 開著,三支換成改過的說明(下一節列出來),一樣開新的 session 跑 5 次。紀錄檔裡看得到:第三句進來,Claude 先呼叫 ToolSearch,參數直接點名三支工具的全名,回來三個 tool_reference;讀完三支的說明,5 次都用說明裡寫著會真的寄出的 send_email 寄信,其中 1 次寄完再用 create_email 在 CRM 補一筆紀錄。名字像的三支,它每次都全部載入來比。
幾個會改變這個行為的設定:
| 情況 | 結果 |
|---|---|
不設 ENABLE_TOOL_SEARCH(預設) |
MCP 工具全部延後,用到再載入 |
設成 auto 或 auto:5 |
MCP 工具定義加起來不到 Context 的 10%(或 5%)就一開始載入,超過才全部延後 |
設成 false |
全部一開始載入 |
某個 server 設 alwaysLoad: true |
這個 server 的工具一開始就載入,不管上面怎麼設 |
ANTHROPIC_BASE_URL 指到非官方的 host |
預設關掉,多數 proxy 不會轉送 tool_reference |
舊版的預設不一樣:2026 年 1 月 v2.1.7 的 changelog 寫的是超過 Context 10% 才延後,也就是現在 auto 的行為。alwaysLoad 要省著用,文件提醒每支一開始就載入的工具,都會吃掉原本可以留給對話的 Context;Claude API 的文件建議留三到五支最常用的,其他延後。
tool search 處理的是第一個代價。第二個它管不到:三支名字都像,它就三支一起載入,選哪支還是看說明。
搜不搜得到也看同樣的東西。Claude API 內建的兩種搜尋,比對的都是工具名稱、說明、參數名稱和參數說明。Day 14 寫清楚的那些字,在這裡同時決定找不找得到、選不選得對。Anthropic 談怎麼寫工具的文章也提醒,工具功能重疊或用途模糊,Agent 會搞不清楚該用哪一支。
先把說明寫到分得開。三支原本的說明和改過的放在一起看:
改之前
send_email            寄 email
send_member_message   發訊息給會員
create_email          幫聯絡人建立一封 email

改之後
send_email            寄 email 給目前這位客戶,會真的寄出;退款、訂單這類要留紀錄的通知用這支
send_member_message   發 App 站內信給目前這位會員,客戶登入 App 才看得到;用在提醒和行銷,不用在退款通知
create_email          把一封信記進 CRM 聯絡人的往來紀錄,不會寄出;只在信已經從別處寄出、要補紀錄時用
Claude API 的工具定義文件要說明寫出工具什麼時候該用、什麼時候不該用,改之後每支都多了這一句。「不會寄出」這幾個字,讓模型不用猜 CRM 那支是寄信還是記錄。真的 CRM 也是這樣:HubSpot 的 email API 文件第一句是「log and manage emails on CRM records」,建一筆 email 只是記進聯絡人的往來紀錄。
前面那次實驗用的是改之後的說明。換回改之前的,tool search 一樣開著,再跑 5 次。三種設定放在一起:
| tool search | 說明 | 5 次的結果 |
|---|---|---|
| 關(開頭那組) | 改之前 | 4 次沒寄,請王小明自己截圖;1 次發成站內信 |
| 開 | 改之前 | 三支都載入了,5 次都沒寄:4 次請他自己截圖;1 次沒回王小明,反過來問操作的人哪支會寄到客戶的信箱 |
| 開 | 改之後 | 5 次都用 send_email 寄出,1 次另外在 CRM 補一筆紀錄 |
開著 tool search 還是沒寄的那 5 次,理由跟開頭一樣:三支都只有主旨和內文,說明也沒寫會寄到哪裡;其中 2 次還提到,CRM 那支看不出會不會真的寄出。所以開不開 tool search,說明分不開,就一樣選不出來。改之後的說明寫了「給目前這位客戶」(收件人由 Harness 帶入)和「會真的寄出」,這兩個疑問就沒再出現。每種設定各跑 5 次,只看得出方向。
名字也幫得上忙。Anthropic 那篇建議用前綴分組,照服務分(asana_search、jira_search),也照資源分(asana_projects_search、asana_users_search)。他們也提到,前綴還是後綴對評測結果影響不小,而且每個模型不一樣,名字怎麼取要拿自己的任務測。
Claude Code 已經自動在前面加上 server 名,模型看到的是 mcp__mail__send_email、mcp__members__send_member_message、mcp__crm__create_email。前綴看得出工具來自哪個系統,看不出哪一支會真的寄出,這還是要靠說明。CRM 那支要是自己包的,改叫 log_email,看名字就知道只是記錄。
那讓 Harness 直接告訴模型用哪支呢?Claude API 的 tool_choice 可以指定這一輪呼叫哪支工具,但工具定義文件寫明 Opus 5.5、Sonnet 5.5 這些新模型不支援,送了會回 400,只能用預設的 auto(讓模型自己挑),靠 prompt 去影響。我在開頭那組設定的 system prompt 多加一句「寄 email 給客戶用 send_email」,說明不改,跑了 4 次(模型是 Opus 5.5),4 次都用 send_email 寄出。模型夠強,一句提示就夠。
但我覺得問題出在更前面。寫得出這句提示,代表寫 Harness 的人早就知道寄信該用哪支,那另外兩支本來就不該出現在這個 Agent 面前:退款客服用不到 CRM 的記錄工具和站內信,更用不到監控。而且兩百多支裡,名字像的不會只有這一組,提示得一組一組寫。Harness 管得住的是 tools 裡放哪些,模型挑哪支它只能提示。
把公司所有的 MCP server 都接上來,這個設計本身就有瑕疵;靠說明、提示和延後載入,只是在補洞。延後載入留給真的需要很多工具的 Agent,像 Claude Code 這種什麼都可能要做的;任務固定的客服 Agent,先把用不到的拿掉。真的要接很多 MCP server,也可以只開放其中一部分工具:Cloudflare 的 MCP server portal 把好幾個 MCP server 接在同一個網址後面,管理者照用途一支一支開關工具,也可以預設全部隱藏、只開名單上的。
拿掉之外,重疊的也可以合併。哪幾支該合,有兩種跡象。
第一種是幾支工具都繞著同一樣東西。Anthropic 那篇的例子是把 get_customer_by_id、list_transactions、list_notes 三支改成一支 get_customer_context,一次把客戶最近的相關資料整理好回傳。GitHub 官方的 MCP server 2026 年 1 月也這樣合過:Actions 原本的 16 支合成三支,actions_list、actions_get 查,actions_run_trigger 負責觸發、重跑、取消,要做哪個動作用 method 參數選。
合的時候,他們還是把查詢和會動東西的分開。我覺得這樣權限才分得開:在 Claude Code 裡用 deny 規則(權限設定裡的禁止規則)擋掉 actions_run_trigger,查詢的兩支照樣能用;查詢和觸發全塞進一支,就只能整支留或整支拿掉。
第二種是紀錄裡幾支工具總是照同一個順序接著呼叫。Anthropic 那篇也說,常常串在一起的幾個步驟可以包成一次呼叫。通知就能這樣做:退款 Agent 只接 send_email,要在 CRM 留紀錄的話,讓 send_email 寄出後在背後記一筆,模型不用知道 CRM 那支。
順序固定,中間卻要等人決定的,還是要留成兩支。Day 14 把試算和退款拆開,就是因為金額會影響王小明要不要取消;合成一支,就沒有地方停下來等他回覆。
工具一多怎麼處理,我看到的開源實作大致分成四種,差在模型一開始手上有什麼、要用某支工具時怎麼拿到:
| 做法 | 模型一開始手上有什麼 | 要用某支工具時 | 可以看的開源實作 |
|---|---|---|---|
| 全部先給 | 每支工具的完整定義 | 直接呼叫 | Gemini CLI |
| 先給入口,搜到再載入 | 一支搜尋工具,有的再附上工具名字 | 先搜,搜到的定義才進 Context | Codex CLI、langgraph-bigtool |
| 讓模型寫程式呼叫 | 工具變成程式裡的函式 | 寫一段程式把幾支串起來,在 sandbox 裡執行 | smolagents、Cloudflare MCP |
| 只給 bash | 一支 bash | 用環境裡現成的指令,不會用就讀 --help |
mini-SWE-agent |
Gemini CLI 組 request 時,把目前啟用的每支工具定義都放進去。工具不多時這樣最簡單;工具一多,第一節那兩個代價就全要付。
第二種就是 Claude Code 這條路。Codex CLI 開了搜尋工具時,MCP 工具一律延後,模型先呼叫 tool_search,用 BM25(照關鍵字比對打分數的搜尋法)找,預設回 8 支。langgraph-bigtool 整個套件三百行左右,模型一開始只有一支找工具的工具,用 embedding 比對工具說明,每次回 2 支。兩者差在搜到的定義放在哪,下一節講 cache 時再看。
第三種是把工具變成程式裡的函式,模型寫一段 Python 把幾支串起來,一次執行完。CodeAct 的論文比過 17 個模型,在要串好幾支工具、來回多輪的題目上,12 個用程式寫比用 JSON 或純文字的成功率高,表現最好的 GPT-4,用程式寫比次好的格式高 20.7 個百分點;只呼叫一支工具的簡單題,程式寫法跟另外兩種差不多或好一點。Anthropic 另一篇談用程式呼叫 MCP 的文章,把 MCP 工具做成一個個程式檔,Agent 要用哪支才去讀那個檔,他們的例子 token 從 150,000 降到 2,000。
Cloudflare 在 2026 年 2 月把自己的 MCP server 改成這樣。Cloudflare API 有 2,594 個 endpoint,repo 的 README 算過:一個 endpoint 一支工具,定義寫完整要 117 萬 token,只留必填參數也還要 24 萬,都超過 200K 的 Context。改完只剩 3 支,加起來約 1,100 token:search 讓模型寫 JavaScript 在 OpenAPI spec(整份 API 的規格檔)裡找 endpoint,execute 寫程式去呼叫,docs 查文件。
這是真的需要很多工具的情況:管整個 Cloudflare 帳號的 Agent,哪個 endpoint 都可能用到。工具只剩 3 支,模型碰得到的還是整個 API,在 tools 裡少放幾支已經限制不了它能做什麼,要改靠權限:程式跑在 Cloudflare 伺服器上的 sandbox,沒有檔案系統、預設不能連外;連線用的 OAuth token(登入後拿到的通行憑證)只帶使用者勾選的權限。
讓模型寫程式的代價,是要有真的 sandbox。Cloudflare 的 sandbox 在他們自己的伺服器上,client 不用準備。smolagents 同時提供寫程式和呼叫 JSON 兩種 Agent,README 寫內建的本機 executor「is not a security sandbox」,而寫程式的那種 Agent 預設就用它。
第四種是 Day 14 看過的 mini-SWE-agent:除了 bash 什麼都不給,工具就是環境裡現成的指令。Vercel 的 d0 也往這個方向走,把 17 支工具砍成跑命令和跑 SQL 兩支,五題測試的平均時間從 274.8 秒降到 77.4 秒,前提是 Day 3 講過的 semantic layer 早就整理好了。
MCP 不算其中一種。它規定工具怎麼從 server 送到 client,上面四種都接得上 MCP server;定義要一開始全給還是先藏起來,多半是 client 決定的。MCP 官方的 client 最佳實踐文件建議,工具定義占到 Context 的 1% 到 5% 就改成延後載入,另外給模型一支 search_tools。
client 做不到的話,夾在中間的 portal 也能做:Cloudflare 的 portal 網址加上 optimize_context=minimize_tools,就只回工具名字,另給一支 query 工具查完整定義,他們寫最多省 5 倍 token。
MCP 2026 年 8 月的路線圖也寫:「Connecting to a server with a hundred tools means the model pays for that entire surface before the user has asked a single question」,MCP 團隊正開始做 progressive discovery,讓 server 先給一個小入口,對話越聊越具體再展開更多工具;2026-07-28 這版規格還沒有,前面 Cloudflare 的 portal 是在規格外先做了類似的事。
我會這樣選:工具不到十支、每次大多用得到,全部先給,Claude API 的文件也說這種情況用一般的工具呼叫就好;工具多、每次只用幾支,用 Claude Code 或 Claude API 內建的延後載入;API 大到一支一支列不完,或要在大量資料上篩選、串很多步,才考慮讓模型寫程式,而且先把 sandbox 準備好。只給 bash 適合 mini-SWE-agent 這種幫人改程式、現成指令就夠用的環境;退款這種要把規則包在工具裡的,Day 14 講過我會做成專用工具。
開頭那個客服 Agent 用的是 Claude API,可以直接用同一套機制。在 request 的 tools 陣列裡,不常用的工具加上 defer_loading: true,再放一支搜尋工具。API 內建兩種搜尋:regex 版由 Claude 寫正規表示式去比對,BM25 版由 Claude 用自然語言的關鍵字去找。也可以自己寫一支工具、回傳 tool_reference,例如改用 embedding 搜尋。至少要有一支工具不延後,通常就是搜尋工具本身。
OpenAI 的 Responses API 在 2026 年 3 月也加了 tool search,同樣用 defer_loading 標記,不過單支延後的工具,模型一開始還看得到名稱和說明。
延後的只是進 Context 的時間,定義還是整份送給 API。 文件寫得很清楚,每次 request 都要在 tools 裡送每支工具的完整定義,包括延後的,API 要靠它們搜尋和展開。所以不該給這個 Agent 的工具,要在組 request 的時候就不放進去,不能指望延後載入把它藏起來。
cache 的部分,API 會把延後的工具排除在前綴之外,搜到的定義接在對話後面,前綴不動,Day 8 講的 cache 還是能照常命中。要注意延後的工具不能再掛 cache_control,API 會回 400。
自己寫搜尋也要顧到這點。Codex 把搜到的定義放在對話紀錄裡,後面的 request 工具清單不變,它的測試就在檢查這件事;langgraph-bigtool 則每選到一支,就把它加進綁給模型的工具清單。照 Day 8 的前綴規則,工具清單一變,cache 就從那一段開始對不上。這是我照 Day 8 推的,那個 repo 沒有提到 cache。
Day 9 提過的 Cursor 走另一條路:把每個 MCP server 的工具說明同步成一個資料夾,Agent 平常只看到工具名稱,要用時自己去讀檔。他們寫到考慮過 tool search,但那會把工具打散在一個平面的索引裡,所以選擇一個 server 一個資料夾,讓同一個 server 的工具留在一起。在有呼叫 MCP 工具的 run 裡,這個做法讓總 token 少了 46.9%,他們也註明差異很大,要看裝了幾個 MCP server。
開了延後載入之後,工具用錯多了一種可能:模型根本沒搜到它。兩種都叫「用錯工具」,改的地方不同。
| 紀錄裡看到 | 問題在哪 | 先改什麼 |
|---|---|---|
搜尋結果裡沒有 send_email |
沒搜到 | 名稱、說明、參數名稱裡有沒有使用者會講的字 |
| 三支都載入了,發成站內信,或一支都沒叫 | 選錯或選不出來 | 說明寫清楚什麼時候用、什麼時候不用;重疊的合併或拿掉 |
| 叫對了,參數填錯 | 填錯 | Day 14 的參數說明,金額交給後端算 |
| 搜尋結果和工具清單裡都沒有 | 根本沒提供 | 這個 Agent 的工具設定 |
要分得出來,紀錄至少要留三樣:這次 request 提供了哪些工具、每次搜尋的關鍵字和結果、模型實際呼叫了哪支。Claude API 的文件也建議持續看 Claude 搜到了哪些工具,拿來改說明。Claude Code 的紀錄檔裡,ToolSearch 的參數和回傳的 tool_reference 都在,前面那次實驗就是從這裡看的。
做得到。延後載入的工具,模型搜一下就拿得到;從工具清單拿掉的,如果 bash 或某支通用的 HTTP 工具打得到同一支 API,效果一樣做得出來。Day 14 提過,沒權限時要是叫模型「修正後再試」,它可能換別的工具繞過去。
Claude Code 把看不看得到、叫不叫得到分成兩種規則。權限文件寫,只寫工具名稱的 deny 規則(例如 mcp__crm__create_email)會把工具整個從 Context 拿掉,Claude 看不到也叫不到;Bash(rm *) 這種限定範圍的規則,工具還在,只擋符合的呼叫。Bash 本身預設要人核准,只有一組內建的唯讀指令例外。
工具定義裡標示會不會改資料的註記(MCP 的 readOnlyHint)也不能當權限用,MCP 規格寫明那只是提示,Day 24 會再談。
要擋的是退款這個效果,每條做得到的路都要擋,那是 Day 20 到 24 的題目。讓模型少看到一些工具,是為了讓它選得準;權限要另外管。
回到開頭的客服 Agent。我會在現有的工具目錄上多記幾個欄位,讓組 request 的程式知道每支工具給不給、要不要一開始就載入:
| 欄位 | 這個情境的值 | 誰讀寫 |
|---|---|---|
name、description |
send_email:寄 email 給目前這位客戶,會真的寄出…… |
模型讀;搜尋時比對 |
offered_to |
客服退款 Agent | 組 request 的程式,決定放不放進 tools |
always_loaded |
get_order、quote_refund、refund_items、create_return 是;郵件和 CRM 的工具不是 |
組 request 的程式,決定要不要加 defer_loading |
| 搜尋紀錄 | 關鍵字「寄信」,回了 send_email 等三支 |
搜尋工具寫;查沒搜到時讀 |
def build_tools(catalog, agent):
    offered = [t for t in catalog if agent in t.offered_to]   # 用不到的,request 裡就不放
    tools = [SEARCH_TOOL]                                      # 自己寫的搜尋工具,一直載入
    for t in offered:
        d = {"name": t.name, "description": t.description, "input_schema": t.schema}
        if not t.always_loaded:
            d["defer_loading"] = True                          # 定義照送,先不進 Context
        tools.append(d)
    return tools, offered

def search_tools(query, offered, index, log):
    hits = index.search(query, [t for t in offered if not t.always_loaded], limit=5)
    log(query=query, hits=[t.name for t in hits])
    return [{"type": "tool_reference", "tool_name": t.name} for t in hits]   # API 換成完整定義
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
| 客服 Agent 的 loop | 每次呼叫模型之前 | build_tools:常用的四支和搜尋工具進 Context,其他只在 request 裡 |
| loop,在模型呼叫搜尋工具時 | 王小明要把明細寄到信箱 | search_tools("寄信") 回三個 tool_reference,API 把定義接在對話後面 |
| loop 的 executor | 模型呼叫 send_email |
照一般工具執行,權限另外檢查 |
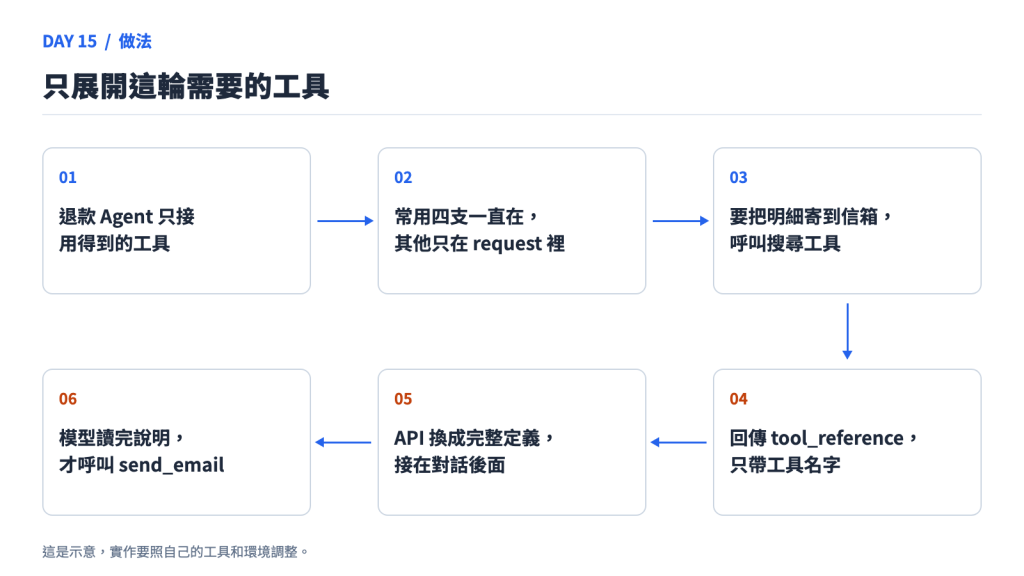
圖:退款 Agent 只接用得到的工具 → 常用四支一直在,其他只在 request 裡 → 要把明細寄到信箱,呼叫搜尋工具 → 回傳 tool_reference,只帶工具名字 → API 換成完整定義,接在對話後面 → 模型讀完說明,才呼叫 send_email。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 14:單支工具的名稱、參數和回傳都說清楚了。工具變多之後,我會照這個順序:
第一步,先量。 Claude Code 用 /context 看工具定義占了多少;自己的 Agent 看 API 回的 input token 裡,工具定義占多少。再把名字或用途相近的工具列出來。
第二步,處理重疊。 這個 Agent 用不到的不接,重疊的合併;留下來的每支都在說明裡寫出什麼時候用、什麼時候不用。這一步同時讓工具搜得到、選得對。
第三步,工具還是很多、每次只用到幾支,才延後載入。 Claude Code 已經預設開著,要調的是哪幾個 server 設 alwaysLoad;自己的 Agent 用 defer_loading 加搜尋工具,常用的三到五支留著不延後。
第四步,紀錄搜尋和呼叫。 沒搜到和選錯分開算,才知道要改說明還是改搜尋。
工具不到十支、每次都用得到,做到第二步就夠了。Day 16 會處理選對工具之後回傳只有一部分的情況,Day 20 到 24 再把權限和危險操作的控制展開。
回到開頭那個客服 Agent,可以試著問自己:換成 Claude Code、tool search 開著,Claude 三支都載入了,還是沒寄,問題出在哪?把 refund_items 改成延後載入,退款能力算是關掉了嗎?
第一題,tool search 只決定哪些定義進 Context。三支名字都像,它們會一起被載入,選哪支、叫不叫,看說明寫了什麼。所以先把用不到的拿掉、重疊的合併,留下來的再把說明和名稱寫清楚。
第二題沒有。延後的工具搜一下就拿得到,定義也照樣送給 API;要擋退款得靠權限,在 Claude Code 是只寫工具名稱的 deny 規則,bash 這類打得到同一支 API 的路也要一起擋。工具一多,先把這個 Agent 用不到的拿掉;剩下的常用幾支一直給,其餘先只給名字、用到再載入;搜不搜得到、選不選得對,還是看名稱和說明分不分得開。
今天把工具清單整理好了。接下來還有另一個問題:工具選對、也執行成功,回來的卻只有一小段 log,模型怎麼知道自己還沒看完?
defer_loading、tool_reference、延後的定義還是要整份送、cache 不受影響、自己寫搜尋工具、常用三到五支不延後、工具少時不需要。ENABLE_TOOL_SEARCH、alwaysLoad、proxy 時預設關閉。tool_choice 可以指定工具,但 Opus 5.5、Sonnet 5.5 等模型不支援、會回 400,改用 auto 靠 prompt 影響。actions_list、actions_get、actions_run_trigger,Projects 的 9 個對到 projects_list、projects_get、projects_write;新工具用 method 參數選動作,查詢的兩支標了 ReadOnlyHint。讀寫分開對權限的好處是我的推論,他們沒寫原因。getFunctionDeclarations() 把每支啟用中的工具定義都放進 request,沒有延後載入。core/src/mcp_tool_exposure.rs 開了搜尋工具時把 MCP 工具延後;core/src/tools/handlers/tool_search_spec.rs 用 BM25 搜延後的工具;tools/src/tool_discovery.rs 預設回 8 支;core/tests/suite/search_tool.rs 檢查搜到的工具靠對話紀錄帶給後面的 request,不改工具清單。docs。CodeAgent 和呼叫 JSON 的 ToolCallingAgent;內建的 LocalPythonExecutor 不是 security sandbox,CodeAgent 預設用本機執行。search_tools;建議在工具定義占 Context 1% 到 5% 時切換。optimize_context=minimize_tools 只留工具名字、另給 query 查完整定義,最多省 5 倍 token;search_and_execute 只給 query 和 execute 兩支。tool_search 和 defer_loading,gpt-5.4 之後的模型支援;單支延後的函式一開始還看得到名稱和說明,包進 namespace 或 MCP server 的只看得到那一層的名稱和說明。readOnlyHint、destructiveHint 等工具註記只是提示,client 除非信任該 server,否則要當成不可信。

 iThome鐵人賽
 看影片追技術