
✂️ 只回傳一部分沒問題,前提是講清楚讀到哪裡、為什麼只有這些,和下一段怎麼拿。
昨天在 Day 15|工具越多,選錯越多:控制 Agent 當下看見的能力面,我們把工具清單整理過:這個 Agent 用不到的拿掉,常用的幾支一直給,其餘先只給名字、用到再載入。
快速回顧一下:Day 9 講過,工具輸出太大時不要整份塞進 Context,executor(Harness 裡實際執行工具的那段程式)把完整內容存成檔案,回給模型的是檔案在哪、總共幾行、怎麼搜和分段讀。今天要接著看的是:工具選對了,回來的東西太長被截掉,模型怎麼知道自己還沒看完。
昨天最後預告的例子是 log 只回來一小段。查了之後,讀 log 的工具多半留的是結尾,錯誤訊息通常就在那裡,只剩開頭的情況不太會碰到(後面講截哪一段時會再提)。今天換成查文件的例子,這個在 Claude Code 上實際跑得出來。
假設你的 Claude Code 接了好幾個遠端 MCP server,每次打開都要等它們連上。你請 Claude Code 去查官方的環境變數文件:「有沒有哪個環境變數,可以讓 MCP server 不用每次都重連?」
答案就在這頁裡:把 MCP_DISCOVERY_CACHE 設成 1,以前用過的遠端 server,打開 Claude Code 時先不連,等第一次要用它的工具才連。麻煩的是這頁很長,轉成純文字有 15.6 萬字,這個變數排在很後面,大約在第 13.7 萬字的地方。
Claude Code 查網頁用的是內建的 WebFetch 工具:先把網頁抓下來轉成純文字,交給一個小模型照 Claude 給的指示整理,Claude 拿到的是整理後的答案。WebFetch 只收網址和這段指示兩樣東西,Claude 想多問什麼,就得再呼叫一次、換一段指示。文件寫明頁面太大會先截到固定字數再交給小模型,但沒寫是多少字。
我用 Claude Code v2.1.280 照這樣問了 3 次,每次都開新的 session:
MCP_DISCOVERY_CACHE。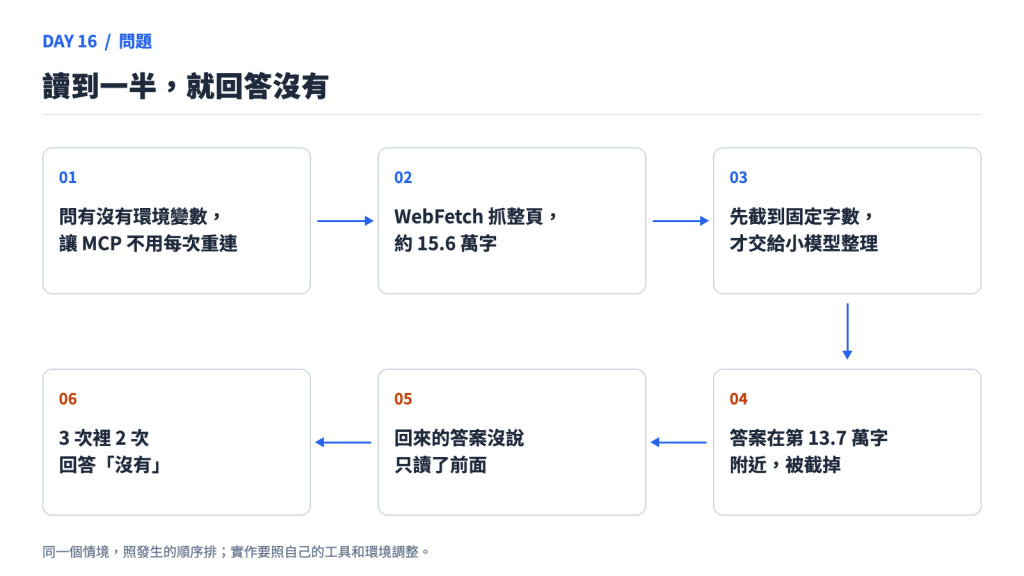
圖:問有沒有環境變數讓 MCP 不用每次重連 → WebFetch 抓整頁,約 15.6 萬字 → 先截到固定字數,才交給小模型整理 → 答案在第 13.7 萬字附近,被截掉 → 回來的答案沒說只讀了前面 → 3 次裡 2 次回答「沒有」。這是示意,實作要照自己的工具和環境調整。
那半句話在原始檔的第 10 萬字附近,也就是說小模型只看到前面約六成。再呼叫幾次,小模型讀到的都是這前六成。答錯的兩次,WebFetch 回來的答案都沒說只讀了前面。Claude 手上只有前段整理出來的內容,就把「讀到的部分裡沒有」說成了「沒有」。
答錯的其中一次還出了另一個問題。Claude 第二次呼叫 WebFetch 時,在指示裡點名幾個它知道的變數,要小模型照原文引用;小模型回了一張五列的表格,格式看起來像原文,內容卻跟文件對不上。文件寫 MCP_TIMEOUT 是 MCP server 啟動的 timeout,預設 30 秒;表格裡寫成連線和工具呼叫都算,預設 10 分鐘。這幾個變數都在被截掉的後段。Claude 照這張表建議「調低 MCP_TIMEOUT,例如 30000」,但 30000 毫秒就是文件寫的預設值 30 秒。
工具只交回一部分,又沒說只有一部分,模型會把它當成全部來回答。 下面先看 Claude Code 自己的幾支工具截斷時交回什麼,再整理回傳要交代哪幾件事、該留哪一段給模型、續讀怎麼讀回同一份,最後寫成一個最小的版本。
工具輸出都有上限,超過就得截,差別在截了之後交給 Claude 什麼。Claude Code 的工具文件把每支工具的做法寫得很清楚,我挑四種常碰到的:
| 工具 | 超過多少 | Claude 拿到什麼 |
|---|---|---|
| Read(讀檔) | 25,000 token | 前面一頁,加一段說明:第幾行到第幾行、全檔幾行、上限多少、下一頁怎麼讀 |
| Bash,指令成功 | 約 30,000 字 | 完整輸出存成檔案,給路徑、總大小和前 2,000 字 |
| Bash,指令失敗 | 約 10,000 字 | 頭尾各一段,中間標出截掉幾個字;沒有檔案路徑 |
| WebFetch | 固定字數,文件沒寫多少 | 小模型讀完前段之後的回答 |
我把同一頁存成本機檔案讓 Read 讀,它附上的說明長這樣:
[Truncated: PARTIAL view — …/docs/env-vars.md: showing lines 1-178 of 549 total
(65248 tokens, cap 25000). Call Read with offset=179 limit=178 for the next page,
or Grep to find a specific section. Do NOT answer from this page alone if the
answer may be further in the file.]
讀到哪裡(1–178 行,全檔 549 行)、為什麼只有這些(超過 25,000 token 的上限)、下一段怎麼拿(offset=179,或改用 Grep 搜),三件事都在,最後還加一句:答案可能在後面,就別只憑這一頁回答。
同一頁、同一句問題,我改成讓 Claude 讀本機檔案,分兩組各跑 3 次。只給它 Read 這支工具的那組,3 次都照這段說明一頁頁往下讀,找到了 MCP_DISCOVERY_CACHE;工具全開的那組,3 次都直接用 grep 搜整份檔案,也都找到。WebFetch 那組則是 3 次裡有 2 次說沒有。每組只跑 3 次,看得出方向,不能當成比例。
Bash 要看指令成功還是失敗,截法不一樣。我寫了一支小程式,印 3,000 行、每行 52 字,共 152KB,讓 Claude 跑兩次:一次正常結束,一次在最後回傳失敗。
正常結束的那次交代得清楚。回來的第一行是 Output too large (152.3KB). Full output saved to: …/tool-results/byt9tk0xq.txt,後面接前 2,000 字的預覽,Claude 要看後面就去讀那個檔案。
回傳失敗的那次就不一樣了。Claude 拿到的是第 1 到 96 行,中間一行 ... [20012 characters truncated] ...,接著是第 482 到 577 行,第 577 行還斷在半行。實際的輸出一路印到第 3,000 行,Claude 沒拿到的超過 14 萬字,標記上卻只寫截掉兩萬。
文件有寫原因:Claude Code 只收下輸出的前 30,000 字,失敗時的頭和尾都是從這 30,000 字裡取的。所以這個「尾」只是前 30,000 字的結尾,再後面的輸出根本沒收。調大 BASH_MAX_OUTPUT_LENGTH 只會讓這段範圍變大,頭尾還是從裡面取。Claude 自己也看出來了,它說結尾沒有任何截斷標記,分不出第 577 行是不是輸出的最後一行。
建置和測試失敗時,錯誤訊息通常印在最後,偏偏這條路切掉的就是結尾。實際用起來不常踩到,因為 Claude 跑長指令常會自己接 | tail:我拿 Playwright 的端對端測試讓它跑了 5 次,5 次都這樣。但接不接是模型每次自己決定的,沒接的時候,工具的回傳也不會提醒它結尾沒拿到。
「沒找到」也要分清楚是哪一種。Grep 翻頁用的 offset 超過最後一筆時,Claude Code 回 No entries at this offset,Claude 才分得出是翻過頭,還是真的沒有符合的;count 模式(列出每個檔案符合幾筆)最後附的總數,v2.1.208 之後算的是全部符合的,之前只加總有列出來的那幾筆。
照 Read 那段說明,我會要求截斷的回傳交代三件事:
offset、後端給的分頁位置(cursor),或一支能搜整份的工具。拿不到就直說,不要放一個其實讀不回來的連結。三件事只要缺一樣,模型能說的就只有「讀到的範圍裡沒有」。WebFetch 的文件也這樣提醒:它說頁面沒提到某件事,可能只是給小模型的指示沒問到;要完整內容,就改用 curl。
截的時候要留哪一段給模型,看是什麼資料。
log 的錯誤多半在最後,取尾比較合理。GitHub 官方 MCP server 讀 Actions log 的工具,要它直接回內容時,預設只回最後 500 行,另外附上整份 log 有幾行(original_length),要更多就調大行數再讀。Codex 截 shell 輸出時保留輸出實際的開頭和結尾,最前面寫明原本的 token 數和總行數(Total output lines),模型至少知道中間少了多少。
文件和設定說明就不一樣了,答案可能在任何一段,取頭取尾都是碰運氣,給一支能搜整份的工具比較實在。開頭那頁就是例子:同一份內容能用 grep 搜的時候,3 次都找到。
摘要要小心用。WebFetch 回來的是小模型照指示整理的結果,拿來回答「這頁大概在講什麼」可以;要回答「有沒有某個設定」,就得能搜原文。
所以「截掉就好嗎」要看模型接下來要回答什麼。回答「測試有沒有過」,exit code 加最後幾行可能就夠;回答「這段時間有沒有出現某個錯誤」「文件裡有沒有某個設定」,就要讀完或搜過整份。
知道下一段怎麼拿之後,還要確定拿到的跟前面是同一份。
以 GitHub Actions 為例,一個 run(workflow 跑一次)按了 re-run,同一個 run 底下會多出第 2 次 attempt。讀 log 的 REST API 有兩支:只帶 run id 的 /runs/{run_id}/logs,和多帶 attempt 編號的 /runs/{run_id}/attempts/{attempt_number}/logs;我拿一個重跑過的公開 run 試過,前者拿到的就是第 2 次的 log。工具如果只用 run id 讀,讀完前段之後有人按了 re-run,等重跑完再續讀尾端,拿到的就是第 2 次的結尾,跟前段不是同一次執行。
文件頁也會改。續讀的時候要是重新抓一次網頁,中間剛好改版,前段和後段就來自兩個版本。
MCP 官方維護的 fetch server 就是這樣續讀的。它一次預設回 5,000 字,後面還有的話,結尾附一句 Content truncated. Call the fetch tool with a start_index of 5000 to get more content.,下一段怎麼拿交代得很清楚,但全頁有多長沒說。模型照著帶 start_index 再呼叫一次,fetch server 會重新下載整頁,再從第 5,000 字切出下一段。頁面要是在兩次呼叫之間改過,第 5,000 字就不一定接得上上一段讀到的地方。
Claude Code 的做法不一樣:Bash 指令成功但輸出太長,或 MCP 工具輸出太長,都是先把整份存成檔案再給路徑。之後不管讀幾次、搜幾次,都是那一份。
我自己寫 Agent 的工具,也會照這樣做:第一次抓就把整份存下來,記下是哪個版本(讀 log 記 attempt 編號,抓網頁記抓取時間),之後續讀和搜尋都讀這一份。存的那份過期了,工具就直接回「讀不回來,要重新抓」,不要偷偷重抓一份最新的接在後面。
回到開頭的問題。如果是自己寫的 Agent,同樣有一支抓文件的工具,我會讓它的回傳多這幾個欄位(名字是我取的),對應前面「回傳要交代哪幾件事」列的那幾樣:
| 欄位 | 這個情境的值 | 誰讀 |
|---|---|---|
shown/total |
第 0 到 100,000 字/全頁 156,124 字 | 模型:知道後面還有 |
complete |
false |
模型:不能拿這段回答「有沒有」 |
reason |
一次最多回 100,000 字 | 模型:是上限,換個方式讀就好 |
ref |
doc_7f3a,整頁存下的那一份和抓取時間 |
read_more、search_doc 都讀這份 |
MAX_CHARS = 100_000

def fetch_doc(url, store):
    text = to_markdown(download(url))
    ref = store.save(text, source=url, fetched_at=now())   # 整份先存下,之後都讀這一份
    part = text[:MAX_CHARS]
    done = len(part) == len(text)
    return {"content": part, "shown": [0, len(part)], "total": len(text),
            "complete": done,
            "reason": None if done else f"一次最多回 {MAX_CHARS} 字",
            "ref": ref}

def read_more(ref, offset, store):
    text = store.load(ref)                                 # 讀存下的那份,不重抓網頁
    if text is None:
        return {"error": "這份已經過期,要重新抓", "ref": ref}
    part = text[offset:offset + MAX_CHARS]
    end = offset + len(part)
    return {"content": part, "shown": [offset, end], "total": len(text),
            "complete": end == len(text), "ref": ref}

def search_doc(ref, pattern, store):
    text = store.load(ref)
    if text is None:
        return {"error": "這份已經過期,要重新抓", "ref": ref}
    hits = find_all(text, pattern)                         # 搜整份,不只回給模型的那段
    return {"hits": hits[:20], "hit_count": len(hits),
            "searched": [0, len(text)], "ref": ref}
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
| loop 的 executor | 模型要抓 env-vars 那頁 | fetch_doc 把整頁存成 doc_7f3a,回前 100,000 字,complete 是 false |
| 模型 | 讀到 complete: false,要回答「有沒有」 |
呼叫 search_doc(doc_7f3a, "MCP"),在第 137,677 字找到 MCP_DISCOVERY_CACHE |
| 模型 | 要看那一段的完整說明 | 呼叫 read_more(doc_7f3a, 137000),讀的是同一份 |
Read 的說明最後那句「別只憑這一頁回答」,我也會照抄進 reason,多寫一句不費事。Anthropic 談怎麼幫 agent 寫工具的文章也是這個方向:可能回很長內容的工具,要有分頁、指定範圍、篩選或截斷,並給合理的預設值;截斷時附上說明,引導 agent 換個方式拿,例如改成幾次小範圍的搜尋。對照上面的程式:MAX_CHARS 是截斷的預設值,read_more 是指定範圍往下讀,search_doc 是篩選,reason 就是那段說明。
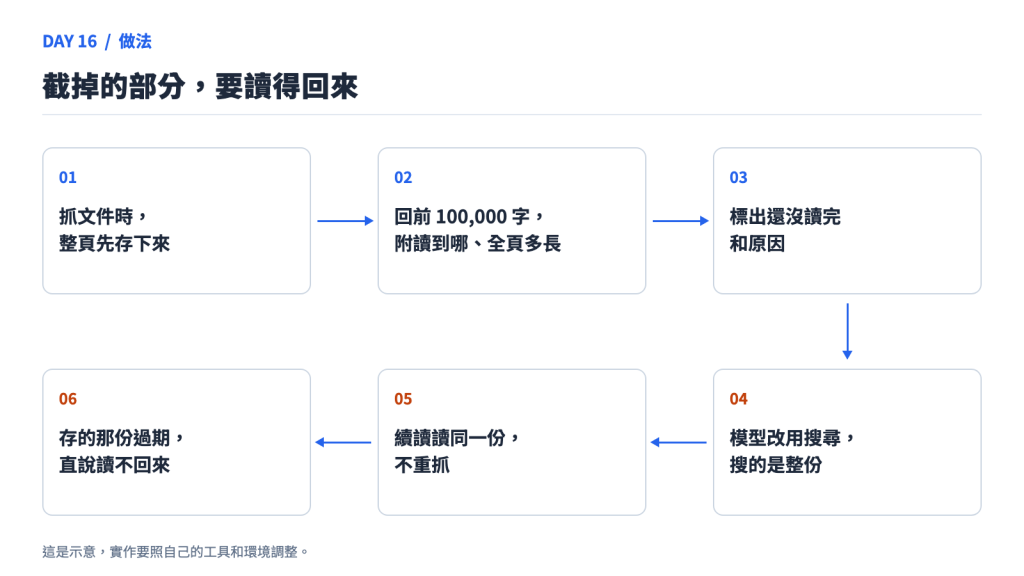
圖:抓文件時整頁先存下來 → 回前 100,000 字,附讀到哪、全頁多長 → 標出還沒讀完和原因 → 模型改用搜尋,搜的是整份 → 續讀讀同一份,不重抓 → 存的那份過期就直說讀不回來。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 15:Agent 手上的工具整理過了,模型也選得對。接下來讓截斷的回傳講清楚,我會照這個順序:
第一步,列出每支工具的上限,和超過時回什麼。 會回長輸出的工具一支一支看:抓網頁、讀檔、跑指令、查 log、查資料庫。在 Claude Code 裡,就是記得 WebFetch 跟 Read、Bash 不一樣;要問某份文件「有沒有」,請它用 curl 下載原始檔再搜,官方文件也這樣建議。
第二步,截斷的回傳補上三件事。 讀到哪裡、為什麼只有這些、下一段怎麼拿。用 MCP server 的話,看它的回傳有沒有這些,沒有就自己包一層。
第三步,整份存下來,給續讀和搜尋。 續讀和搜尋都讀存下的那份,版本記下來;讀不回來就直說。
第四步,記錄原始大小和實際送進 Context 的大小。 答錯的時候,才查得出模型當時到底拿到多少。
如果工具的輸出從來不會超過上限,或模型只需要最後的狀態(exit code 加最後幾行),做到第一步就夠了。Day 17 換到搜程式碼,看怎麼記下查過哪些範圍;Day 28 再看怎麼從紀錄查出模型當時拿到的結果完不完整。
回到開頭那頁文件,可以試著問自己:WebFetch 的回傳如果多一句「只讀了前 10 萬字,全頁 15.6 萬字」,Claude 就一定會答對嗎?Bash 指令失敗時,回來頭尾兩段、中間標了截掉多少字,這樣算交代清楚了嗎?
第一題不一定,但它至少知道後面還有,就不能說「沒有」;還要有一支能搜整份或往下讀的工具,它才補得回來。Read 那組就是這樣,3 次都往下翻到了。
第二題不算。尾巴是前 30,000 字的尾,不是輸出的結尾,沒有路徑,標記的字數也少算了。要嘛像指令成功時那樣存成檔案給路徑,要嘛像 Codex 留下實際的結尾、寫明總行數。只回傳一部分沒問題,前提是講清楚讀到哪裡、為什麼只有這些,和下一段怎麼拿。
今天處理的是一支工具的回傳不完整。接下來還有另一個問題:換成在整個程式庫裡搜,搜到幾個檔案之後,怎麼知道該改的地方都找齊了?
MCP_DISCOVERY_CACHE 讓用過的遠端 server 啟動時先不連;MCP_TIMEOUT 是 MCP server 啟動的 timeout,預設 30 秒;BASH_MAX_OUTPUT_LENGTH 預設 30,000 字、最多 150,000。字數和位置是我下載原始 markdown 算的,頁面之後改版會變。bashOutputMaxChars;Read 超過 token 上限回 PARTIAL view 說明;Grep 的 No entries at this offset 和 count 總數(v2.1.208)。上面四種工具的實際回傳是我在 v2.1.280 上跑的。anthropic/maxResultSizeChars 調高單支工具的上限。get_job_logs 的 tail_lines 預設 500,回傳帶 original_length。formatted_truncate_text 截斷時保留開頭和結尾、切掉中間,前面加上原本的 token 數和 Total output lines。max_length 預設 5,000 字,start_index 從指定位置續讀,後面還有時提示下一個 start_index;每次呼叫都重新下載網址再切。這是我讀原始碼看到的,沒有實際跑。

 iThome鐵人賽
 看影片追技術