

29 天前,我們從一台實體主機與一張架構草圖出發。今天,我想帶大家回頭看這套環境:它已經能提供哪些服務?遇到故障時,又能把服務與資料恢復到什麼程度?這篇會從測試方法走到實測結果,替這 30 天留下可供日後維運參考的紀錄。
回頭看這 30 天,我們沿著三條主線,把一台實體主機上的架構草圖逐步建成可以操作、切換、復原與驗收的私有雲 Lab。
主線一:虛擬化平台與共享儲存
Day 01~08 先完成承載所有服務的底層平台。我們規劃運算、網路、儲存與故障域,在 L0 主機內建立 pve01、pve02、pve03 三個 PVE 節點,準備 Linux Bridge、VLAN-aware Bridge、Debian Template 與 Cloud-Init,讓後續 VM 能以一致的方式建立。
接著,我們使用 Corosync 與法定票數組成 PVE 叢集,以 Ceph RBD、CephFS 建立多節點可存取的共享儲存,再把測試 VM 交給 HA Manager 管理。最後實際執行 Migration、Relocate 與節點故障接手,量測 VM 網路恢復及 Ceph 回到完整穩態所需的時間。到這裡,我們得到一個能建立 VM、協調節點、安排維護並示範故障接手的虛擬化平台。
主線二:受控的網路與管理入口
Day 09~18 從封包路徑與服務暴露面開始,逐步把原本直接互通的 Lab 網路改造成有區域、有規則、有管理入口的環境。我們建立 OPNsense,完成 WAN 上網、來源 NAT、VLAN 20~50、跨網段路由,以及 DNS、NTP、套件更新和內部服務所需的防火牆政策。
管理路徑則透過 jump01、SSH 金鑰、ProxyJump 與目的地限制集中控管。遠端使用者透過 OpenVPN 取得不同權限,再用允許、拒絕與憑證撤銷測試核對結果。最後加入 Suricata,比較 IDS 告警與 IPS 阻擋,並確認同 VLAN 與加密流量帶來的可視範圍限制。到這裡,我們得到一套能區分服務、管理與遠端存取,並留下規則命中與安全事件紀錄的網路邊界。
主線三:可以切換、也可以復原的服務
Day 19~29 開始在前兩條主線上部署實際服務。我們先建立內部 CA,讓 PostgreSQL 節點與管理工具使用可驗證的 TLS 身分。再建立三節點 PostgreSQL 串流複寫、etcd 與 Patroni,讓叢集能協調 Primary、Replica 與故障切換。
接著,我們使用 Nginx、HAProxy 與 Keepalived 建立公開 Web、DB-RW、DB-RO 三組固定入口,並透過 Cloudflare 提供公開 DNS、CDN、WAF 與兩段 TLS。資料保護由 pgBackRest、基礎備份與 WAL Archive 支撐,誤刪資料可以在隔離 VM 執行 PITR。Prometheus、Grafana 與 Alertmanager 則補上指標(Metrics)、儀表板(Dashboard)與告警生命週期。到這裡,我們得到一套具有固定入口、資料庫角色切換、備份還原及監控告警的應用服務。
這三條主線依序解決服務要在哪裡執行、流量可以從哪裡進入,以及故障後如何切換與復原。最後,它們收斂成下圖的使用者、管理、資料保護與觀測路徑:
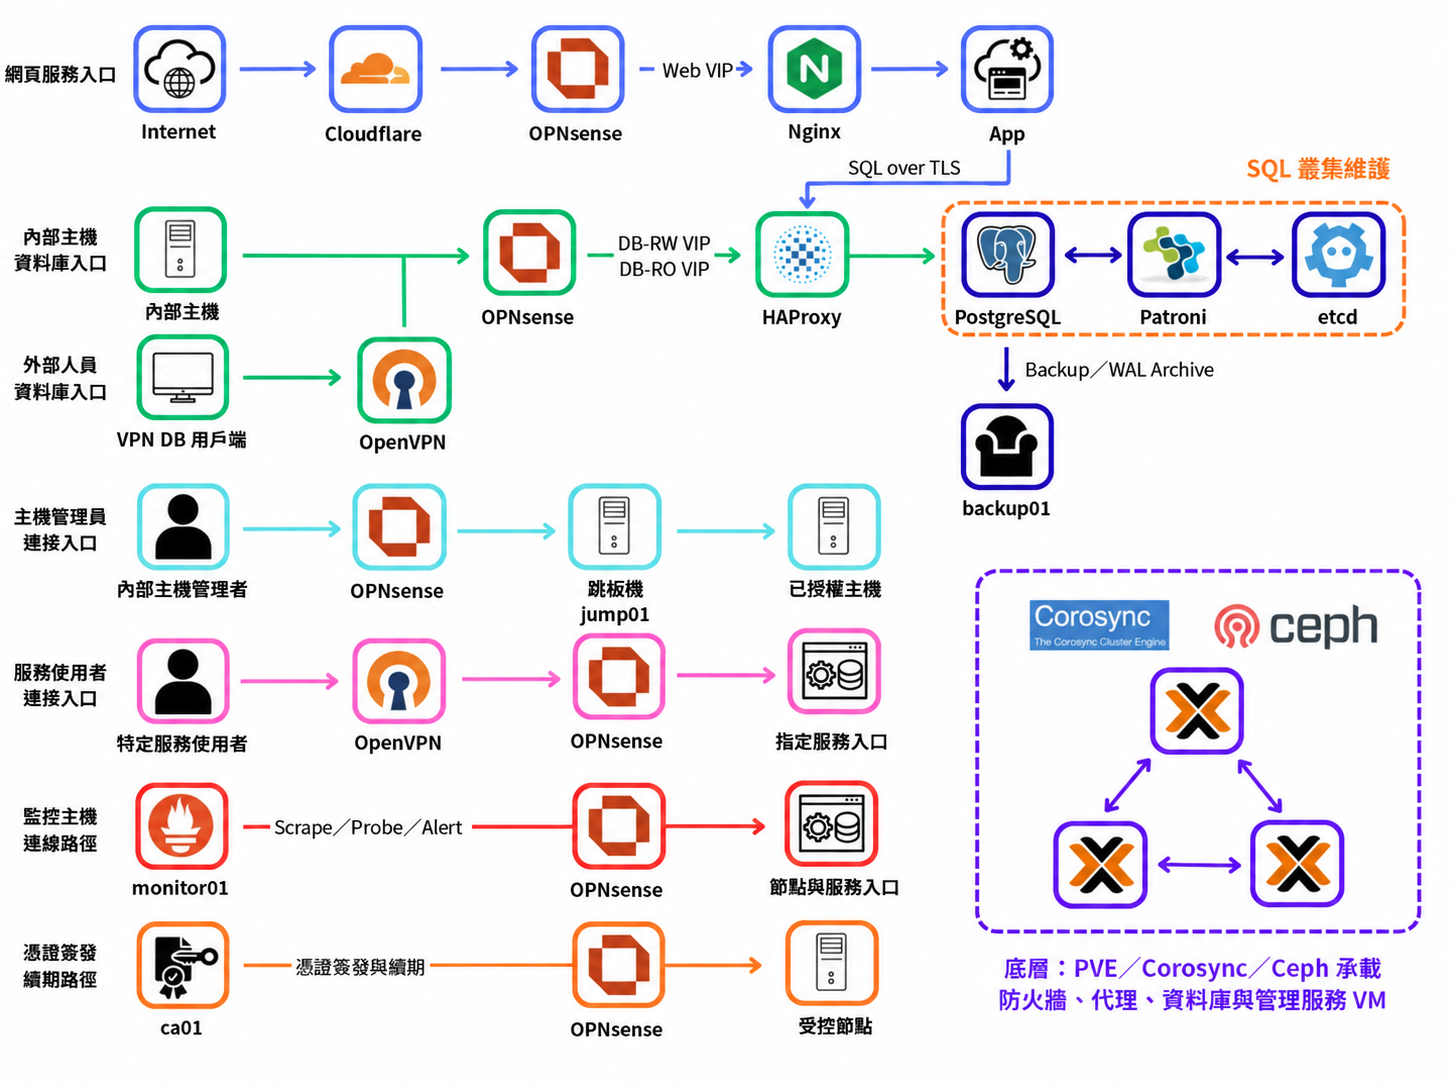
圖(一)三條主線最後形成的服務、管理、資料保護與觀測路徑
圖中的 SQL over TLS 表示 App 存取 PostgreSQL 的服務關係。實際連線會先使用 DB-RW VIP,再由 HAProxy 送往目前的 Primary。
從實際使用者的角度看,圖(一)提供四類入口。這裡的使用者除了瀏覽網站的一般使用者,也包括資料庫使用者、主機管理者,以及獲准操作特定服務的人員:
圖中另外保留三條系統之間的維運路徑:CA 提供憑證簽發與續期,backup01 保存復原所需資料,monitor01 則透過 Scrape 與 Probe 取得服務狀態,再由 Prometheus 評估規則並將告警送往 Alertmanager。服務故障時,使用者關注何時能再次操作,維運人員還要確認備援副本、告警與資料保護是否恢復。後面的驗收會分別追蹤這些結果。
圖中的角色可以切換,使用者使用的 Hostname、VIP 與授權入口則保持穩定。PostgreSQL 與 Proxy VM 主要使用所在節點的 local-lvm。PostgreSQL 的資料可用性由串流複寫與 Patroni 提供。app01、app02 與 PVE HA 測試 VM 則使用 Ceph 共享磁碟示範 Migration 與 HA。
走到這裡,大家已經能從固定入口使用網站與資料庫,也能登入管理、取得備份和查看監控。我想在最後一天,把這些部署成果放進實際情境:合法操作能否完成、越權連線是否被拒絕、節點突然停止後服務多久恢復,以及恢復後還留下多少資料。
這就是今天安排驗收與演練的原因。我們會在明確的影響範圍內注入故障,觀察服務、監控與回復流程。這類受控演練通常稱為演練日(Game Day)。它也讓我們練習真正發生事故時的操作,而不只熟悉平常一切正常的畫面。
今天,我會先說明這次驗收的範圍與量測方式,再整理前幾天已經取得的證據,並補上 Proxy VM、Primary VM 突然停止的端到端測試,以及同 VLAN 管理入口檢查。取得結果後,我們再一起判讀目前具備的復原能力,以及它們和 RTO、RPO 之間的關係。
後面會用到四個縮寫,我把它們分成時間與資料兩組:
| 面向 | 演練取得的能力 | 服務需要達到的目標 |
|---|---|---|
| 服務中斷 | 復原時間能力(Recovery Time Capability,RTC):在指定故障與觀察條件下,服務實際恢復所需時間 | 復原時間目標(Recovery Time Objective,RTO):業務可接受的最長服務中斷 |
| 資料缺口 | 復原點能力(Recovery Point Capability,RPC):事故發生時,實際可恢復到的資料時間點及其缺口 | 復原點目標(Recovery Point Objective,RPO):業務可接受的資料時間缺口 |
這套 Lab 的工作是驗證功能,並在條件明確的情境中留下 RTC/RPC 樣本。將來要把架構用在實際服務時,還需要依使用者影響與營運需求核准 RTO/RPO,再以符合實際資料量、負載與處置流程的演練檢查能力是否足夠。本文最後會用我們的結果示範這個比較過程。
我把服務分成六個模組。每個模組都從正常操作出發,再加入對應的拒絕條件或故障情境:
| 驗收模組 | 正向驗收 | 負向或故障驗收 | 主要觀察結果 |
|---|---|---|---|
| 平台與儲存 | PVE 保有法定票數、VM 與 Ceph 正常運作 | 節點故障、票數下降 | VM 可達性、叢集狀態與儲存副本恢復 |
| 網路與權限 | VPN、ProxyJump 與核准服務可用 | 未授權群組、主機直連、Origin 繞過 | 允許/拒絕、實際路由與規則命中 |
| 公開 Web 與代理入口 | HTTPS、DB-RW、DB-RO 可用 | Web Backend、代理程序或 Proxy VM 故障 | 固定入口與 VIP 接手、請求恢復 |
| 資料庫高可用 | Primary 可寫入、Replica 可查詢 | Primary VM 或 etcd Member 故障 | 角色切換、交易完整性與節點回歸 |
| 備份與資料復原 | 備份、WAL Archive 與隔離 PITR 可用 | 誤刪、Archive 中斷 | 可復原資料、資料缺口與還原耗時 |
| 監控與告警 | Target Up、Rule Inactive | 停止受監控服務 | Pending、Firing、告警解除與 Target 恢復 |
實際操作時,我會按同一個流程留下紀錄:
這樣一輪測試會同時留下使用者看到的影響,以及維運人員需要的原因與回復紀錄。
今天的服務探測使用相同腳本、逾時條件與每輪一秒的等待間隔。單次請求本身也會耗時,因此實際取樣間距以紀錄(Log)時間戳為準。各節點記錄 ISO 8601 時間並確認 NTP 同步,讓跨主機事件可以對照。
本次以連續三次成功中的第一筆作為穩定恢復點,後兩筆用來確認恢復持續成立。DB-RW 還要完成寫入,DB-RO 要符合預期的唯讀角色。這個定義會用在下面的切換結果。
| 紀錄類別 | 起點與終點 | 用途 |
|---|---|---|
| 服務恢復 | 從故障注入到同一路徑穩定恢復 | 記錄這次故障情境的 RTC |
| 使用者可見中斷 | 從第一筆失敗到穩定恢復點 | 描述探測器實際看到的失敗區段 |
| 備援回復 | 從指定的故障或重啟操作到副本、角色等恢復健康 | 評估降級運作期間 |
| 告警延遲 | 從故障到 Firing。從回復操作到告警清除 | 評估告警觸發與解除速度 |
| 資料缺口 | 事故時間與還原端最後可見交易時間之差,另核對交易序號 | 記錄指定情境的可復原資料邊界與交易完整性 |
前幾天的資料也沿用各自的起訖條件,例如 Ping 只代表網路可達,隔離 PITR 的耗時只涵蓋復原程序。全程探測成功時,我會記為本次未觀察到中斷,並保留取樣間隔與樣本數。取樣之間可能存在更短的中斷。
想跟著操作,可以使用 GitHub 文件庫的 Day 30 最終 Game Day 實作文件。裡面包含 Scenario A~I、完整命令、停止與回復條件,以及可填寫的驗收表、事件時間線和改善追蹤表。
我們這 30 天已取得的結果,另外整理在 三十天驗收結果,保留全部代號、秒數與判定。下面的正文則依情境挑出相關數據,說明它們代表的服務能力。
依照上面的範圍整理後,大部分項目已在前 29 天的 Lab 留下證據。相同條件下已完成的測試,我沿用原紀錄。今天補上星號標記的兩條端到端故障路徑,以及同 VLAN 管理入口檢查。為了讓各份紀錄能互相對照,我用英文字首區分故障或拒絕測試(Fault,F)、使用者路徑(User,U)、控制面(Control Plane,C)、復原(Recovery,R)與告警(Alert,A)。各日的完整操作與畫面保留在原 Lab。
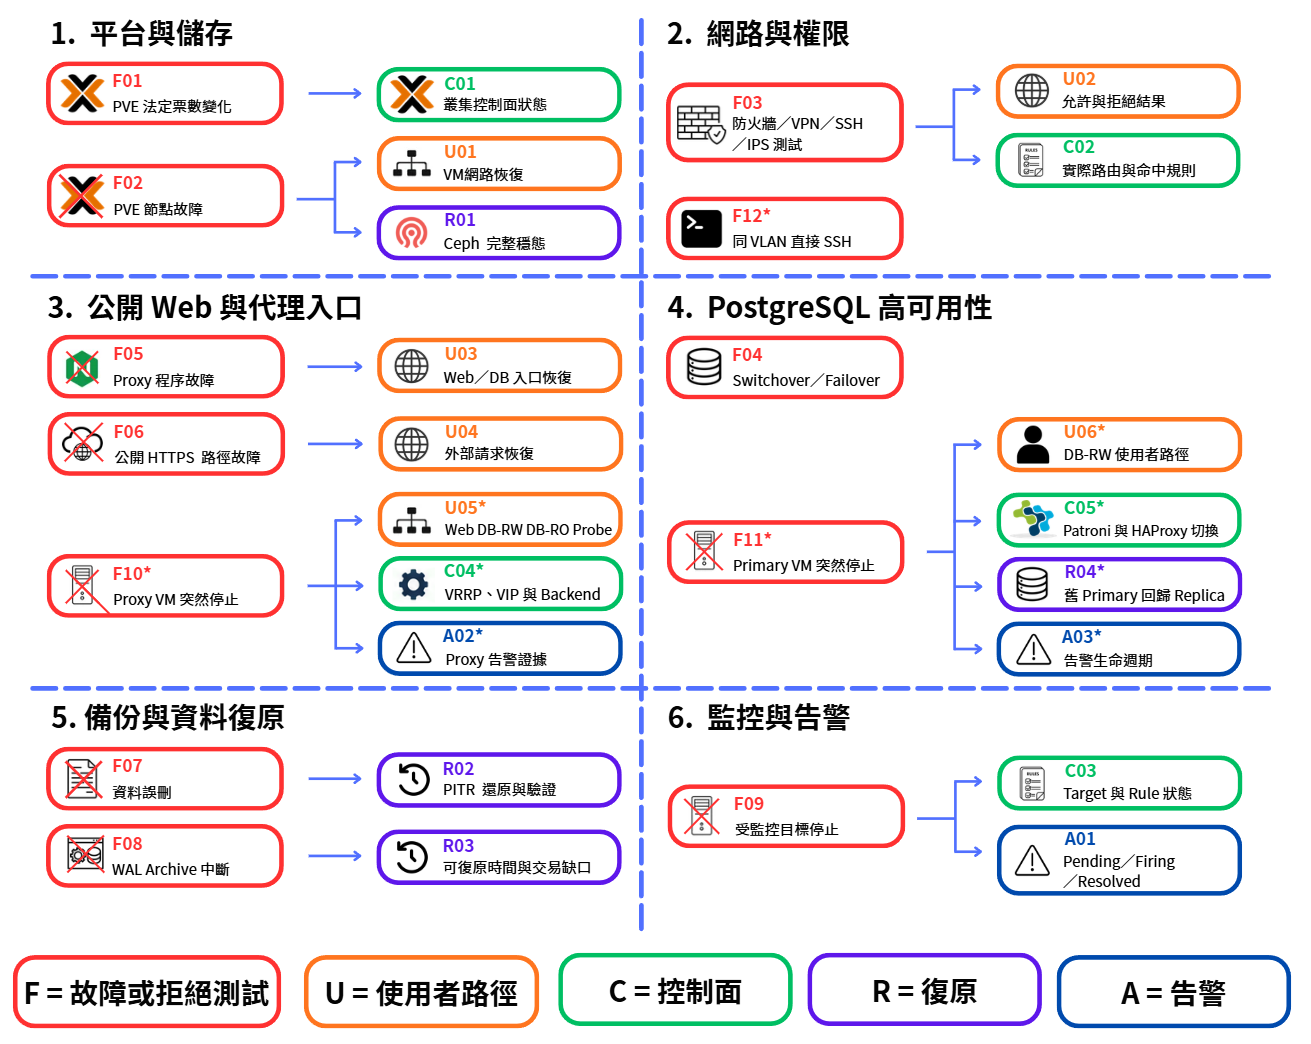
圖(二)證據代號將故障、使用者、控制面、復原與告警結果接回同一項服務能力。星號為 Day 30 新增證據
圖(二)由左側的故障或拒絕測試出發,向右連到同一情境要保存的證據。例如停止持有 VIP 的 Proxy VM 是 F10。三條服務入口是否恢復記在 U05,VIP 與 Backend 的接手狀態記在 C04,告警是否觸發及清除則記在 A02。它們合在一起,才能看出使用者影響、接手機制與監控覆蓋程度。
Primary VM 故障的 F11 還多了 R04,用來確認舊 Primary 能以 Replica 回歸。寫入服務恢復與備援節點回歸各有自己的完成時間。下面會把這兩種結果分開解讀。圖中箭頭表示證據的對應關係,事件先後則以實測時間線判讀。
下表由左至右逐列閱讀,列出全部代號的結果。PASS 表示該項觀察符合驗收條件。FAIL 表示實際結果未達條件。
| 代號/判定 | 驗收結果 | 代號/判定 | 驗收結果 |
|---|---|---|---|
F01 PASS |
PVE 在 3/3、2/3 票數下保有 Quorum | C01 PASS |
叢集控制面狀態符合節點數變化 |
F02 PASS |
節點故障後 HA 重新指派 VM | U01 PASS |
VM 網路恢復回覆 Ping |
R01 PASS |
Ceph 回到 HEALTH_OK 與 PG active+clean |
F03 PASS |
網路與權限正反向測試符合規則 |
U02 PASS |
核准路徑通過,未授權組合被拒絕 | C02 PASS |
實際 Route 與防火牆命中結果相符 |
F12* FAIL |
同 VLAN 可直接連到 app01 TCP 22 | F05 PASS |
Proxy 程序故障後 Web/DB VIP 接手 |
U03 PASS |
Web/DB 入口恢復 | F06 PASS |
公開 HTTPS 路徑故障後恢復 |
U04 PASS |
外部請求穩定恢復 | F10* PASS |
Proxy VM 突停後 proxy02 接手三組 VIP |
U05* PASS |
Web、DB-RW、DB-RO Probe 恢復 | C04* PASS |
VIP 保持唯一且 Backend 恢復 |
A02* PASS |
Proxy 故障觸發 InstanceDown,恢復後告警清除 |
F04 PASS |
Switchover/Failover 與舊 Primary 回歸正常 |
F11* PASS |
Primary VM 突停後 pg03 晉升 | U06* PASS |
DB-RW 恢復,281 筆確認交易均可見 |
C05* PASS |
Patroni 切換後 HAProxy 更新 Backend | R04* PASS |
舊 Primary 以 Replica/streaming 回歸 |
A03* PASS |
取得 Primary 故障的完整告警生命週期 | F07 PASS |
建立資料誤刪情境並保留誤刪前復原目標 |
R02 PASS |
在隔離 Restore VM 完成 PITR 並核對誤刪前資料 | F08 PASS |
Archive 停滯時正式叢集仍可提交交易,Repository 復原邊界停止前進 |
R03 PASS |
從 Repository 還原並核對最後可見交易,另保存本次資料缺口樣本 | F09 PASS |
受監控 Target 停止後觸發告警 |
C03 PASS |
Target、Rule 隨服務狀態變化 | A01 PASS |
告警經 Pending、Firing 到 Resolved |
這次整理出 29 項 PASS 與 1 項 FAIL。接下來,我會從使用者的服務恢復談起,再看資料缺口、告警和管理邊界。每一組結果都有不同用途,也會影響後面對復原目標的判讀。
前幾天已量過節點、角色端點與入口接手。今天延伸到整台 VM 突然停止,目的是讓探測器沿著使用者平常使用的入口,確認完整路徑恢復。
Day 26 已測過 Nginx/HAProxy 程序故障與 Proxy VM 正常關機。正常關機能讓 Keepalived 主動釋放 VIP。這次我改從 PVE 管理端強制停止目前持有 VIP 的 Proxy VM,觀察另一台 Proxy 的接手過程。
我們同時探測公開 Web、DB-RW 與 DB-RO,並確認 proxy02 接手三組 VIP、HAProxy Backend 正確。使用者請求記在 U05,接手狀態記在 C04,Proxy 的 InstanceDown 觸發與恢復後清除記在 A02。
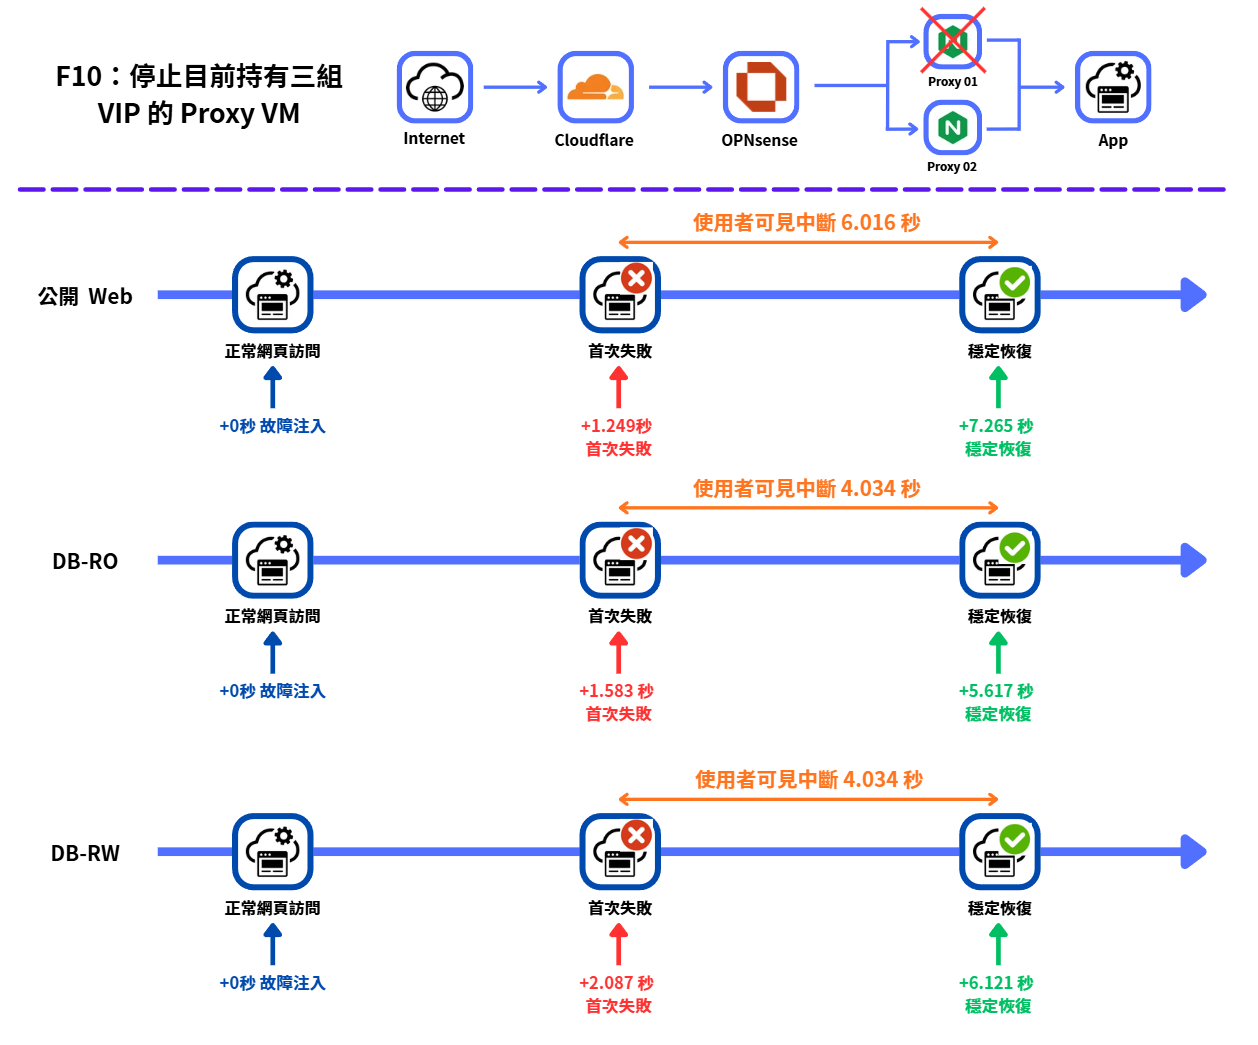
圖(三)F10 使用同一個故障起點比較三條服務路徑。首次失敗與穩定恢復之間才是使用者可見中斷
這次停止的是同時持有三組 VIP 的 proxy01,所以三條路徑都會先失去原本的入口。proxy02 已經安裝相同的 Nginx、HAProxy 與 Keepalived 設定。收不到 proxy01 的 VRRP 通告後,它會接手 Web、DB-RW 與 DB-RO VIP。用戶端仍使用原本的 Hostname 與 VIP,新的連線則由 proxy02 轉送到健康的 App、Primary 或 Replica,三條路徑不需要配合更改連線位置。
三組 VIP 使用各自的 VRRP 執行個體,Nginx 與 HAProxy 也有自己的健康檢查與連線建立過程,因此恢復時間不必完全相同。這次 DB-RO 最早恢復,其次是 DB-RW,公開 Web 最晚。若把三條入口都恢復可用作為這輪測試的完成條件,就採公開 Web 的 7.265 秒。若只關注寫入入口,則採 DB-RW 自己的結果。
圖中也保留首次失敗的位置。故障注入到下一筆失敗請求之間有取樣差距,因此公開 Web 的可見中斷是 6.016 秒,兩條 DB 路徑都是 4.034 秒。後續比較相同情境時,就可以分別追蹤接手耗時和使用者實際遇到的失敗區段。
Proxy 接手處理的是入口。Primary 故障還需要完成資料庫角色切換。這次我們停止目前的 Primary VM,持續使用相同的 DB-RW VIP,觀察 Patroni 選出新 Primary、HAProxy 更新 Backend,直到應用程式連續完成三次 Commit。
U06 保存寫入結果,C05 保存角色與 Backend 變化,R04 則記錄舊 Primary 以 Replica 回歸。這些紀錄讓我們能把服務恢復和備援回復分開檢查。
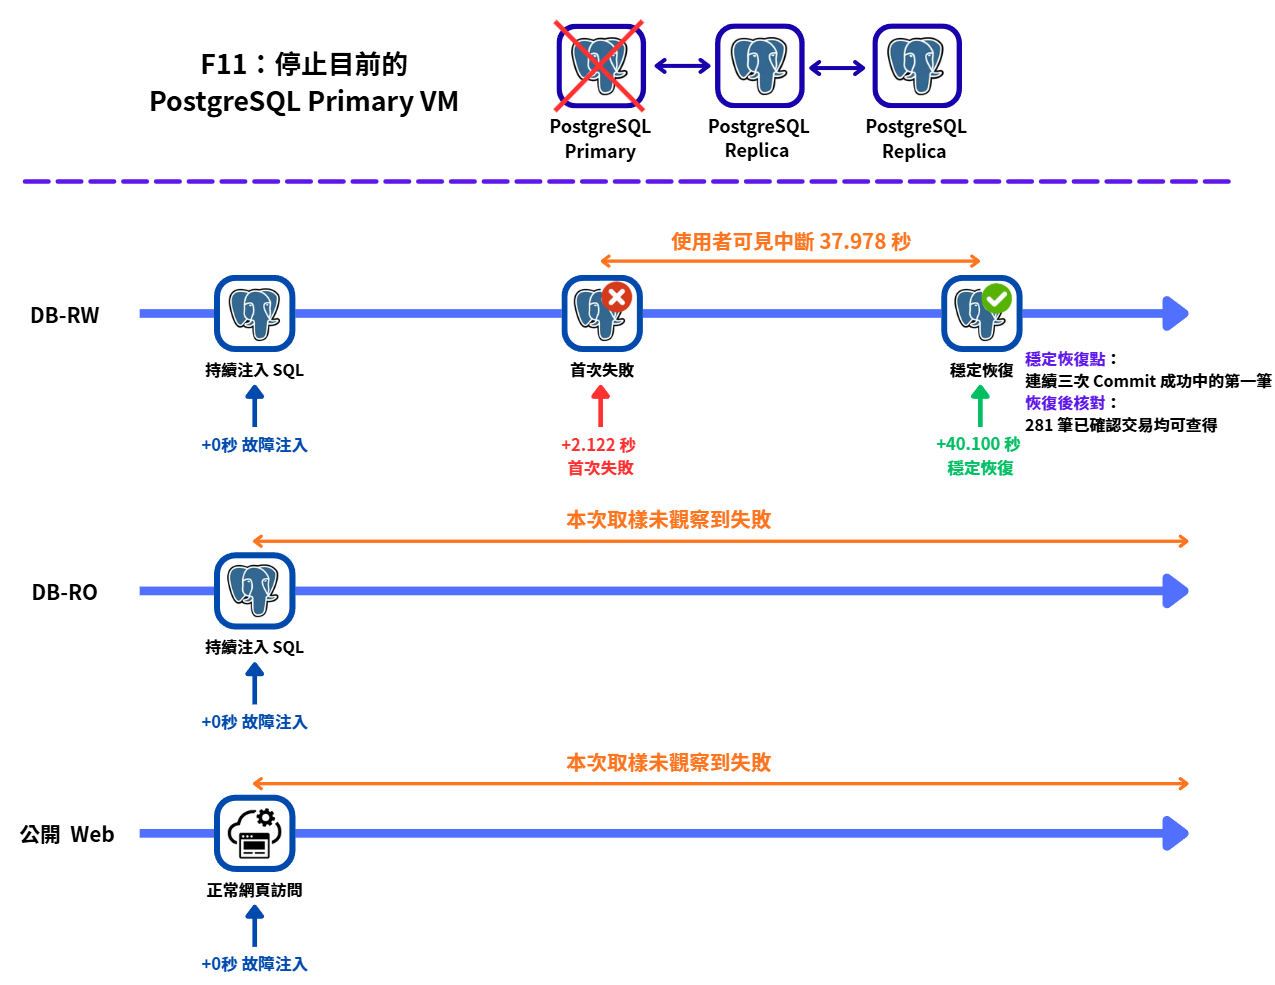
圖(四)F11 將 DB-RW 使用者中斷、角色切換結果與已確認交易核對放在同一條服務時間線
圖(四)的三條路徑依賴不同元件,因此故障結果也不同:
/primary 健康檢查辨識新角色後,新的 DB-RW 連線才會送到它,因此這條路徑出現中斷。/replica?lag=64MB 檢查會保留這台合格節點,新的唯讀連線仍能送到它,所以本次取樣持續成功。/health,路徑經 Cloudflare、Web VIP、Nginx 到 App,回應內容不需要查詢 PostgreSQL。Primary 故障沒有切斷這條路徑,所以本次取樣沒有看到失敗。需要寫入資料庫的網站功能仍會受到 DB-RW 切換影響。這正是分層高可用性的作用:發生故障時,入口維持不變,代理把新請求送到仍符合角色與健康條件的節點,影響也能限制在真正依賴故障元件的功能。本次 DB-RW 的 RTC 為 40.100 秒,探測到的可見中斷為 37.978 秒。
切換後,我們逐筆核對已收到成功回覆的 281 筆交易,新 Primary 全部可查得,missing_acknowledged_rows=0。這表示本次樣本缺少 0 筆已確認交易。往後提高寫入負載或改變故障時機,需重新核對其他條件下的資料保留能力。
前幾天的 Lab 已經留下多次節點接手紀錄。把這些結果和 Day 30 的端到端測試接在一起,可以看到四個層次各自處理不同故障:
| 高可用層次 | 實測結果 | 結論 |
|---|---|---|
| PVE 與 Ceph | PVE 節點故障後,HA Manager 將測試 VM 重新指派。節點回復後 Ceph 回到 active+clean |
運算服務可在其他節點重新啟動,共享儲存也能恢復副本穩態 |
| Web Backend | 停止 app01 後,Nginx 保留健康的 app02,287 筆 Web 樣本均成功。F11 的公開 /health 也未受 Primary 切換影響 |
本輪單一 App 節點故障未造成可觀察的 Web 中斷。不存取資料庫的健康探測也未受資料庫角色切換影響 |
| Proxy 與 VIP | Nginx、HAProxy 程序故障與 Proxy VM 正常關機時,另一台 Proxy 可接手對應 VIP。F10 再驗證 Proxy VM 突然停止後三組入口均恢復 | 用戶端維持相同 Hostname 與 VIP,由存活代理接手並轉送新連線 |
| PostgreSQL | Switchover、Failover 已驗證角色、時間軸與舊 Primary 回歸。F11 再驗證 DB-RW 恢復、DB-RO 持續服務,且 281 筆已確認交易均可查得 | 存活 Replica 可接手寫入,另一台合格 Replica 繼續提供唯讀查詢 |
這些結果支持本系列在平台、Web Backend、代理入口與 PostgreSQL四個受測層次具備高可用性。單一元件故障時,服務可以由同層的其他節點接手,使用者仍透過原本的名稱或 VIP 連線。Web 的結論以本次 /health 路徑為範圍。整套 Lab 也仍共用單一 L0 Host、OPNsense、交換器與實體磁碟。因此目前能確認的是程序與 VM 故障的接手能力,實體主機、網路設備、電力與站點層級則需要獨立基礎設施再驗證。
前面的 40.100 秒以成功寫入為終點。此時舊 Primary 可能還在回歸,叢集已提供服務,但暫時少了一份備援。平台與儲存的測試也有同樣的差別:
| 證據 | 觀察範圍 | 本次紀錄 |
|---|---|---|
F02/U01 |
從 PVE 節點故障到測試 VM 重新回覆 Ping | 223.006 秒 |
R01 |
從 pve03 重新啟動到 Ceph HEALTH_OK、PG 全部 active+clean |
53.756 秒 |
第一筆表示 VM 網路恢復,第二筆表示節點重啟後儲存副本恢復。它們從不同操作開始計時,適合分別評估 VM 接手與儲存回復,不能相加當成同一次服務中斷。
因此,我會把事故紀錄分成服務可用、降級運作、完整穩態三種狀態。使用者請求恢復後,還要確認 Replica、儲存副本與代理備援回到預定數量,才能安排下一次維護或故障演練。
Primary 切換已確認這輪交易完整,但備份復原面對的是另一種情境:如果來源資料無法使用,只能依靠 Repository 中的備份與 WAL,能恢復到哪個時間點?
這部分沿用 Day 28 的 F08/R03 WAL Archive 中斷測試。它模擬的是備份復原鏈先停止前進,接著來源叢集發生無法直接復原的事故,只能依靠備份儲存庫(Repository)重建資料的情境。故障注入會把目前 Primary 的 archive_command 暫時改成 /bin/false,停止向 backup01 Repository 執行 Archive Push。PostgreSQL 節點之間的 WAL 串流複寫仍然運作,正式叢集也繼續接受交易。我們在來源端持續寫入帶有序號與時間的樣本並保存成功回覆,再把指定時間視為來源叢集失效的事故點,從隔離還原端查出 Repository 最後可恢復的樣本。
真實環境可能因 backup01 停機、Repository 磁碟滿載、網路或 SSH 路徑故障、權限改變,以及 archive_command 設定錯誤而停止歸檔。故障期間通常不會立即中斷資料庫服務,卻會讓 PITR 的復原邊界停在最後成功封存的 WAL。若此時再遇到整個來源端儲存損毀、勒索軟體或其他共同故障,之後成功提交但尚未封存的交易就無法從 Repository 還原。
| 證據 | 驗證結果 | 本次附帶紀錄 |
|---|---|---|
F08/R03 |
Archive 停滯期間正式叢集仍可提交交易。Repository 還原後能找出最後成功封存的資料邊界 | 模擬事故與最後可見交易相差 19.623 秒、15 筆。恢復 Archive Push 後 3.550 秒追上指定 WAL |
F07/R02 |
備份與 WAL 能在隔離 Restore VM 完成 PITR,並核對誤刪前資料 | 從開始還原到資料驗證完成為 21.187 秒 |
F08 的數值來自受控的中斷時間與寫入頻率。實際 RPC 還要納入正常歸檔延遲、故障偵測、修復時間、WAL 追趕速度及不同負載。F11 的零筆缺口則描述存活 Replica 接手的另一條復原途徑,兩種情境需要分開驗收。
F07/R02 的 21.187 秒會隨資料量、WAL 重播量、Repository 與網路速度、壓縮方式及平行處理能力改變。它證明這份備份可以完成 PITR,但只記錄本次小型資料集執行既定程序的速度。完整服務 RTC 還要使用接近實際規模的資料,並納入事故判斷、環境準備、入口調整及重新開放服務。
服務切換成功後,我也要確認維運人員多久會收到異常訊號,以及服務恢復後告警多久清除。因此,A03 另外安排了一輪 Primary VM 故障補測,完整記錄三個 Metrics Target 與告警狀態。
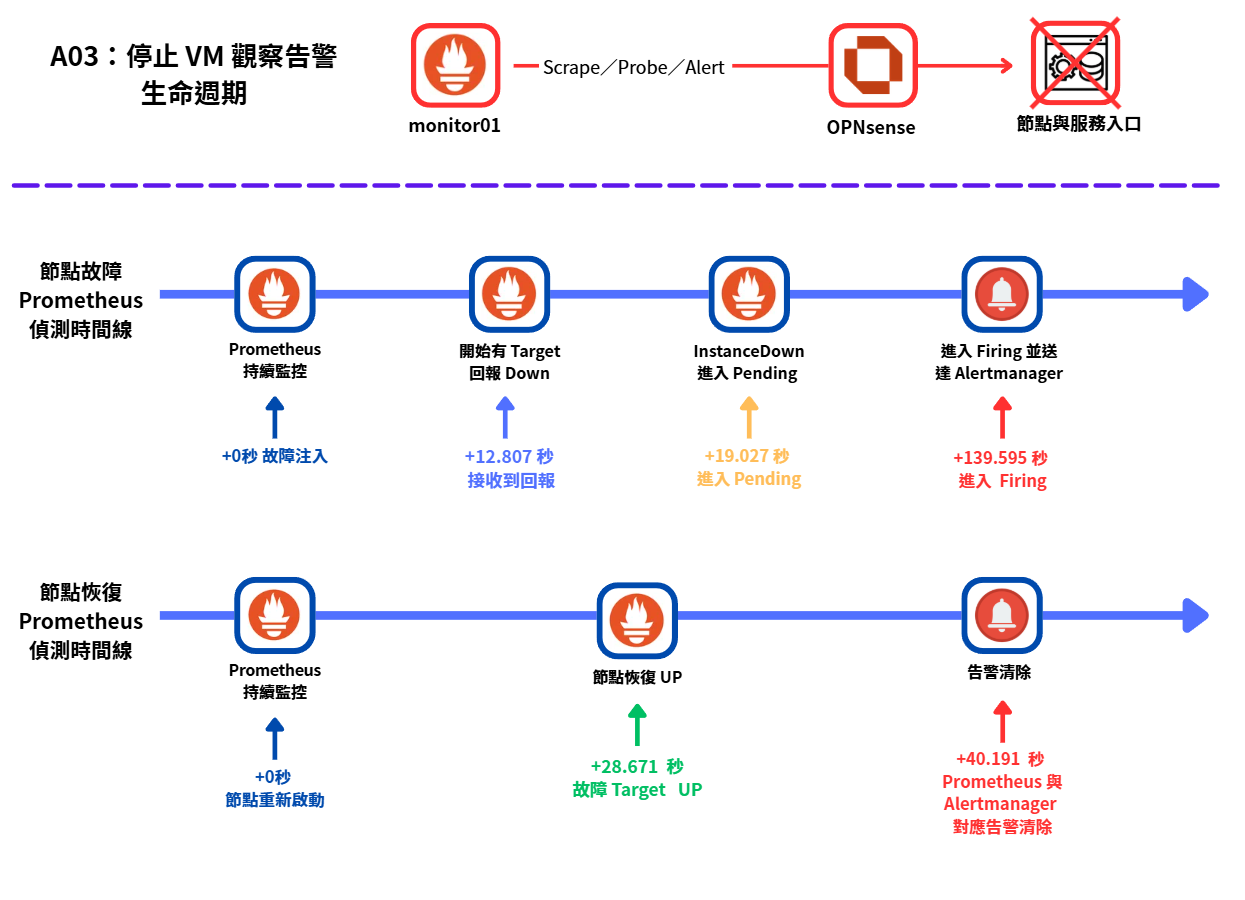
圖(五)A03 告警補測分別以故障注入與重新啟動作為起點,呈現偵測及清除時間
這裡的 Pending 表示條件已成立、正在等待規則設定的 for: 2m 持續時間。滿足時間並完成規則評估後,告警才進入 Firing。因此從故障到 Firing 的 139.595 秒,包含探測、規則評估和等待期間。
重新啟動後,三個 Target 在 28.671 秒全部 Up,告警在 40.191 秒清除。Target 的抓取與告警規則各有評估時程,所以恢復可抓取和解除告警會有時間差。
這輪結果讓我們能評估告警規則是否符合維運需要:若希望掌握較短的切換事件,可以評估縮短持續時間,或增加服務層的探測規則,同時注意短暫波動造成的告警量。即使某次故障在進入 Firing 前已恢復,探測紀錄仍能保留使用者受到的影響。
這次 client01 可以在同一 VLAN 直接連到 app01 的 TCP 22,所以依照所有 SSH 管理連線都經過 jump01 的驗收條件,F12 記為 FAIL。測試確認的是 TCP 22 可直達。實際登入仍須通過 SSH 身分與金鑰驗證。
這個結果其實在我的預期之內,也和整個系列的篇幅取捨有關。如果一路跟著實作文件操作,可能會發現部分截圖中的建置時間與文章天數不完全一致。這是因為整套架構曾經調整過很多次,我也持續依核心內容與讀者理解順序重新安排實作。
原本的規劃中,我會用一天替各台主機逐一建立完整的防火牆規則。後來受限於篇幅,我保留了防火牆觀念、設計方法與重要服務示範,並在實作文件補上部分必要的主機規則。完整收斂每台主機的 SSH 來源則留作延伸。因此這次直連成功符合目前配置,也明確指出下一步:若要讓所有 SSH 管理連線集中經過 jump01,還要在目的主機限制核准的來源位址。
同 VLAN 流量可能直接在第二層交換,F12 因此也驗證了防火牆控制點是否位於實際路徑上。這裡保留 FAIL,讓後續接手環境的人能直接看見尚待處理的管理入口缺口。
看完結果,我們已經有服務恢復、資料缺口和告警速度三組紀錄。它們能協助評估架構與操作流程,但要制定 RTO/RPO,還需要加入業務影響。
實際服務會由業務與技術人員一起做營運衝擊分析(Business Impact Analysis,BIA):整理關鍵操作、停機損失、資料補登成本、契約要求與相依服務,再核准可接受的中斷及資料缺口。這也決定我們願意投入多少資源在待命、備份與異地復原上。
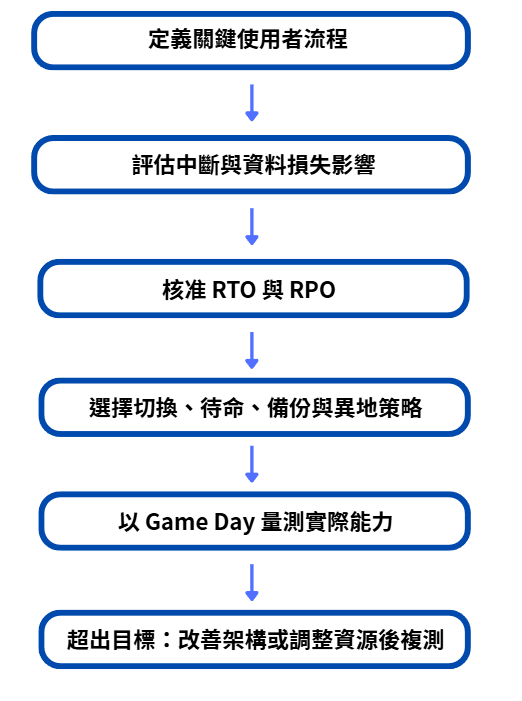
圖(六)營運需求定義目標,Game Day 驗證復原策略能否達成
我們可以拿這次測試練習判讀:
透過這樣的比較,我們就能把結果轉成具體工作:時間超出需求,檢查偵測、接手與操作流程。資料缺口超出需求,檢查複寫、歸檔與備份策略。若改善成本超出預算,則帶著實測證據和業務共同討論可接受的方案。
這套教學服務目前留下的是功能驗證、服務切換 RTC,以及指定條件下的資料缺口與還原耗時樣本。正式服務可用這些紀錄設計驗收方法,再以自己的資料量、負載、故障範圍與完整處置流程驗證核准目標。
測量結果會隨資料量、吞吐量、並行連線、版本與硬體資源改變。我建議把這次使用的觀察位置、腳本、負載與判定條件一起保存,未來才能在相同條件下比較進步或退步。
排程可以依風險安排,例如設定變更後執行連線與權限回歸,按季或半年演練元件切換與備份還原,每年安排完整 Game Day。關鍵服務或重大架構變更則提高頻率。這是規劃起點,實際週期依服務風險、變更速度與契約要求調整。
每次完成後,我會在實作文件的紀錄表留下四類資訊:
本系列使用單一 L0 Host、OPNsense、交換器、ISP/ONU 與實體磁碟,取得的是巢狀環境中程序/VM 級切換、權限邊界、PITR 與監控鏈的證據。將來部署到獨立設備或不同站點時,我們還要把電力、網路、儲存與站點故障加入演練,驗證新的故障域。
回到第一天的架構草圖,我們現在已經有可重建的 PVE 與 Ceph 平台、受控的網路與管理路徑,以及具備切換、備份復原和監控的服務。更重要的是,這套環境的能力有實際證據支撐:30 天內留下的設定、正反向測試、故障時間線、交易核對、還原結果與告警狀態,共同說明每一項能力是在什麼條件下成立。
這些證據也讓限制變得清楚。F10 與 F11 告訴我們 Proxy VM、Primary VM 故障時,使用者入口如何恢復。F07、F08 說明備份、WAL Archive 與 PITR 能保護到哪裡。F12 則保留了目前尚未收斂的同 VLAN 管理路徑。PASS 記錄能力成立的條件,FAIL 指出下一個補強範圍,兩者都會成為日後調整與複測的起點。
我希望大家帶走的,除了每一天的設定步驟,還有檢查自己環境的方法:沿著使用者路徑測試,核對資料與權限,把元件恢復、服務恢復與完整穩態分開記錄,再把實測能力和服務需求放在一起判讀。往後每次容量成長、版本更新或架構調整,都可以從這份紀錄繼續累積,讓這 30 天的 Lab 真正成為維運工作的起點。
這段原本打算留到 Day 31,讓今天少一點字數。後來想想,反正也不是第一次寫到超級長文了,就留在這裡吧 XD。這一段應該也是你們唯一能看到、比較少被 AI 潤稿的原文了。沒辦法,我的文筆真的不太好。
說回重點,不知道這 30 天有沒有真的讓大家學到東西。最初規劃這個系列時,我替自己訂了兩個方向:
這樣做的代價,就是每篇文章都長得很誇張。希望沒有人因此在半路放棄整個系列。
我開始寫這個系列,也和我之前部署 MongoDB、PostgreSQL 高可用叢集的經驗有關。那時候我在台灣很難找到一套兼具系統性與技術深度的教學(也可能是我蒐集資料的能力不足),因此踩過非常多坑:etcd 突然失效、CPU Type 設定的相容性問題,還有許多看起來只是小細節,最後卻花上好幾個小時排查。說到底,原因也是那時候我沒有徹底理解每個元件的原理與功能。
當時部署時,我確實有用 AI 協助產生許多命令。AI 可以幫我減少很多輸入命令、撰寫腳本的時間,但架構與技術細節也可能因為一個小錯而產生蝴蝶效應。這也是 Day 01 就提醒大家的事情:可以讓 AI 幫忙,卻一定要理解它替你做了什麼。我自己就是過來人,一時省下的確認時間,很可能會在故障時變成數小時的修復成本。不過,只要環境不承載正式服務,我認為偶爾把系統搞崩也不是壞事。每一次錯誤與修復,都能幫你累積很多經驗。設定文件同樣重要。如果部署後沒有驗證、沒有留下紀錄,兩年後再回頭看,很可能連自己當初做了什麼、為什麼這樣設定都想不起來。
經歷了這麼多系統錯誤與修復,又花了很多時間把這些內容重新學過一遍後,我決定把所學整理下來,替想接觸虛擬化、高可用、防火牆與資料復原的人留下一條可以照著走的路。因此,這個系列不只保留正文,也保留了完整的實作文件。
說到實作文件,整個系列我一直堅持幾件事情:手繪圖片(到目前所有做出來的圖應該超過 100 張了)、可重現的操作步驟,以及能支持結論的實測證據。這真的非常累。文件裡的命令我都有完整執行、排錯和修正過,就是希望大家可以照著操作,不必再額外排錯。遇到純文字不容易理解的段落,我也會再畫成圖片輔助說明。也因為這些工作,一篇文章從部署、除錯、查閱官方文件和其他教學,到驗證技術、整理草稿與繪圖,至少都要投入十個小時以上。AI 讓其中一些工作容易許多,但最後的技術安排、驗證方式與講述順序,以及講解不夠清楚時的反覆修正,仍然要花很多時間。
如果要替這個系列選出兩個最重要的概念,我認為是高可用與可驗證。高可用麻煩的地方,在於完成部署後一定得手動執行故障測試,才知道接手機制是否真的正常運作。這就是加入可驗證這個概念的原因。我希望正文說明的原理與實際部署的結果,都能在 Lab 裡完整重現。為了讓大家更完整地理解 PVE、高可用與安全邊界,整套架構前後大改了三次。有些內容甚至已經部署完成,最後仍全部刪除重來,只因為新的安排能讓文章更完整、也更容易理解。
以前看到有人說,會來寫鐵人賽的人多少都有點抖 M,我還想說有這麼誇張嗎?現在回頭看,我可能就是最 M 的那一個。至少我可以負責任地告訴自己:這 30 天不是讓 AI 生成一堆沒有驗證的內容。每項技術、實作和證據都有認真安排。當然,範圍實在太廣,如果有些地方仍讓你覺得跳躍,我也真的很抱歉。更希望這個系列最後有替你帶來一些實際有用的東西。就這樣吧,完結灑花~~
差點忘了,我想在這裡再補充原本刪除的章節,以及把這套 Lab 搬到正式環境前需要正視的幾個缺口,以防真的有人準備直接搬到正式環境,應該沒有吧。
這些題目未來有機會,也許會變成下一次鐵人賽的系列。這次就真的走到最後了——完結灑花!


 iThome鐵人賽
 看影片追技術