
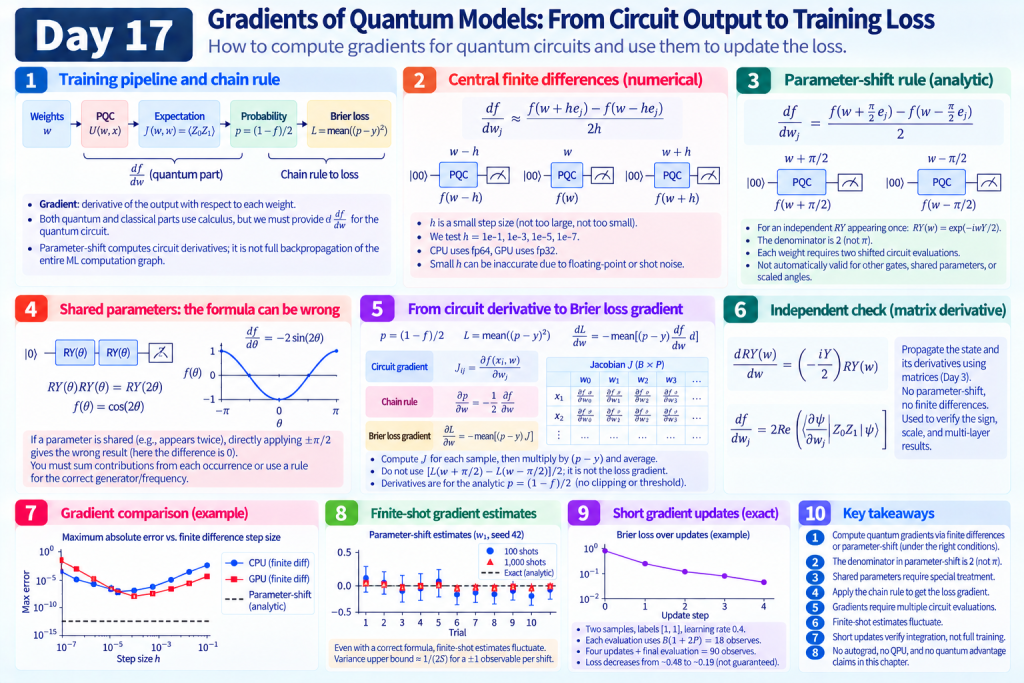
Day 15 用不需要梯度的座標搜尋調權重;Day 16 比較了 QNN 與 MLP。今天補上另一條訓練路:怎麼算出「某個權重微微改變時,輸出與損失會怎麼動」,讓最佳化器能沿著這個方向更新。
想像調音:你想知道「某個旋鈕往右一點,雜訊變大還是變小」。一種做法是左右各轉一點,看差值(有限差分);在特定條件下,量子電路還有一種更乾淨的公式——把旋鈕固定往左、往右各轉四分之一圈,再用兩次電路結果算出斜率(參數位移法)。算出電路斜率之後,還要再接上「分數 → 機率 → 損失」這幾段,才得到真正用來更新權重的梯度。
程式:gradients.py、experiment.py、demo.py。沿用 Day 14 的獨立 RY 權重;沒有用 PyTorch autograd,也沒有在真實量子處理器(QPU)上跑。
Day17 implements central finite differences, parameter-shift gradients for independent RY weights, matrix reference derivatives, and the chain rule into Brier loss. Short exact-simulator updates and finite-shot gradient samples are recorded without claiming QPU results, autograd parity, or quantum advantage.
weights → PQC → f=⟨ZZ⟩ → p=(1−f)/2 → Brier loss
導數=某個量對某個權重的變化率;梯度=把各權重的導數排成一條向量。鏈式法則把相連步驟的變化率乘起來。
一般損失可用一般微積分;量子段需要提供 df/dw。參數位移法是取得電路期望值導數的一種方法,不等於整個機器學習計算圖的反向傳播(從最終誤差一路往回算)。
本日對每個參數逐一跑「位移後的電路」。沒有存每個閘的中間輸出再倒傳,也沒有用模擬器伴隨微分(利用可存取狀態、沿反向操作算導數)。這些做法的成本與前提不同,不能一句「都是 backprop」帶過。
df/dw_j ≈ [f(w + h e_j) − f(w − h e_j)] / (2h)
只動第 j 個權重:左右各偏 h,用差值除以距離估斜率。h 太大,近似偏離真導數;h 太小,浮點相減與抽樣噪音會被 1/(2h) 放大。不是越小越好。
本日比較 h = 1e-1, 1e-3, 1e-5, 1e-7。CPU 用 fp64、GPU 模擬用 fp32。有限差分是診斷圖,不要求每個 h 都通過同一誤差門檻;故意保留小步長在 fp32 上可能失準的數字(結果紀錄裡 GPU 在 h=1e-7 誤差可到約 0.8)。
對「只出現一次」的獨立 RY,RY(w)=exp(−iwY/2):
df/dw_j = [f(w + π/2 e_j) − f(w − π/2 e_j)] / 2
重點:分母是 2,不是 π。這不是把有限差分的 h 隨便設成 π/2。公式依賴這類旋轉的生成元結構(此處頻譜為 ±1/2);Schuld 等人推導了這類解析位移梯度。[P3]
等價寫法:
plus = weights.copy()
minus = weights.copy()
plus[j] += np.pi / 2
minus[j] -= np.pi / 2
gradient[j] = 0.5 * (predict(x, plus) - predict(x, minus))
Day 9/14 每個權重只控制一個 RY,符合本例;一層四個、兩層八個獨立權重。這不自動適用任意閘、不同生成元、縮放角度或共享權重。
若同一 θ 出現在連續兩個 RY:RY(θ)RY(θ)=RY(2θ),讀 Z 得 f(θ)=cos(2θ):
真實導數 = −2 sin(2θ)
把共享 θ 同時 ±π/2:差值為 0  ← 錯
必須把各出現位置的導數加總,或改用符合該頻率/生成元的規則。若實際角度是 a*w+b,還要再乘一般鏈式法則的 a。測試保存這個反例,避免把兩點公式當萬能黑盒。
Brier=預測機率與 0/1 標籤的平均平方誤差。p=(1−f)/2、L=mean((p−y)²),因此:
dL/dw = −mean[(p−y) df/dw]
values = np.array([predict(x, weights, config) for x in features])
p = (1 - values) / 2
jacobian = np.array([parameter_shift(x, weights, config) for x in features])
gradient = np.mean(-(p - labels)[:, None] * jacobian, axis=0)
jacobian 每列一筆資料、每欄一個權重。不能直接算 [L(w+π/2)−L(w−π/2)]/2 就說得到損失梯度:平方等一般處理會改變函數形狀。單量子位元 Brier 反例會驗證兩者不一致。
本日對未截斷的解析 p=(1−f)/2 求導;分類門檻不在這條損失路徑裡。若計算圖另加截斷或硬門檻,導數要另處理。
matrix_gradient 用 Day 3 矩陣,逐閘傳遞狀態與狀態對參數的導數,不走位移、也不走有限差分:
dRY(w)/dw = (−iY/2) RY(w)
df/dw_j = 2 Re[⟨∂ψ/∂w_j|ZZ|ψ⟩]
用來獨立檢查位移的符號、倍率與層數。損失梯度再與 NumPy 完整 Brier 的中央差分(h=1e-5)比對,核對外層鏈式法則。測試也涵蓋振幅編碼的兩層模板;主要掃描固定角度編碼。
參考結果:參數位移相對矩陣參考,CPU 最大誤差約 1e-15 量級;損失梯度誤差約 1e-11。
每個權重要正、負兩次位移。P 個獨立權重、B 筆資料:
期望值雅可比:2PB 次位移前向
損失+梯度:B(1+2P) 次前向(含算原始 p)
本日 B=2、P=4 → 每次損失+梯度 18 次 observe。四次更新 w ← w − 0.4 × gradient,再在最終權重評估一次 → 五次梯度評估、90 次 observe(不含診斷掃描與抽樣)。
兩筆特徵 [[0.25,-0.4],[-0.6,0.2]]、標籤皆為 1。這是梯度更新整合檢查,不是重訓 Day 15 分類器;沒有 holdout、沒有準確率。固定學習率一般不保證每步損失都降;本次約從 0.48 降到 0.19,如實保存,不依測試集調步長。
固定種子 42 權重、特徵 [0.25,-0.4] 的 w1 導數:每側 100/1,000 shots,各十對抽樣種子。每個估計是兩次 ZZ 差的一半。
解析位移成立 ≠ 有限抽樣剛好等於真值。若兩側抽樣獨立:
Var(ĝ) = [Var(f̂₊) + Var(f̂₋)] / 4
對 ±1 可觀測量、每側 S shots,變異數上界約 1/(2S)。十次重複是小型展示;結果紀錄中 100→1000 shots 的 RMSE 約從 0.047 降到 0.014,但不保證每次加 shots 都單調變好。本日沒有把「含噪的 p」乘「含噪的雅可比」宣稱成無偏損失梯度。
沿用 .venv;固定依賴見 requirements-day17.txt。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day17/demo.py
OMP_NUM_THREADS=1 python articles/day17/experiment.py
OMP_NUM_THREADS=1 python articles/day17/experiment.py --backend nvidia
OMP_NUM_THREADS=1 python articles/day17/plot_results.py
OMP_NUM_THREADS=1 python articles/day17/plot_results.py --backend nvidia
每個後端:L=1/2 × 三筆特徵 → 六組電路梯度;每組四種 h → 24 筆差分對照;另有五筆短更新與 20 筆有限 shots 梯度估計。
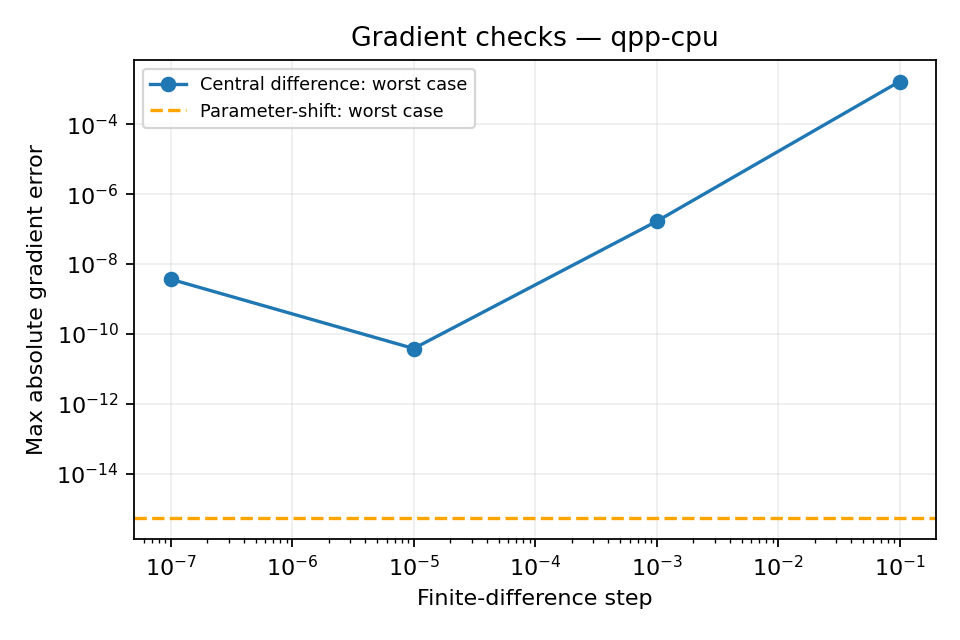
圖示各 h 在所有設定/參數上的最大誤差;虛線是參數位移法最大誤差。輸出在 results/day17/<backend>/;可用 --output-dir /tmp/day17-check 另存。細節見 結果紀錄。
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day17 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY17_TARGET=nvidia python -m unittest discover -s articles/day17 -p 'test_*.py' -v
五個測試涵蓋:差分與輸入檢查、角度/振幅位移、矩陣導數與 NumPy 差分、損失鏈式法則、損失直接位移反例、共享參數反例。
本日實作並獨立核對參數位移,用反例標出公式邊界,把電路導數接到損失,並分層記錄評估成本與有限 shots 波動。這是可核對的梯度路徑示範,不是完整分類器重訓報告。仍是無雜訊模擬器結果,沒有 QPU 或量子優勢宣稱。
下一篇 Day 18 做經典與量子模型在固定條件下的效能比較。
[P3] Maria Schuld, Ville Bergholm, Christian Gogolin, Josh Izaac, Nathan Killoran. “Evaluating analytic gradients on quantum hardware.” Physical Review A 99, 032331 (2019). 出版商/DOI,arXiv:1811.11184。預印本 2018;正式出版 2019。
2026-09-07 核對作者、題名、年份、DOI 與兩次位移電路主張;本日 RY 公式、鏈式法則與反例由獨立矩陣導數/解析式核對。索引:REFERENCES.md。
[N5] Brian Coyle et al. “Training-efficient density quantum machine learning.” npj Quantum Information 11, 172 (2025);研究論文。原始來源;完整書目。
本章核對參數位移與鏈式法則;這篇研究可延伸比較特定結構下的梯度成本。位移公式仍須依各閘條件使用。


 iThome鐵人賽
 看影片追技術