
Elastic Load Balancer(ELB) 負責把使用者的請求分給多台 EC2;Auto Scaling group(ASG) 負責自動增減 EC2 的數量,並補上壞掉的機器。兩個幾乎都是一起用。
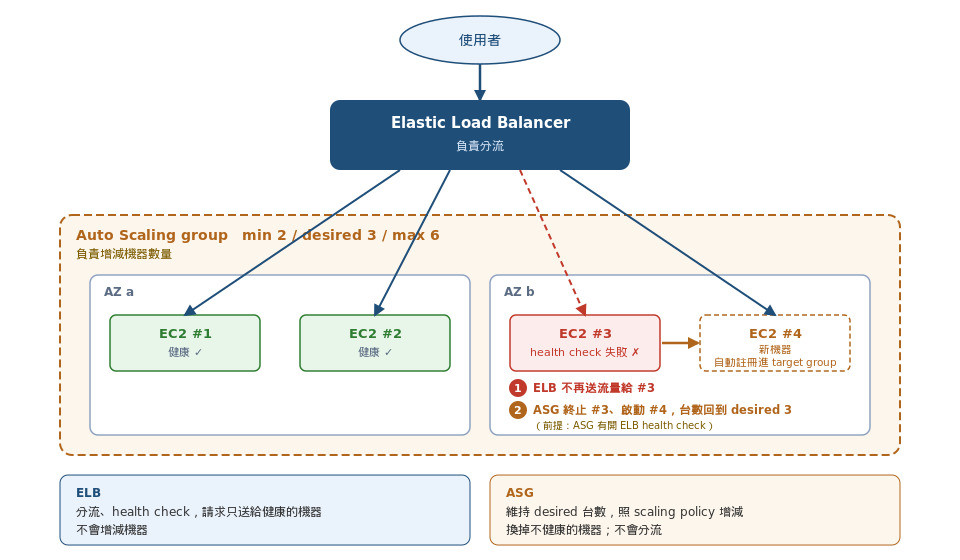
ELB:把請求轉給後面的機器
使用者不直接連 EC2,而是連 ELB 的網址(一個 DNS 名稱),再由 ELB 把每個請求轉給後面其中一台機器。後面有幾台、換了哪一台,使用者都不用知道。ELB 後面這群機器叫 target group。
ELB 會定期檢查每台機器能不能正常回應,這叫 health check。圖中的 #3 檢查失敗,ELB 就不再把請求轉給它(①)。但 ELB 只會跳過壞掉的機器,不會關掉它,也不會開新的來補。
ASG:讓機器數量維持在合適的範圍
建 ASG 時要設三個數字:
| 設定 | 意思 | 圖中 |
|---|---|---|
| min | 最少幾台,再怎麼縮也不會低於這個數 | 2 |
| desired | 現在應該有幾台,ASG 會一直把實際台數維持在這個數 | 3 |
| max | 最多幾台,再怎麼擴也不會超過這個數 | 6 |
實際台數少於 desired,ASG 就開新的補上。圖中的 #3 壞掉後被 ASG 終止,ASG 開了 #4,台數回到 3(②)。新機器會自動加進 target group,ELB 就開始把請求轉給它。
desired 也不是固定的。流量變大時,ASG 把 desired 調高(例如 3 → 5);流量變小時再調低,但一定落在 min 和 max 之間。
所以兩個要一起用:只有 ELB,機器壞了沒人補,能服務的機器越來越少;只有 ASG,新開的機器沒人把請求轉過去。再把機器分散在兩個以上的 AZ,一個 AZ 出事,另一個 AZ 還能繼續服務,這才是高可用。
上面的流程有兩個細節還沒交代:ASG 怎麼知道 #3 壞了,以及 desired 什麼時候調、調多少。
ELB 和 ASG 各有一套檢查方式,看得出來的問題不一樣:
| 檢查什麼 | 看得出來的問題 | |
|---|---|---|
| ELB health check | 定期打一個網址(例如 /health),看有沒有正常回應 |
應用程式掛了:process 死了、port 沒在聽、回 500 |
| EC2 狀態檢查(ASG 預設用這個) | 機器本身有沒有開著、有沒有通過 EC2 的系統檢查 | 只看得出機器本身壞了 |
ASG 預設只用 EC2 狀態檢查。所以如果 #3 是機器還開著、但應用程式掛了,ELB 會停止把請求轉給它,ASG 卻認為它是健康的、不會換掉。結果這台機器一直佔著名額,卻沒有在服務。
解法是把 ASG 的 health check type 加上 ELB,讓 ASG 也採用 ELB 的檢查結果。這樣圖中的 ② 才會發生:
ASG health check type: EC2 + ELB
ELB health check:      HTTP GET /health,每 30 秒一次,連續 2 次失敗算 unhealthy
→ ELB 判定 unhealthy → ASG 收到 → 終止這台、啟動新的
前面提到流量變大時,ASG 會調高 desired。調整的規則叫 scaling policy,有四種:
| Policy | 做法 | 什麼時候用 |
|---|---|---|
| Target tracking | 設一個目標值,例如平均 CPU 維持 40%,ASG 自己算該加減幾台 | 沒有特別條件時就選它,也是考題的預設答案 |
| Step scaling | CPU 超過 60% 加 1 台、超過 80% 加 3 台,階梯式,每一階自己定義 | 要對不同程度的負載做不同反應 |
| Scheduled | 知道每天早上九點會湧進來,提前排程加台數 | 流量有固定時段 |
| Predictive | 用機器學習看歷史流量,自己排程 | 流量有規律週期,又不想手動排 |
Target tracking policy
Metric:  ASGAverageCPUUtilization
Target:  40%
→ CPU 平均升到 60%:ASG 算出要加幾台才能壓回 40%,直接加
→ CPU 平均降到 20%:反過來減,但不會低於 min
每次加減台數之後有一段 cooldown(預設 300 秒),這段時間內不會再調整,避免剛加的機器還沒開好,又因為 CPU 還高而再加一次。
最後回到 ELB。建立 ELB 時要先選類型:ELB 是統稱,底下有三種,差在能不能看懂請求的內容:
考題主要比較前兩種:
| Application Load Balancer(ALB) | Network Load Balancer(NLB) | |
|---|---|---|
| 看第幾層 | L7:HTTP/HTTPS/WebSocket/gRPC | L4:TCP/UDP/TLS |
| 會做的事 | 看 URL 路徑、host、header 決定送去哪個 target group | 只看 port,原封不動轉送 |
| IP | 只有 DNS 名稱,沒有固定 IP | 每個 AZ 一個固定 IP,可以掛 Elastic IP |
| 效能 | 一般 web 夠用 | 每秒百萬級連線、極低延遲 |
| 什麼時候選 | 大部分 web 應用;要靠路徑把 /api 和 /static 分給不同 target group |
客戶要把固定 IP 加進防火牆白名單;非 HTTP 協定;極端效能 |
判斷只看兩件事:協定是不是 HTTP?需不需要固定 IP? HTTP 且不需要固定 IP → ALB;其他 → NLB。「客戶防火牆只能開特定 IP」幾乎就是在指 NLB。
ALB 看得懂網址,所以一個 ALB 可以同時服務好幾個服務:依請求的網域或路徑,轉給不同的 target group。
https://example.com/api/orders  → api-servers    (路徑是 /api 開頭)
https://shop.example.com/cart   → shop-servers   (網域是 shop)
其他請求                         → web-servers
NLB 看不懂網址,做不到這件事。所以題目裡有好幾個服務、要降低 Load Balancer 費用時,答案常是合併成一個 ALB,用網域或路徑分流。
| 主題 | 說明 |
|---|---|
| Sticky session | 同一個使用者的請求固定送到同一台(靠 cookie)。應用程式把 session 存在機器本地時才需要;代價是負載可能不平均。存到 ElastiCache 或 DynamoDB 就不用 |
| Cross-zone load balancing | ALB 預設開、不收費,流量平均分到所有 AZ 的所有機器;NLB 預設關,開了跨 AZ 流量要收費 |
| Deregistration delay | 機器要從 target group 移除時,先等進行中的請求做完(預設 300 秒)才真的移除,不會硬砍。舊名 connection draining |
| SSL 憑證 | 放在 ELB 上終止 TLS,憑證用 ACM 管;一個 listener 可以掛多張憑證(SNI),不同網域各用各的 |
| Launch template | ASG 開新機器用的樣板:AMI、instance type、SG、user data。改了樣板,之後開的機器才會用新的,舊機器不會自動換 |
| ASG 本身免費 | 只付 EC2 的錢;ELB 另外按小時和流量計費 |
| 概念 | 說明 |
|---|---|
| ELB | 分流、health check、SSL 終止。不會增減機器 |
| ASG | 用 min/desired/max 控制台數,照 policy 增減,換掉不健康的。不會分流 |
| ELB health check | ASG 的 health check type 加上 ELB,才會換掉應用程式掛了、但機器還開著的那種 |
| Target tracking | 設一個目標值讓 ASG 自己算,預設選它 |
| ALB vs NLB | HTTP 且不需要固定 IP → ALB;非 HTTP、要固定 IP、極端效能 → NLB |
摘要:ELB 分流、ASG 顧台數,兩個一起用、跨兩個以上的 AZ,才是高可用。ASG 要加上 ELB health check 才抓得到應用程式掛掉;scaling policy 先用 target tracking;選 Load Balancer 看協定和要不要固定 IP。
下一篇是 Route 53 和 CloudFront:使用者打的網址是怎麼變成 ELB 的 DNS 名稱的,還有 CloudFront 為什麼要擋在前面。
某電商公司把系統拆成 4 個微服務,分別使用
shop.example.com、api.example.com、admin.example.com、img.example.com四個網域,全部走 HTTPS。目前每個服務前面各放一個 Application Load Balancer,後端是各自的 Auto Scaling group。財務部門發現 4 個 ELB 的固定小時費用占比偏高,要求降低這部分成本。使用者存取的網址不能改變,各網域的憑證也必須繼續由 ACM 自動續約。
哪一個方案最符合成本效益(MOST cost-effective)?
某公司的訂單服務跑在 Auto Scaling group(min 4)中的 EC2 上,前面是 ALB,target group 以
HTTP GET /health做健康檢查。應用程式偶爾會因記憶體洩漏卡死,/health開始回應 503;ALB 會把這台標記為 unhealthy 並停止送流量,但機器一直留在群組裡,可服務台數逐漸變少,每次都要值班人員手動終止。新機器從開機到應用程式可服務約需 4 分鐘。
在維運負擔最低(LEAST operational overhead)的前提下,解決方案架構師應該怎麼做?
StatusCheckFailed 的 CloudWatch 警示,觸發 EC2 reboot 動作自動重啟機器SetInstanceHealth
某線上訂票公司的網站跑在 ALB 後方的 Auto Scaling group,以 target tracking policy 將平均 CPU 維持在 50%。頁面內容都依使用者的即時查詢產生。每月 1 日 10:00 固定開賣熱門演唱會門票,開賣後 5 分鐘內流量會升到平常的 8 倍、持續約 1 小時,其他日子則偶有無法預測的小尖峰。新機器靠 launch template 的 user data 在開機時安裝套件、下載程式碼,約 6 分鐘後才能服務,導致每次開賣的前幾分鐘大量請求逾時。公司要消除開賣時的逾時、加快應對非預期尖峰,但不願平時就維持尖峰台數的成本。
解決方案架構師應該採取哪兩項做法?(選擇兩項)
某 B2B 平台的 HTTPS API 架在 ALB 後方,ALB 以路徑規則把
/orders/*與/invoices/*分別送到兩組 Auto Scaling group。新簽約的幾家大型客戶都在台灣,和 API 所在的 ap-northeast-1 距離很近,但他們的防火牆只允許連往事先登記的固定 IP。公司要求保留現有 ALB 的路徑分流設定,並以最符合成本效益(MOST cost-effective)的方式提供固定 IP。
解決方案架構師應該怎麼做?
某公司的 Web 服務跑在 ALB 後方的 Auto Scaling group,12 台 EC2 平均分布在 3 個 AZ。資安團隊發布 OS 漏洞修補後,維運團隊建好了修補過的新 AMI,也建立了 launch template 的新版本並設為這個群組使用的版本。一週後稽核發現,12 台機器仍然全部跑舊 AMI。公司要求在服務不中斷、過程中可服務容量不低於 90% 的前提下,以最少的人工操作把所有機器換成新 AMI。
解決方案架構師應該怎麼做?
ALB 的一個 HTTPS listener 可以透過 SNI 同時掛多張 ACM 憑證,再用 host-based 規則依網域把請求送到不同的 target group。4 個服務合併到 1 個 ALB,就省下 3 個 ALB 的固定小時費用;網址不變,憑證也還是掛在 ALB 上由 ACM 自動續約。
A 是常見誤解:Compute Savings Plans 只折抵 EC2、Fargate、Lambda 的運算費用,ELB 的費用不在折扣範圍內。B 雖然也只剩一個 Load Balancer,但 NLB 不看 host header,只能靠不同的 port 區分服務,使用者的網址就得帶上 port,違反「網址不能改變」。D 看起來最省,但 ACM 的自動部署與續約只對掛在 ALB 這類整合服務上的憑證生效,憑證搬到每台 instance 上就得自己安裝與更新,違反「由 ACM 自動續約」;而且 Auto Scaling group 替換機器後 IP 會變,DNS 紀錄還得跟著維護。
Auto Scaling group 預設只看 EC2 狀態檢查,機器活著、應用程式卡死時不會被判定為不健康。把 health check type 加上 ELB 之後,ALB 判定 unhealthy 的機器就會被 Auto Scaling group 終止並補上新的,完全不需要自己寫程式。grace period 設為 300 秒,比 4 分鐘的啟動時間長,新機器才不會在應用程式還沒起來時就被誤判終止。
B 輸在診斷錯誤:這台機器的 OS 和硬體都正常,StatusCheckFailed 根本不會觸發,警示永遠不會動作。C 技術上做得到,SetInstanceHealth 也是真實存在的 API,但這等於自己重做 Auto Scaling group 內建的功能,還要維護 Lambda 和排程,維運負擔最高。D 只是用多付錢的方式掩蓋症狀:卡死的機器依然不會被替換,只要卡死的台數多過多開的那 2 台,可服務台數一樣會掉下去。
開賣時間是固定的,排程動作可以在開賣前 15 分鐘先把台數拉上去,新機器有足夠時間完成那 6 分鐘的啟動,開賣時已經就位;結束後再調回原值,平時不用多付錢。預先做好的自訂 AMI(golden AMI)則把開機時的安裝和下載步驟拿掉,大幅縮短新機器的就緒時間,讓 target tracking 應付非預期尖峰時也能更快補上台數。兩項各自解決一個需求,合起來才完整。
A 能消除開賣時的逾時,但整個月都維持尖峰台數,違反「不願平時就維持尖峰台數的成本」。C 的 slow start 是讓已經就緒的新機器逐步分到流量,它不會讓機器更早開好,反而讓新機器更晚分擔全部的負載。D 頁面內容都依使用者的即時查詢產生,CloudFront 能快取的部分很少,沒辦法吸收動態請求的尖峰,也沒有處理啟動太慢這個根本原因。
ALB 本身沒有固定 IP,NLB 則可以在每個 AZ 指定 Elastic IP。NLB 支援把 ALB 當成 target(ALB 類型的 target group),所以在現有 ALB 前面加一層 NLB:客戶登記 NLB 的固定 IP,流量進來後原封不動交給 ALB,路徑分流的規則完全不用改。只多一個 NLB 的費用,是最省的做法。
A 是誤解:ALB 不支援綁定 Elastic IP,這是這篇 ALB 與 NLB 對照表裡的重點。B 技術上可行,Global Accelerator 也提供兩個固定 IP、可以把 ALB 當 endpoint;但它的價值在於讓遠方的使用者走 AWS 骨幹網路加速,這些客戶就在 API 所在 Region 附近,用不到這個好處,卻要另外付固定費用和每 GB 的加速費,成本輸給 C。D 拿掉 ALB 就失去 L7 的路徑分流,要把這段邏輯搬進應用程式,違反「保留現有的路徑分流設定」。
instance refresh 會依照目前設定的 launch template 版本,分批終止舊機器、啟動新機器,而且每一批都要等新機器通過健康檢查才繼續。minimum healthy percentage 設為 90%,就能保證過程中至少九成容量在服務,整個過程一個指令完成,人工操作最少。
B 會讓 12 台機器同時下線,新機器要幾分鐘才能服務,違反「服務不中斷」。C 是這篇文章特別提過的誤解:改了 launch template 之後,只有「之後新開的機器」會用新版本,既有機器不會被自動替換,也沒有所謂「維護時段自動換新」的機制。D 的藍綠部署(兩組機器用 ALB 權重切換流量)技術上可行、也不會中斷服務,但要另外建一整組資源,還要手動調整權重、驗證、清掉舊的群組,人工操作遠多於一次 instance refresh。


 iThome鐵人賽
 看影片追技術