

Day 14 裡,筆者遇過候選已經提供正式求助窗口,Judge 卻說它沒有提供的情況。Day 15 則談到另一個限制:Reward Model 能替同一組候選排序,但排在前面的回答,仍可能加入沒有依據的退款時程。
走到這裡,已經知道可以用自動評估留下分數與理由。接下來的問題是:當這些判斷不足以決定合成資料能不能用,人要怎麼接手?
Human-in-the-Loop(HITL)是讓人實際參與自動化流程中的操作、覆核或決策。例如模型先產生候選,人再確認標註;系統遇到無法判斷的案例,暫停等待人工裁決;或者人抽查自動處理的結果,找出模型沒有察覺的錯誤。IBM 的概念說明也把它放在「人參與自動化系統的運作、監督或決策」這個範圍,而不是限定成某一種模型訓練 / AI 應用的方法。
而放到本文的合成資料情境,人需要能看到判斷依據,也能改變資料的處置:接受、退回修正,或保留待審。如果介面只能讓人看一眼分數、按下確認,卻不能指出錯誤或退回案件,那麼人工覆核的作用就很有限。
HITL 不一定要重新訓練模型。把人工確認的案例補進 Judge 的評分準則、修正生成條件,或建立下一次改版要重跑的測試,都可以讓人工判斷影響後續流程。Day 15 談的 RLHF 是一種使用人類回饋的訓練方式;今天談的是資料生成後的審查與校準,不需要先做一輪 RLHF 才能開始。
這裡也先限定範圍:本文處理的是「合成資料能否符合指定用途」,不是要求客服機器人的每一句回覆都等專家批准,也不是 Agent 執行動作前的人工授權。
人的工作其實在生成前就開始了。
例如要合成一組「查詢配送進度的合格客服回答」,先得有人把用途與條件說清楚:原始問題提供哪些資訊、回答必須保留什麼,以及客服有哪些承諾不能自行做。這些條件會進入 Seed、生成提示詞與評分準則(Rubric)。如果連「合格」是什麼都沒有定義,後面請人逐筆打分,也很難累積一致的資料。
候選產生後,自動評估先處理它能判斷的部分,留下結果與理由。人再接手需要裁決的案件,以及依抽樣計畫選出的資料。不是每筆都要人工批准;但需要人工決定的資料,不能在尚未審完時就混進已確認的資料集。
下面畫出人工介入與回饋的位置: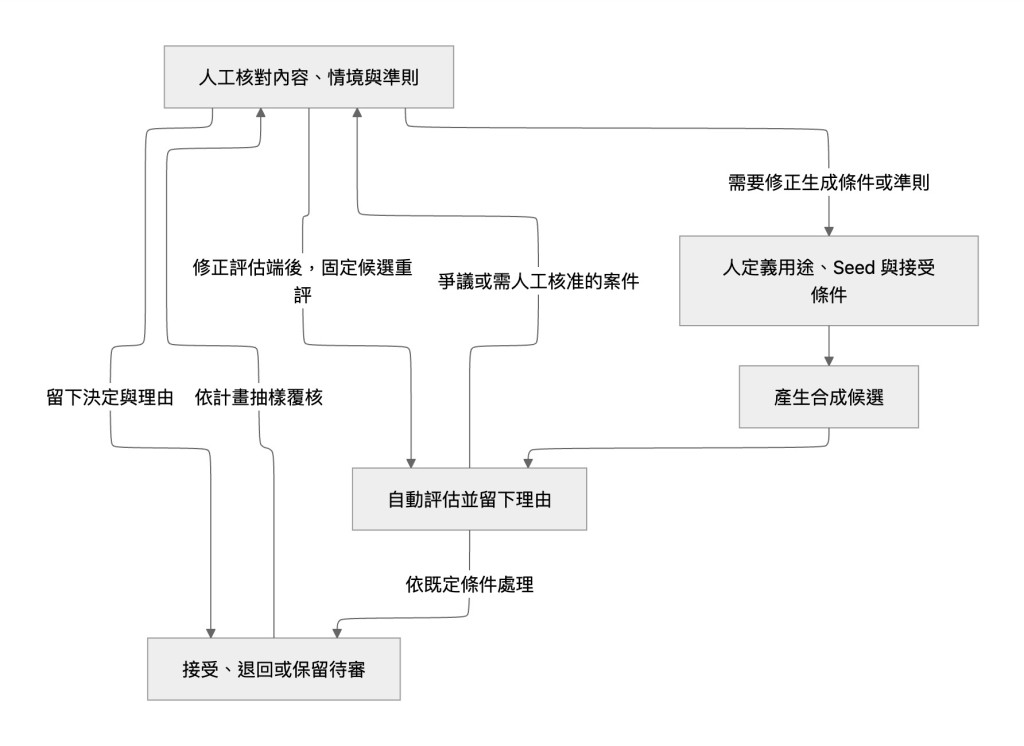
圖裡有兩種回流。候選內容有問題,就回到生成條件或失敗階段;評估器判錯,則先修正評估端,用原候選重新檢查。這延續 Day 14 的判斷:不能看到 Judge 判失敗,就一律要求 Generator 重寫。
Day 15 用三個客服候選說明 Reward Model 的偏好。其中 B 寫得完整,卻加入原始問題沒有提供的退款時程。以下沿著 B 補出一個審查示例,候選內容、排序、Judge 判定與人工處理都是假設情境,沒有在本次實際執行。
假設原始需求是「商品尚未送達,請客服查詢配送進度」。本例要產生的是合格客服回答,接受條件設定為:可以說明如何查詢與交由客服處理,但沒有退款核准資訊時,不得承諾退款結果或時程。
假設候選 B 寫成:
不用擔心,我們會在三天內完成退款,您可以放心等待。
B 可能因為語氣流暢、回覆明確而排在前面。若 Judge 已經指出「退款時程沒有依據」,資料管線就可以依既定條件退回,不必再請領域專家(Subject Matter Expert,SME)重做一次相同判斷。
比較需要人工接手的情況,是 Judge 也判定可以接受,而這筆資料透過抽樣進入人工覆核;或者 Judge 的判定與理由互相矛盾,無法支持最後的處置。
此時,審查者不能只看 B 和模型分數。還要把原始需求、Seed 提供的資訊、接受條件與 Judge 理由放在一起。比對後,才能指出:B 的退款承諾沒有來源支持,也沒有完成原本的配送查詢任務。
在這個例子中,人工覆核還要交代:這筆候選不符合哪個條件、應該退回哪個階段,以及 Judge 為什麼沒有抓到問題。若問題出在生成提示詞,就修生成端;若 Judge 把「回覆明確」當成合格,而沒有核對承諾依據,就補評分條件與對照案例。
資料用途也不能省略。若原本要合成的是「越權承諾的負樣本」,B 可能正好符合測試目的,應保留錯誤類型與預期攔阻標註。上面說要退回,限定在「合格客服回答」這個用途。人工審查要確認的是候選是否符合資料任務,不能只把所有不安全文字刪掉。
前面的例子說明了抽樣為什麼必要:模型沒有報錯,也可能需要人檢查。但有限的人力還得留給其他需要判斷的案例。依目前的規劃,可以保留四種進件來源:
這些原因可以同時存在。重點是讓審查者知道案件為什麼送來,不是替每筆資料硬選一個分類。
「分歧」還要避免一個誤會:Reward 把 B 排在前面,Judge 卻認為它違反退款條件,兩個結果可以同時成立。前者比較偏好,後者檢查合格條件,並不是在回答同一題。若退款條件與違反證據都很明確,直接依條件處理即可;有疑義的才需要裁決。
筆者會把人工工作分成「處理已知爭議」與「找出未知盲點」兩條線。只審低信心或模型吵架的資料,會讓人一直看到最難的案件,卻不知道平常自動通過的資料有沒有問題。Burr Settles 的主動學習綜述也提醒,只按不確定性或模型爭議選樣,可能偏向不具代表性的離群案例;這個提醒可以用來檢查人工選樣的取捨,但不代表本流程已經做過主動學習實驗。
抽樣比例則沒有一組可以通用的數字。資料量、錯判代價、判準成熟度與審查能力都會影響安排;單次 PoC 的人工佇列數量,也不能直接換算成正式環境的人力需求。
如果候選 B 被人工退回後,系統只記下一個「不通過」,下一輪仍可能繼續生成退款承諾,Judge 也仍可能繼續接受。這次覆核雖然處理了單筆資料,卻沒有改變重複發生的問題。
因此,人工結果應保留簡短理由、支持判斷的內容與使用的準則版本,再決定是否需要修正。對候選 B,可以有幾個具體後續動作:
生成端若反覆補出退款結果,就補清楚 Seed 與提示詞的限制,重跑受影響的階段,並重新檢查新候選。不能直接改掉 B 的文字,卻沿用舊版的評估結果。
Judge 若漏判,就把「說明可協助申請」與「承諾一定退款」整理成對照案例,修訂 Rubric 後先固定候選重評。接著用未參與修訂的保留案例檢查,避免只讓 Judge 學會這一道題。Day 14 已談過這種校準,這裡的人工覆核正是新案例的來源。


 iThome鐵人賽
 看影片追技術