
停車位不夠,僧多粥少,所以抽籤。
程式要做的事,一句話就說完了:從名單裡隨機抽出中籤的人。
技術上,這是十行程式碼的事。但這個案子真正困難的地方,跟寫程式沒什麼關係:
抽完之後,沒抽到的人會問:「這真的是隨機的嗎?」
而你必須答得出來。
我把這件事想清楚之後,發現要處理的是三件事:
一、程式真的是公平的嗎?(技術問題)
二、我怎麼證明它是公平的?(舉證問題)
三、參加的人相信嗎?(信任問題)
第一件最簡單。第三件最難,而且第三件不會因為第一件做對了就自動解決。
為了第二件和第三件,我在畫面上做了一個按鈕叫「查看抽籤程式碼」。點下去會跳出一個視窗,把抽籤用的演算法攤開來給大家看,旁邊還用比喻解釋它在做什麼,讓不寫程式的人也看得懂。
想法很單純:你不用相信我,你可以自己看。
今年八月,我回頭重看這段程式,發現兩件事。
第一件:洗牌的方法是錯的。
原本的寫法是把名單丟給排序函式,然後告訴它「每次比較都隨機決定誰前誰後」。這是很多人都寫過的一行偷懶寫法,看起來很隨機,但它的結果有統計偏差——不同位置被抽中的機率並不相等。偏差多大要看瀏覽器怎麼實作排序,但「不相等」這件事是確定的。
這一件如果單獨存在,還算是個技術瑕疵。真正糟糕的是第二件。
第二件:那個「查看抽籤程式碼」視窗展示的,不是實際在跑的那段程式。
視窗裡寫的是一套標準的洗牌演算法,實際執行的是上面那行偷懶寫法。兩邊不一樣。
也就是說,我為了讓大家相信這件事公平,做了一個展示;而那個展示本身是假的。 不是我故意的——是程式改過、展示沒跟著改,沒有任何機制會發現這件事。但對一個以「可受檢視」為賣點的系統來說,這比演算法有偏差嚴重得多:演算法錯了是做壞了,展示跟實際不符是騙人。
八月二十四號那次修改,我把兩件事一起處理:洗牌換成真正的 Fisher-Yates(從最後一個開始,逐一跟前面的隨機位置交換,每個排列出現的機率相等),展示視窗也同步改成實際執行的邏輯。
原本抽籤是「先在瀏覽器裡決定誰中籤,再把結果寫回雲端」。這在只有一個人操作的時候沒問題。
但這套系統有三個承辦人帳號可以寫入。如果兩個人幾乎同時按下抽籤,兩邊讀到的候選名單都是「還沒有人中籤」,就可能把同一個人抽中兩次,或者抽出超過名額的人數。
改法是把整件事包進一筆交易:抽的時候重新讀一次每個候選人的最新狀態,確認還沒中籤,然後把「誰中籤」和「這一輪的紀錄」一次寫進去。中間有人搶先完成,這一次就整個不算,跳出訊息要你重來。
這個洞在現場幾乎不會發生——實務上就是一個人在投影機前面按。但它會不會發生,和它能不能發生,是兩回事。
一、一輪只能抽一次。
前台抽完就鎖住,要再抽得到後台重置。沒有「結果不滿意再按一次」這個選項,因為一旦可以重抽,前面所有的公平都沒意義了。
二、結果照原始名冊的版面排。
中籤名單不是照抽出順序列,是比照原始名冊的排法,分四個區塊並排。這樣任何人拿著原始名冊,可以一欄一欄自己對。
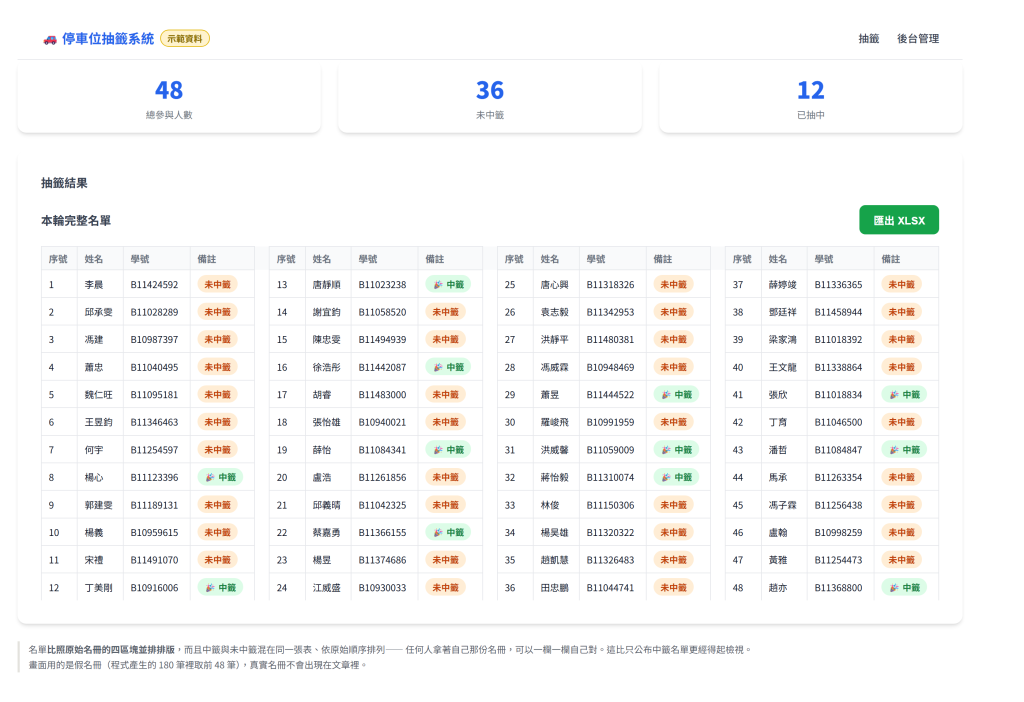
這是後來才改的。原本照抽出順序列,看起來自然,但沒辦法對照——要驗證某個人有沒有中,得從頭找到尾。
三、畫面、匯出檔、歷史紀錄三者格式要一致。
這聽起來理所當然,實際上很容易不一致——我就修過一次,歷史紀錄的匯出還停在舊格式。不一致本身就會引起懷疑,即使數字完全正確。
四、投影機看得清楚。
會議室的投影機對比度常常很差,所以加了一個淺色模式專門給投影用;提示訊息也改成置中放大,不然坐後面的人看不到現在發生什麼事。
這些都不是「功能」,是「讓在場的人跟得上」。 跟得上,就是信任的一部分。
我一開始做了「中籤名單分批揭曉」——動畫結束後,中籤者一張一張慢慢出現。
看起來很有戲劇性。後來我拿掉了。
理由是:現場的人不是來看表演的,是來知道自己有沒有中的。 分批揭曉只是延長那段焦慮,沒有任何好處。動畫結束直接顯示完整名單,大家看一眼就知道結果。
做東西給人用的時候,很容易把「我覺得酷」當成「使用者需要」。
既然整篇在講可受檢視,這兩點就該一起寫出來:
一、展示視窗裡的程式碼仍然是「複製品」。 它是我把程式碼當成文字排版排出來的,不是從正在執行的那支程式讀出來的。八月那次已經讓兩邊對上了,但沒有任何機制保證下次改程式時它會一起改——同一個坑還是可能再踩一次。
二、亂數來源是瀏覽器的一般亂數,不是密碼學等級的。 對一場抽停車位來說夠用,但如果有人要用「這個亂數可不可以被預測」來質疑,我沒有辦法反駁。
寫出來不是為了自首,是因為一套宣稱可受檢視的系統,最該被檢視的就是它自己的宣稱。
寫程式的部分它做得很好:抽籤邏輯、畫面、匯出、動畫。這些有標準做法。
驗證分布也可以交給它:跑幾萬次模擬,看每個位置中籤的次數是不是接近平均。這種事做完結果可以自己檢查,很適合交出去。
但上面那個最嚴重的問題——展示的程式碼跟實際執行的不一樣——不是它抓到的,是我回頭重看時發現的。它當初寫下那行偷懶洗牌的時候,也沒有覺得哪裡不對。
它也不會告訴你「分批揭曉會讓人更焦慮」。 那要想像一群人坐在會議室裡等結果的樣子。
Day 19:測試不能用真名冊——那些真實的姓名和學號,該怎麼處理。


 iThome鐵人賽
 看影片追技術