
做抽籤程式、做報到系統,都要測試。測試就要有資料。
而手邊最現成的資料,就是真的那份名冊。
用它最方便——格式一定對、數量一定準、狀況一定真實。所以很多人就這樣用了,包括以前的我。
問題是:測試資料會跑到很多地方去。
它會被複製到測試資料夾、會被貼進聊天視窗問問題、會出現在螢幕截圖裡、會被丟給 AI 說「幫我看看這個格式怎麼處理」。每一次都是一次外流的機會,而且你不會記得自己複製過幾份。
做法是寫一支小程式,產生一份格式一樣、內容是假的名冊。
好處立刻就出現了:
第三點是真名冊給不了的。真名冊只有一種樣子,而你需要測的是各種奇怪的狀況。
這裡有個實際的問題:假資料要多像真的?
太不像,測不出真實狀況(比如全部都叫「測試一號」,就測不出姓名太長會不會擠版)。太像,又會有人以為那是真的。
我後來的做法是格式盡量一致、內容明顯是假的:編號的組成規則照著真實格式來,姓名用組合出來的。
說「盡量」是因為我自己也沒做到位——我回頭比對才發現,我產出的假名冊編號比真名冊多了一碼。這個疏漏不算嚴重(測版面寬度反而更保險),但它說明一件事:假資料也要驗,不能產完就當它對。
有趣的是,假資料和真資料的差別,其實統計上看得出來。我實際比對過手邊這兩份:
| 特徵 | 真名冊 | 假資料 |
|---|---|---|
| 最常見姓氏佔比 | 約 10% | 約 5% |
| 兩個字的姓名 | 約 1% | 約 36% |
| 編號重複 | 有一筆 | 沒有 |
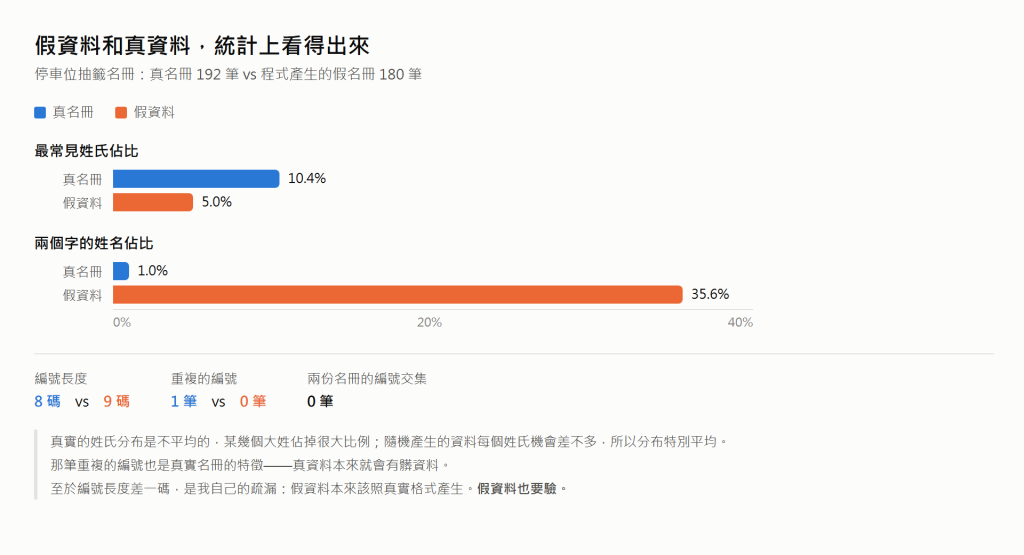
真實的姓氏分布是不平均的——某幾個大姓佔掉很大比例。而隨機產生的資料,每個姓氏被抽中的機會差不多,所以分布特別平均。
真實資料還有一個特徵:它有髒東西。 那份真名冊裡有一筆重複的編號。這種東西假資料通常不會有,因為程式會避免重複——但真實世界會。
這件事給我一個副產品:當我不確定手邊某份檔案是真是假的時候,可以用這些特徵去判斷,而不用打開來看內容。
用 AI 協助工作之後,這個習慣的價值變得更高。
因為一旦真名冊進了對話框,它就離開了你的電腦——不管那個服務多可信、條款寫得多好。這條界線 Day 27 會專門講,這裡只要記住一件事:測試階段根本不需要真名冊,所以這是最容易避開的一種外洩。
所以我的分工變成這樣:
而且不是「這次應該沒關係」的判斷,是預設不送。要送之前先問一次「這裡面有沒有可以識別到人的東西」。
如果你也在處理這類資料,我建議做兩件事:
一、產假資料的程式,跟專案放在一起。 不要每次臨時做一份。放在一起,下次要測就直接跑,不會因為懶而拿真的來用。
二、真名冊要排除在版本控制之外。
版本控制是工程師用來記錄「檔案每一次改動」的工具,它的特性是會把每個版本都留著。好處是任何東西都救得回來,壞處是——不小心放進去的東西也留著。
這第二件事,我要很具體地講我自己的狀況,因為我今天才查清楚。
我原本以為我的情況是「還沒設定排除規則」。實際查下去,真名冊早就在版控裡了。不是漏設規則,是那份檔案已經被記錄進去,從一個叫做「加上安全性強化」的改動開始。那次改動我確實做了不少安全設定——然後把真名冊一起放了進去。
更諷刺的是:假名冊和產生假資料的那支程式,兩個都沒進版控。 剛好反過來。該留下的沒留,不該留的留著。
目前它沒有外流,因為這個專案還沒有設定上傳的目的地,東西只在我自己的電腦上。但這是運氣,不是設計——哪天要跟別人協作、設定了上傳目的地,它就會跟著一起出去。
而且這種事不是刪掉檔案就沒事的:版控會把歷史留著,要真的清乾淨,得把過去的紀錄一併改寫。進去容易出來難,這就是為什麼要在它進去之前就擋。
寫這一段的時候我很想把它寫成「我有注意到這個風險」。但事實是我寫這篇稿子之前並不知道,是為了查證才發現的。系列不美化這種事——而這也正好證明前面那句:假資料也要驗,自己的做法同樣要驗。
待辦清單上劃不掉的那一項,通常不是因為難,是因為它不會催你。 這一項現在會催我了。
Day 20:進入第四段。把工作丟給另一個 AI 去跑——不是我用它,是我請它自己去做。


 iThome鐵人賽
 看影片追技術