
Day16 講完 thinking level 的機制之後,我寫下了事前預測:
成功率三組差不多,但成本和輪數會分出高下。
今天驗收。
thinking off、low、high。gpt-5.6-luna,所有條件都保留 AGENTS.md。| 任務 | 條件 | 成功 | 成本中位數 | tokens 中位數 | 工具呼叫中位數 | 耗時中位數 |
|---|---|---|---|---|---|---|
| T2 新增 endpoint | off | 5/5 | $0.0060 | 55,105 | 30 | 53s |
| T2 新增 endpoint | low | 5/5 | $0.0080 | 66,160 | 24 | 59s |
| T2 新增 endpoint | high | 5/5 | $0.0091 | 79,014 | 34 | 115s |
| T5 資料遷移 | off | 5/5 | $0.0085 | 119,698 | 33 | 60s |
| T5 資料遷移 | low | 5/5 | $0.0057 | 39,798 | 20 | 36s |
| T5 資料遷移 | high | 5/5 | $0.0094 | 94,544 | 35 | 68s |
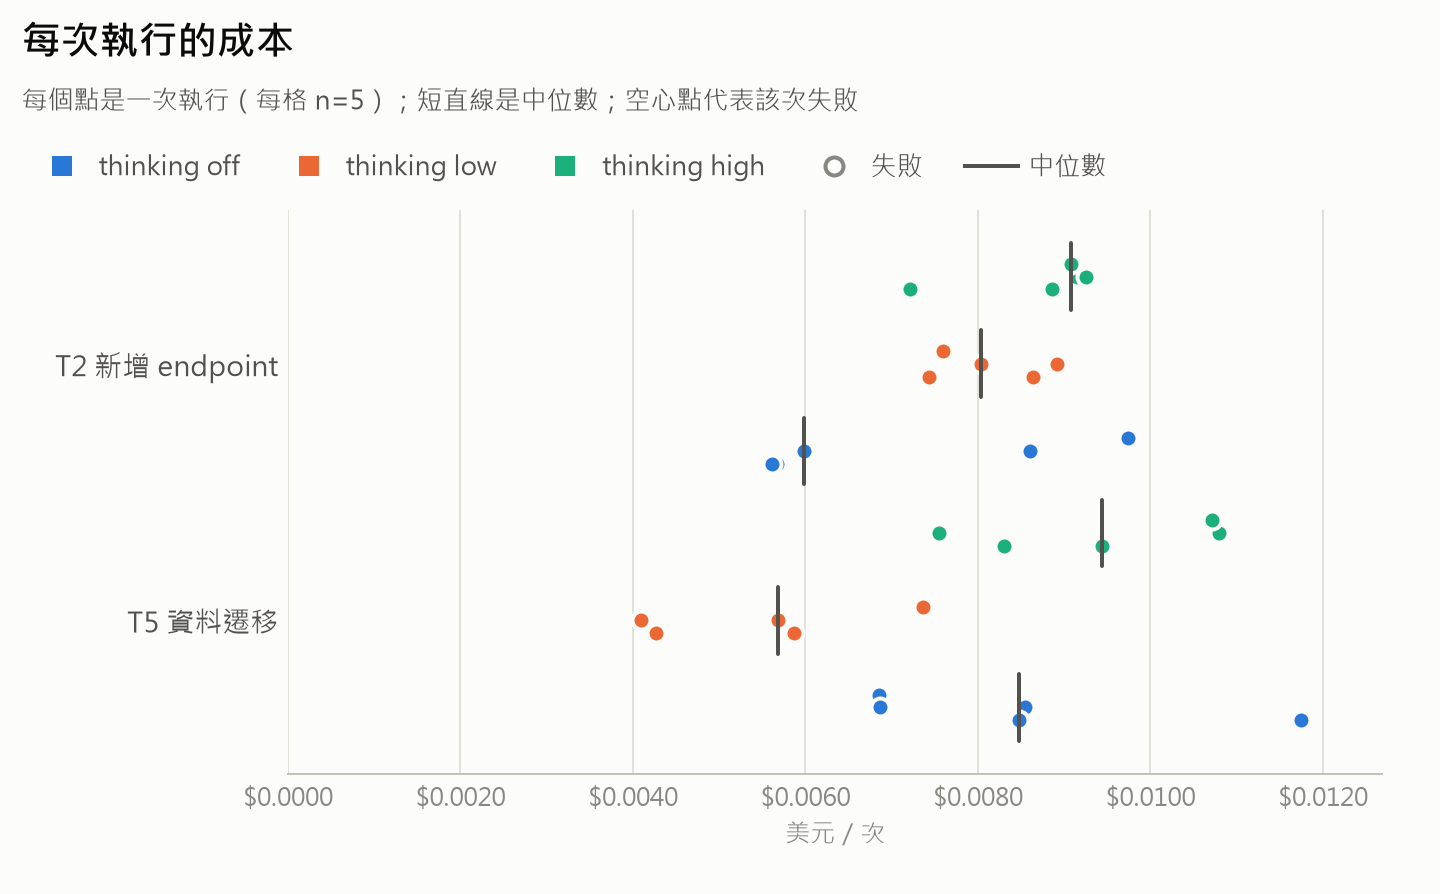
成功率 30/30,預測的前半對了。 後半也對了——成本確實分出高下,但形狀跟我想的不一樣。
我原本預期成本會隨 thinking 單調上升。T2 差不多是這樣,但 T5 不是:
low 的成本只有 off 的三分之二、high 的六成。T5 的 off 組到底發生什麼事?看 tokens 和工具呼叫就懂了:
| T5 條件 | 五次的 tokens | 五次的工具呼叫 |
|---|---|---|
| off | 57K、71K、120K、121K、134K | 23、25、33、33、43 |
| low | 34K、36K、40K、52K、92K | 15、19、20、20、24 |
| high | 81K、89K、95K、116K、158K | 32、33、35、35、39 |
關掉思考之後,它開始亂繞。 工具呼叫最多的那次用了 43 次,是 low 中位數的兩倍多。T5 要照六個步驟走(改 schema、重新產生模型、寫 migration、更新 INDEX、改 API schema、跑檢查),少想一步就得多試一輪,多試一輪就多一份 context 要重送。
反過來在 T2,規格已經白紙黑字寫在測試檔裡,「想清楚」這件事沒有太多發揮空間,多想就只是多付錢。
一句話總結:
thinking 不是「花錢買品質」的旋鈕,是「用 output token 換 input token」的旋鈕。任務需要規劃時,這筆交換划算;任務照著做就好時,它只是純成本。
n=5 的資料要小心講。把每一次的成本攤開:
| 任務 | 條件 | 五次的成本 |
|---|---|---|
| T5 | off | $0.0068、$0.0069、$0.0085、$0.0085、$0.0117 |
| T5 | low | $0.0041、$0.0043、$0.0057、$0.0059、$0.0074 |
| T5 | high | $0.0075、$0.0083、$0.0094、$0.0107、$0.0108 |
T5 的 low 和 high 完全沒有重疊——low 最貴的一次($0.0074)還比 high 最便宜的一次($0.0075)便宜。這是這批資料裡唯一可以放心說「有差」的比較。
low 對 off 只差一點點就完全分開(off 最便宜的 $0.0068 落在 low 的範圍內)。至於 T2 的三組,範圍互相重疊,中位數的高低不該當結論看。
off 不等於不思考Day16 從原始碼看到,Pi 的 off 不是送一個 reasoning_effort: "off",而是整個欄位不送。今天的資料顯示這個實作細節有後果:
| 任務 | 條件 | reasoning tokens 佔 output |
|---|---|---|
| T2 | off | 16% |
| T2 | low | 12% |
| T2 | high | 28% |
| T5 | off | 30% |
| T5 | low | 12% |
| T5 | high | 46% |
off 產生的 reasoning token 比 low 還多,在 T5 甚至多到 2.5 倍。
合理的解釋是:欄位不送,模型就用它自己的預設推理強度,而那個預設顯然比明確指定的 low 高。所以在 Pi+Codex 這個組合下,off 的語意其實是「我沒意見,你自己決定」,不是「不要想」。
這件事很值得記住,因為它會誤導直覺:想省錢而把 thinking 關掉,結果可能比明確指定 low 還貴——T5 就是這樣。
依這組資料(單一模型、兩個任務、n=5):
off 當成省錢手段。 它只是把決定權交回模型。要省,明確指定 low。low 可能比 off 便宜。 少繞路省下來的 input token,比多想那幾百個 output token 值錢。high 多花 50% 成本、兩倍時間,成功率一樣。medium 沒有被這次實驗涵蓋,但校準那一輪都是 medium(不同批次、n=3,只能當參考):T2 的成本中位數 $0.0078,落在 off 和 high 之間;T5 是 $0.0067,比 off 和 high 都便宜、接近 low——跟「流程任務中間檔位最省」的趨勢一致。第一輪實驗到這裡告一段落。Day18 開始換裝備:土法煉鋼的 runner 已經量不出更細的東西了,接下來要為 Pi 接上真正的 trace,看清楚每一輪裡面的時間和 token 花在哪一個環節。


 iThome鐵人賽
 看影片追技術