
Day 18 把不同模型放在同一套規則下比較。今天換成另一件事:把一般計算與量子電路串成一條模型,檢查誤差能不能正確傳回每一段,讓三組參數一起更新。
想像一條生產線:前端機器把原料轉成「旋鈕角度」,中間量子電路依角度跑完吐出一個分數,後端再把分數壓成 0~1。調校時不能只轉中間的旋鈕——前端若不知道「角度該怎麼改才讓損失下降」,整條線就學不起來。混合神經網路要的,正是這條從頭到尾都通的梯度路徑。
完整程式:hybrid.py、experiment.py、demo.py。鏈式法則手寫,沿用 NumPy/CUDA-Q,不新增 PyTorch。重點是梯度穿過整個模型,不是再做分類排行榜。
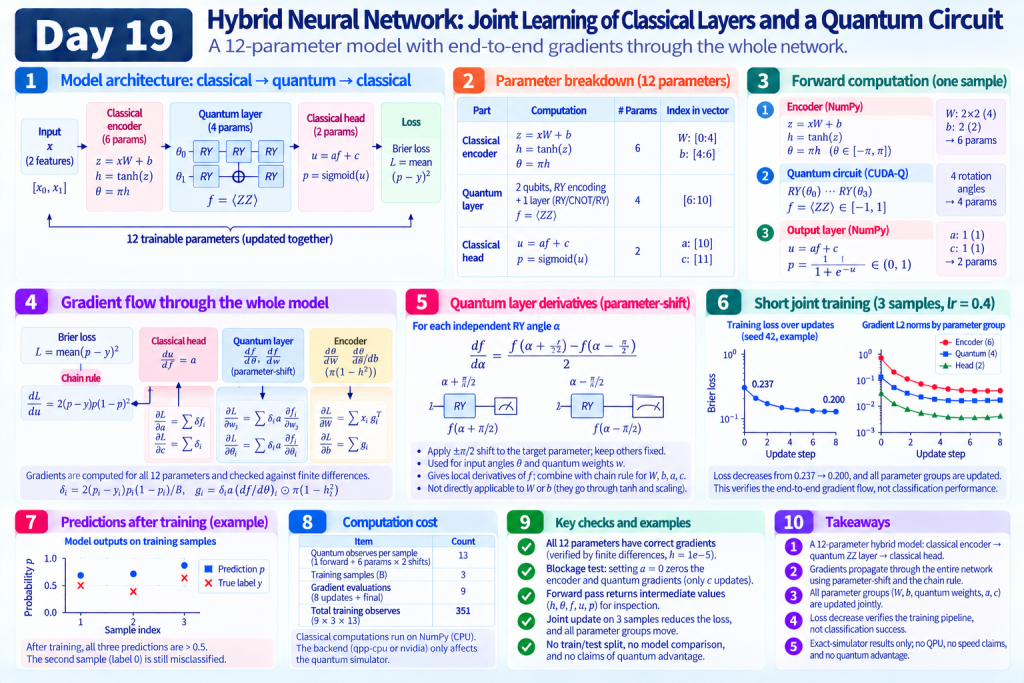
Day19 builds a twelve-parameter hybrid model: classical encoder → quantum ZZ layer → classical head. Parameter-shift supplies local quantum derivatives; the full chain rule is checked against finite differences. A short joint update on three samples verifies all parameter groups move, without claiming classification success, QPU results, or quantum advantage.
| 部分 | 做什麼 | 參數個數 | 在向量裡的位置 |
|---|---|---|---|
| 一般編碼層 | z=xW+b → h=tanh(z) → θ=πh |
6 | W=[0:4]、b=[4:6] |
| 量子層 | 兩位元 RY 編碼+可調模板 → f=⟨ZZ⟩ |
4 | [6:10] |
| 一般輸出層 | u=af+c → p=sigmoid(u) |
2 | a=[10]、c=[11] |
flowchart LR
    X[兩個輸入特徵] --> E[編碼層:乘 W,加 b]
    E --> T[tanh,再乘 π]
    T --> Q[兩量子位元電路]
    Q --> F[ZZ 期望值 f]
    F --> H[輸出層:a f+c]
    H --> P[sigmoid 分數]
    P --> L[Brier 損失]
白話:仿射轉換=乘權重再加偏差;tanh 壓到 (−1,1);sigmoid 壓到 (0,1)。ZZ 仍是兩位元相同 +1、不同 −1 的平均。
量子核心重用 Day 9 一層模型,但不走其 features→πx 外層——因為編碼層已經直接產出弧度。前後一般計算都在 NumPy CPU;--backend nvidia 只切換量子模擬器。
Day 14/15 的角度由固定縮放規則決定。今天 W、b 也會被更新,角度會隨訓練變:
hidden = np.tanh(x @ parameters[:4].reshape(2, 2) + parameters[4:6])
angles = np.pi * hidden
tanh 把輸出限在 [−1,1],再映到 [−π,π]。接近上下限時曲線變平(飽和),導數可能很小——不是「最佳角度範圍」的結論,也不保證所有特徵都保持可區分。
示範特徵已是小尺度二維數值;API 接受有限的 B×2 矩陣,模型內沒有隱藏縮放器。真實資料仍需獨立的「只看訓練集」前處理,並與檢查點一起保存。
若只算「量子權重怎麼動」,編碼層就得不到正確方向。量子層雅可比要包含:
[df/dθ0, df/dθ1, df/dw0, df/dw1, df/dw2, df/dw3]
六個角度各自控制一個獨立 RY,可用 Day 17 的兩點參數位移:
df/dα = [f(α+π/2) − f(α−π/2)] / 2
動 θ 時固定量子權重;動權重時固定 θ。這是量子層的局部偏導數,之後再乘鏈式法則。不能對 W 直接加 π/2 套同一公式——W 還要經過仿射、tanh、乘 π 才進電路。
Brier:L=mean((p−y)²)。先定義每筆對輸出層原始分數的導數:
δ_i = 2(p_i−y_i) p_i(1−p_i) / B
然後:
dL/da = Σ_i δ_i f_i
dL/dc = Σ_i δ_i
dL/dw_j = Σ_i δ_i a (df_i/dw_j)
g_i = δ_i a (df_i/dθ) ⊙ π(1−h_i²)
dL/dW = Σ_i outer(x_i, g_i)
dL/db = Σ_i g_i
⊙=對應元素相乘;outer=外積,方向與 x @ W 一致。十二個參數每個都與「完整模型損失的中央差分」(h=1e-5)核對。
這是手寫鏈式法則,尚未接 PyTorch 自動微分。若之後包成自訂自動微分函式,仍須維持相同的輸入/權重雅可比與批次平均規則。
公式裡若 a=0,編碼層與量子權重的梯度全變 0——即使偏差 c 的梯度還在。測試會故意設 a=0 驗證這個阻斷。
正式示範:種子 42 的 normal(0,0.2) 初始化 12 個參數,再把 a 設成 0.8,好讓三組都能動。這不是搜尋過的最佳初始化。sigmoid/tanh 飽和也會削弱梯度;小梯度不全等於貧瘠高原。
本日的 p 是 sigmoid(af+c),不再是 Day 15 的直接同位性機率 (1−ZZ)/2。它是一般輸出層分數,沒有機率校準宣稱。
features = [[−0.6,0.4], [0.3,0.5], [0.7,−0.2]]
labels   = [1, 0, 1]
學習率 0.4,做八次 parameters -= 0.4 * gradient。CPU/GPU 損失都約從 0.237 → 0.200,三組參數都有改變。但最終三筆 p 都大於 0.5——標籤為 0 的那筆仍會分錯。
損失下降只驗證更新流程通了,不代表分類任務已解決。 本日沒有 train/test 切分、選模或準確率比較,也不與 Day 18 排名混用。
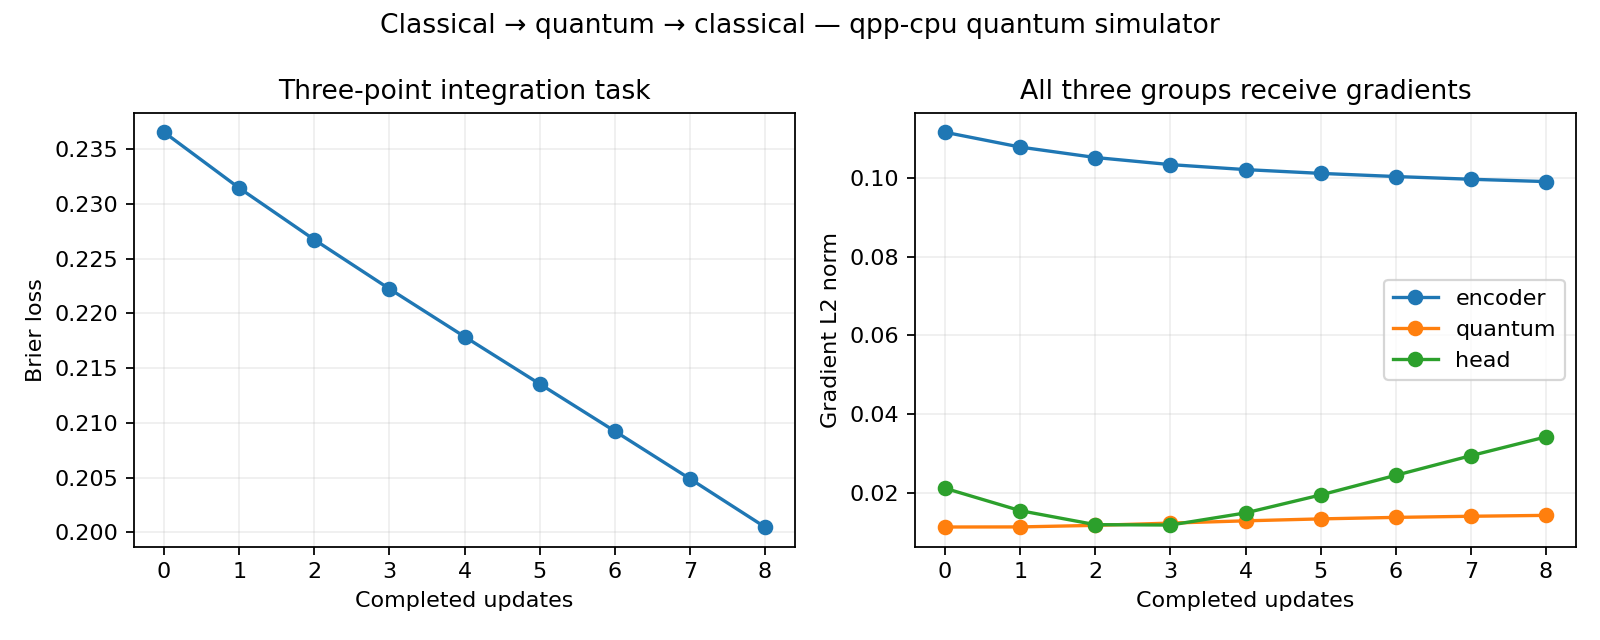
右圖用梯度的 L2 長度看各參數群組「動了多少」;群組個數與單位不同,不能直接解讀成「哪一層比較重要」。
每筆資料:1 次原始前向+6 個局部導數各 2 次位移=13 次量子 observe。B=3、九次梯度評估:
9 × 3 × 13 = 351 次訓練 observe
最終參考核對與重新載入另計。全部為無雜訊精算期望值,沒有有限 shots 訓練。
forward 會回傳機率與暫存:隱藏輸出、角度、量子期望值、原始分數。這些是主控端留下的一般數字,不是從 QPU 直接讀出全部振幅。
沿用 .venv;固定依賴見 requirements-day19.txt。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day19/experiment.py
OMP_NUM_THREADS=1 python articles/day19/experiment.py --backend nvidia
OMP_NUM_THREADS=1 python articles/day19/plot_results.py
OMP_NUM_THREADS=1 python articles/day19/plot_results.py --backend nvidia

# 讀取保存參數,印出各層中間值
OMP_NUM_THREADS=1 python articles/day19/demo.py --features -0.6 0.4
輸出:history.json、summary.json、checkpoint.json、hybrid_training.png。檢查點含架構、參數分段、輸入契約、種子與 12 個參數;實驗會重新載入驗證輸出一致。示範只服務此固定架構,不是跨模型通用載入器。可用 --output-dir /tmp/day19-check 另存。
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day19 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY19_TARGET=nvidia python -m unittest discover -s articles/day19 -p 'test_*.py' -v
五個測試涵蓋:前向參考/輸入不變性、12 參數鏈式法則、量子輸入與權重雅可比、a=0 梯度阻斷、錯誤輸入。數字見 結果紀錄。
本日核對「經典–量子–經典」混合計算圖:量子層同時回傳對輸入與權重的導數,完整損失以有限差分獨立核對;a=0 反例顯示初始化可切斷上游梯度。這是端到端梯度整合測試,不是分類成效評估,也不與 Day 18 排名混用。
[D15] NVIDIA Hybrid QNN 教學(0.8.0) 示範一般層與量子層整合。2026-09-07 重新查閱;本日未移植其歷史梯度程式,而是沿用 Day 17 位移規則並獨立核對完整鏈式法則。索引:REFERENCES.md。
下一篇 Day 20 將把一般/量子/混合模型放到 Iris 鳶尾花資料上比較。本日不作 QPU、速度或量子優勢宣稱。
[N5] Brian Coyle et al. “Training-efficient density quantum machine learning.” npj Quantum Information 11, 172 (2025);研究論文。原始來源;完整書目。
本章檢查混合模型各層導數;該研究可延伸思考結構與梯度計算量的關係。本章仍以獨立數值方法核對既有模型。


 iThome鐵人賽
 看影片追技術