
Day 9 到 Day 17,量測台跑了 100 多次執行,回答了五個問題:AGENTS.md 值多少、Skills 值多少、搜尋工具值多少、規則放哪裡有沒有差、thinking 調高調低差多少。
這些答案都建立在同一批數字上:成功率、成本、tokens、工具呼叫次數、耗時。全部從 session 記錄算出來。
但 Day 17 有一個數字我一直沒辦法解釋:thinking high 的 T2 任務耗時 115 秒,是 off 那組 53 秒的兩倍多。那多出來的 62 秒,到底花在哪裡?
今天就來回答這個問題——順便說明為什麼土炮的量測方式到這裡就到頂了。
session 記錄裡每一則訊息都有時間戳。assistant 訊息的時間戳減掉前一則訊息的時間戳,大致就是「等模型回應」的時間;toolResult 減掉 assistant,大致就是「跑工具」的時間。
拿一次 T5 資料遷移(thinking high)的執行來算:
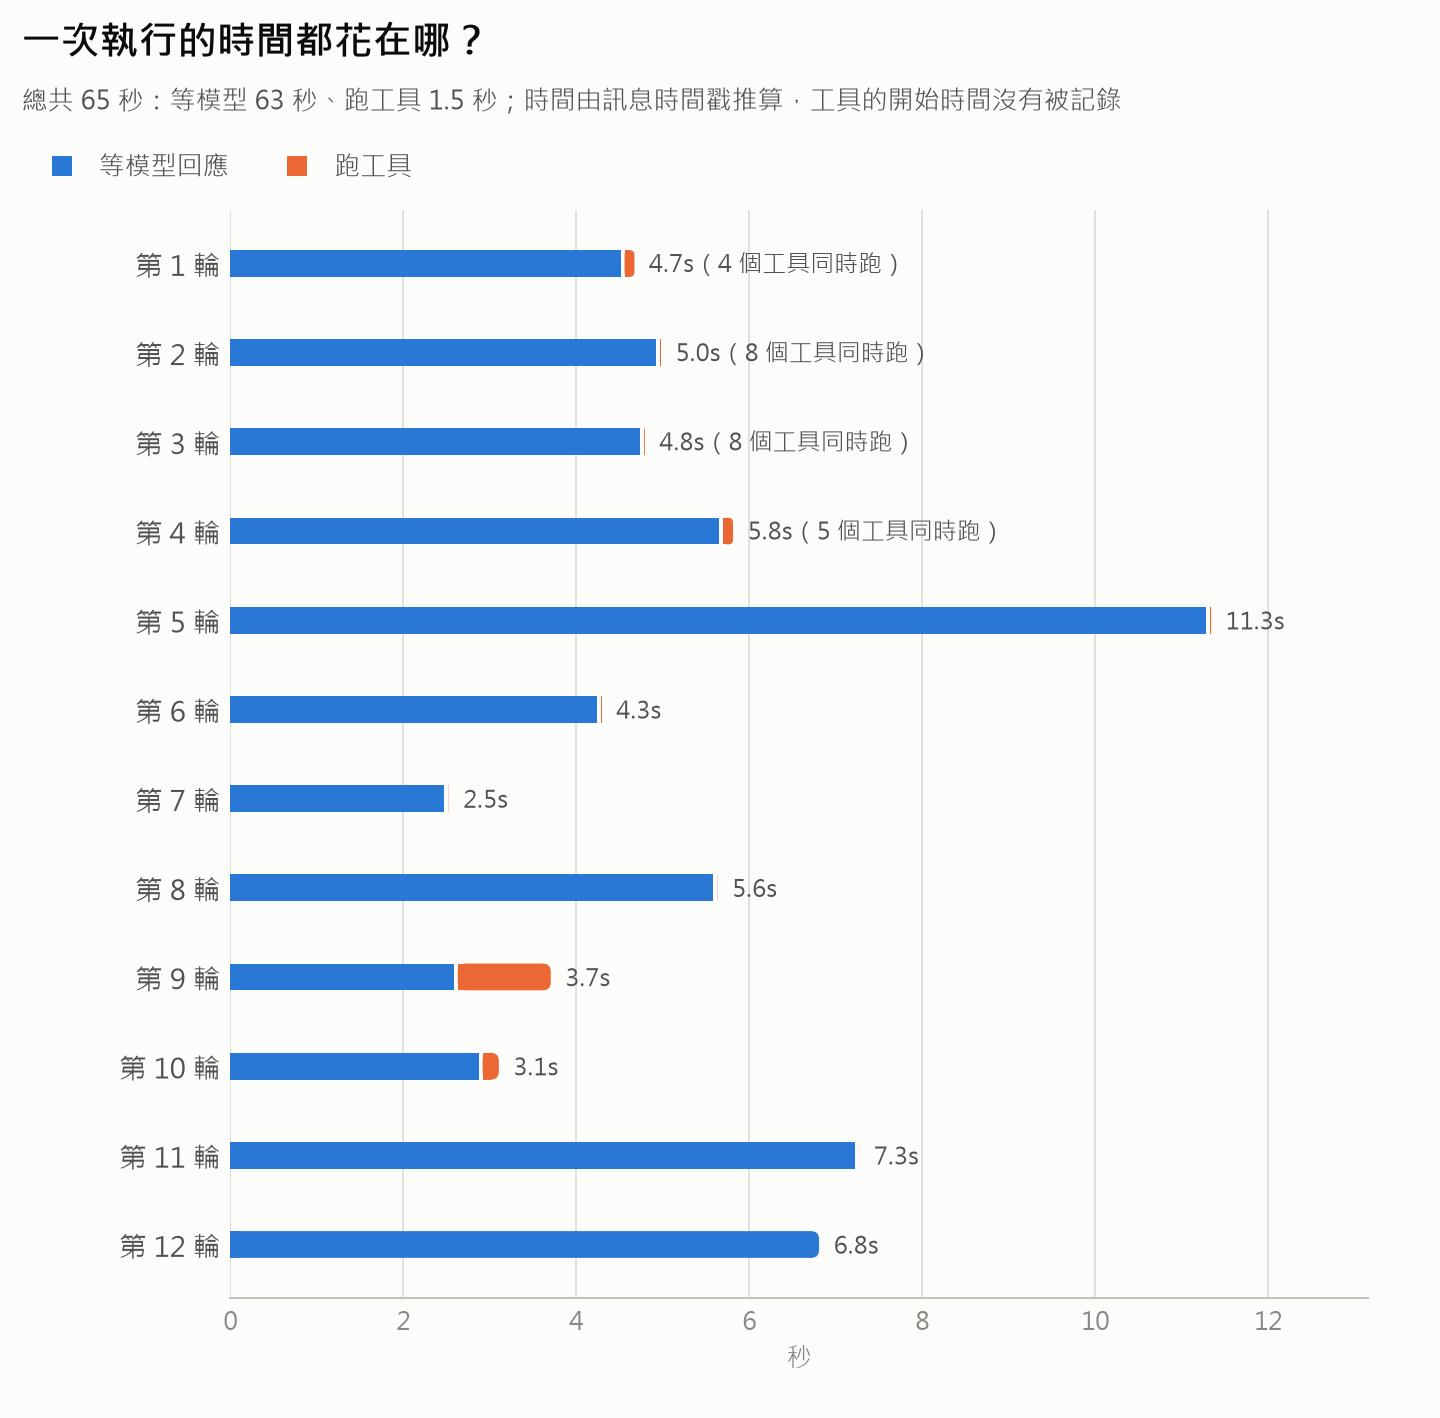
結果非常一面倒:
| 項目 | 時間 | 佔比 |
|---|---|---|
| 等模型回應 | 63.4 秒 | 97.5% |
| 跑工具 | 1.5 秒 | 2.3% |
這個 agent 幾乎整個生命都在等模型講話。 32 次工具呼叫——讀檔、跑 pytest、跑 check.py——全部加起來只有一秒半。
這個發現本身就值得記住:優化 coding agent 的執行速度,跟你的工具寫得多快幾乎無關。 唯一有意義的槓桿是「少跑幾輪」和「每輪少送一點 context」,這正好呼應 Day 14 的成本結構(六成的錢花在輸入)。
上面那張圖看起來很有用,但它其實是猜的。四個問題它答不了:
一、那 63 秒裡面發生了什麼?
第 5 輪等了 11.3 秒,是第 7 輪的 4.5 倍。為什麼?是 prompt 太長、模型想比較久、串流中途卡住、還是排隊等資源?記錄裡只有一個時間戳,沒有「送出請求」「收到第一個 chunk」「收到最後一個 chunk」的分界。
二、平行呼叫的工具,各自花多久?
圖上有四輪標了「N 個工具同時跑」,其中一輪同時呼叫 8 個。這 8 個工具的耗時被壓成一個數字,分不開。如果其中一個特別慢,我看不出來。
三、工具的開始時間根本沒有被記錄。
我是拿「上一則訊息的時間戳」當工具的起點——但那其實是模型輸出結束的時間。模型輸出到工具開始執行之間的空檔(參數解析、權限檢查、排程)全被算進「跑工具」。所以那 1.5 秒是高估的。
四、session 之外的時間完全看不到。
runner 量到這次執行 68.4 秒,session 記錄推算出來是 65.0 秒。中間有 3.4 秒不知去向——Pi 啟動、載入設定與 extension、寫檔收尾。佔了 5%,而且完全在記錄之外。
你可能會想:那就在 session 記錄裡多寫幾個時間戳?
問題是要加的不是欄位,是結構。我要回答的問題長這樣:
一次 turn
├─ 一次模型請求
│  ├─ 送出請求(多大?)
│  ├─ 等第一個 chunk(多久?)
│  └─ 串流完成(中途重試過嗎?)
└─ 8 個工具
   ├─ read a.py     ← 各自多久?
   ├─ read b.py
   └─ ...
這就是 span:每個操作有開始時間、結束時間、父子關係、以及自己的屬性。一堆平鋪的時間戳拼不出這棵樹;就算拼得出來,每加一種新操作就要改一次解析程式。
這正是 trace 這個東西存在的理由。它不是「更花俏的 log」,它是為了回答「時間花在哪一層」而設計的資料結構。
我原本以為要自己在 Pi 外面量。翻原始碼才發現,Pi 已經把 span 寫好了——而且是一套設計得很乾淨的體系:
pi.harness.run             一次執行
├─ pi.harness.turn         一輪(一則回應 + 它那批工具)
│  ├─ pi.harness.step      一次「可重試的嘗試」
│  │  ├─ pi.ai.request     模型請求(provider、model、usage、time_to_first_chunk_ms)
│  │  └─ pi.harness.sleep  重試前的等待
│  └─ pi.harness.tool      每一個工具呼叫,各自一條
└─ pi.harness.checkpoint
上面那四個答不出來的問題,這套 span 全部都能回答。
但是——這就是明天的主題——Pi 的 CLI 和高階 SDK 都沒有把這個開關接出來。pi -p 跑一百次,一個 span 都拿不到。要拿到它,得自己動手。
Day19 拆這套 span 契約:Pi 用什麼結構描述自己的執行、每個 span 帶哪些屬性,以及為什麼它刻意不綁定任何一家 telemetry 廠商。Day20 再動手把它接到 OpenTelemetry,讓上面那四個問題真的有答案。


 iThome鐵人賽
 看影片追技術