
debug exporter 換成真正送資料進去的 exporteropentelemetry 全域插件,讓閘道本身也成為 Trace 裡的一段 SpanAPISIX → OTel Collector → Tempo 的鏈路真的通了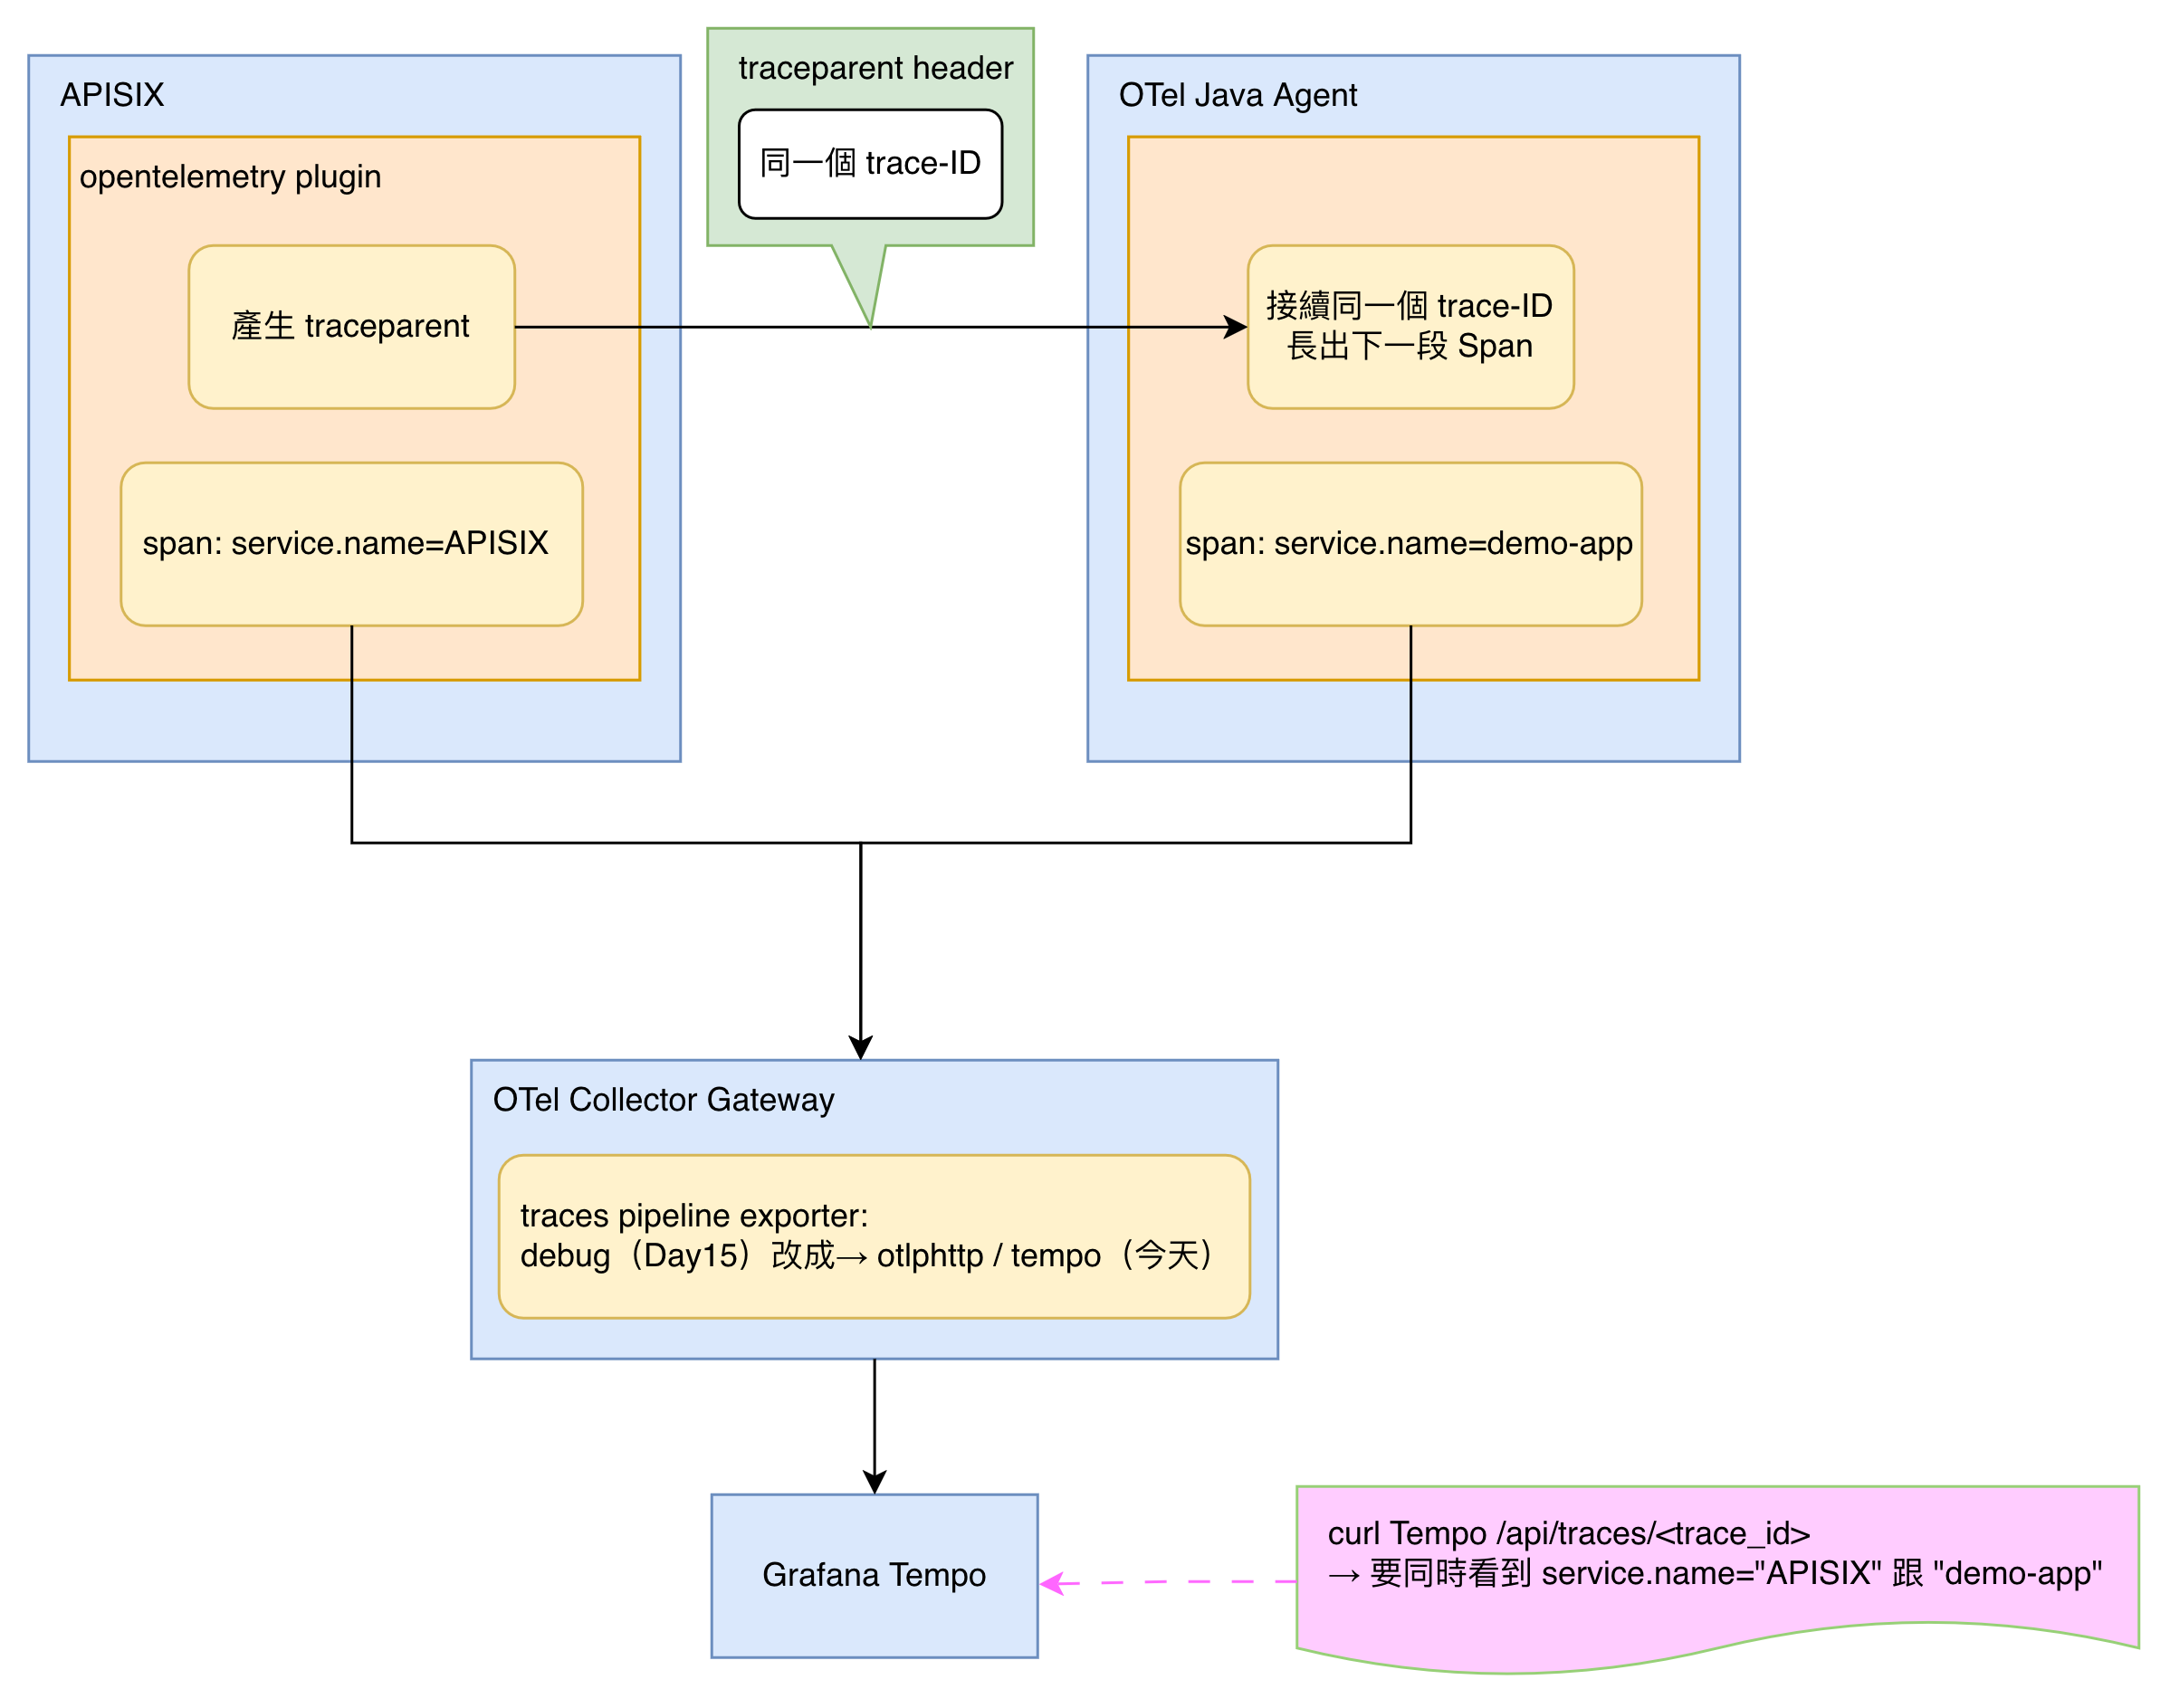
APISIX → demo-app 的 Trace,才能看出一筆請求的時間到底花在哪一段。Day07 我們已經驗證過 traceparent:demo-app 的 OTel Java Agent 會自動攔截、解析這個 header,把 trace_id 寫進日誌。trace_id、span_id、彼此的父子關係,可以組成一條 Trace 記錄。trace_id 不是一個獨立的 header,它是 traceparent 這個 header 值裡的一段。Day06、Day15 都提過這個格式。
目前每一筆 Trace 的起點都是 demo-app,我們要把起點往前面延伸,從 APISIX 開始。
我們要啟用 APISIX 原生的 opentelemetry 插件。它會先嘗試從 request 抽取既有的 traceparent。抽到 的話,APISIX 自己的處理就接成這個既有 Trace 底下的一段子 Span,沿用同一個 trace-ID;抽不到(真實流量的常態),才會自己產生一組全新、符合 W3C 標準的 traceparent。不管是沿用還是新產生,轉發給 demo-app 時都帶著這個 header。demo-app 的 OTel Java Agent 收到後,會接續同一個 Trace-ID,長出下一段 Span。兩段 Span 用同一個 trace-ID 串起來,在 Tempo 裡就能看成一條完整的瀑布圖:閘道處理花了多久、業務邏輯花了多久,一眼看得出來。從今天起,每一筆流量的 Trace 都保證涵蓋 APISIX 這一段,不再只靠 Client 端主不主動配合。
到目前為止,trace_id/span_id 只有 demo-app 自己的 OTel Java Agent 在產生(Day07 已經驗證過),而且只寫進 demo-app 自己的 log 裡。等一下我們會讓 APISIX 也開始產生自己的 Span(見下面「啟用 APISIX 的 opentelemetry 插件」),這樣就會有兩邊各自的 Span 需要合併回同一條 Trace——但不管哪一邊,都只是「一行一行看得到」的日誌,沒有一個地方能把同一個 Trace-ID 底下、橫跨兩個服務的所有 Span 收集起來,重建成一張完整的時間軸瀑布圖。Tempo 就是專門做這件事的:一個分散式追蹤(Trace)儲存與查詢後端,接收 OTLP 格式的 Span 資料,用 trace_id 當唯一的索引鍵,讓我們可以拿一組 trace_id,查回整條 Trace 完整的內容。
真實設定放在 config repo 的 manifests/infra/observability/<對應目前進度的快照路徑>/tempo.yaml:
# tempo.yaml(Deployment 片段)
containers:
  - name: tempo
    image: grafana/tempo:2.10.7
    args:
      - "-config.file=/etc/tempo/tempo.yaml"
    ports:
      - name: http
        containerPort: 3200
      - name: otlp-grpc
        containerPort: 4317
      - name: otlp-http
        containerPort: 4318
Tempo 版本鎖定在 2.10.7,沒有用 latest——Tempo 3.0 把 ingester/compactor 這兩個設定區塊整個換成 Kafka-based 架構。這個專案是單體部署,用不到 Kafka 架構帶來的好處,鎖定在最新的 2.x 穩定版比較務實。
Tempo 自己的設定檔(同一份 ConfigMap 裡的 tempo.yaml):
distributor:
  receivers:
    otlp:
      protocols:
        grpc:
          endpoint: 0.0.0.0:4317
        http:
          endpoint: 0.0.0.0:4318

storage:
  trace:
    backend: local
    local:
      path: /tmp/tempo/blocks
receivers.otlp 開放 gRPC(4317)跟 HTTP(4318)兩種協定接收資料;storage.trace.backend: local 表示 Trace 資料直接壓成 block 寫進本地磁碟——正式環境通常會把 backend 換成 S3 這類物件儲存,這個專案先用 local 就夠。
本專案的監控數據一律都先發往 OTel Collector Gateway,由它統一轉發。所以 Tempo 也是從 OTel Collector Gateway 獲得 trace 數據。
Day15 建好 pipeline 骨架的時候,Trace 資料先送去 debug exporter(只是印到 Pod 自己的 stdout),因為那時候 Tempo 還沒部署。今天把它換成真正的 exporter:
# otel-gateway.yaml(ConfigMap 摘錄)
exporters:
  otlphttp/tempo:
    endpoint: "http://tempo.<namespace>.svc.cluster.local:4318"
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlphttp/tempo]
otlphttp/tempo 這個 exporter 名稱,/tempo 只是自訂的識別字尾,用來跟其他 otlphttp exporter 區分。真正決定資料送去哪裡的是 endpoint,指向 Tempo Service 的 4318(HTTP)埠。
上面這個 exporter 改動,只是把 otel-gateway-config 這個 ConfigMap 的內容換掉。但光改 ConfigMap 還不夠——正在跑的 Pod 不會自動套用新內容,OTel Collector 也沒有像 OPA --watch 那樣主動監看檔案的能力,只有在啟動時讀一次設定。沒有這個能力的程式,通常得靠重啟 Pod,讓它重新啟動時讀到新的設定才算生效。
解法是 stakater/Reloader:一個要另外部署的社群 controller,它不是 K8s 原生功能。它持續盯著指定的 ConfigMap,內容一有變動,就自動幫掛了對應 annotation 的 Deployment 觸發滾動重啟。
用法是在 Deployment 自己的 metadata.annotations 指名要監看哪個 ConfigMap:
# otel-gateway.yaml(Deployment 摘錄)
metadata:
  name: otel-gateway
  annotations:
    configmap.reloader.stakater.com/reload: "otel-gateway-config"
Tempo 也加上對應的 annotation:
# tempo.yaml(Deployment 摘錄)
metadata:
  name: tempo
  annotations:
    configmap.reloader.stakater.com/reload: "tempo-config"
APISIX 在處理 HTTP request 的工具是 Nginx。Nginx 處理一筆 HTTP 請求,會經過一連串固定、有先後順序的處理階段,這些階段就叫 phase。
常見的幾個 phase,按執行順序大致是:
rewrite:處理 URL 改寫(例如把 /old-path 轉成 /new-path)access:處理權限檢查(要不要放行這筆請求)content:產生實際回應內容,例如反向代理到後端header_filter:回應的 Header 送出去之前,可以在這裡修改body_filter:回應的 Body 送出去之前,可以在這裡修改log:請求處理完、要記錄日誌的時候每一筆請求都會依照這個固定順序,依序走過這些 phase。
APISIX 會把部分 phase 的執行過程,內部記錄成 span 資料。opentelemetry plugin 會把 APISIX 已經記錄好的這些 span 資料讀出來,轉換、匯出成 OTel Span 格式。
另外 2 個 plugin,opa 跟 traffic-split 都在 access 這個 phase 裡執行,兩者的處理時間會被打包進同一個 apisix.phase.access Span 裡。
跟 Day17 的 prometheus 插件一樣,我們用 ApisixGlobalRule 讓所有經過 APISIX 的流量都套用同一組設定,不需要每條 ApisixRoute 各自宣告:
# apisix-otel-global-rule.yaml
apiVersion: apisix.apache.org/v2
kind: ApisixGlobalRule
metadata:
  name: global-opentelemetry
  namespace: <namespace>
spec:
  ingressClassName: apisix
  plugins:
    - name: opentelemetry
      enable: true
      config:
        sampler:
          name: always_on
上面的 YAML 裡,sampler 設定的是取樣策略——always_on 代表每一筆請求都取樣、都送出 Trace 資料。
插件還需要知道 Trace 資料要送去哪裡,也就是 OTel Collector Gateway 的位址:otel-collector.<namespace>.svc.cluster.local:4318。這個設定要透過 GatewayProxy 這個 CRD 宣告,我們在 Day04 有介紹過它:
# manifests/infrastructure/apisix/values.yaml(Helm values 摘錄)
ingress-controller:
  gatewayProxy:
    createDefault: true
    pluginMetadata:
      opentelemetry:
        trace_id_source: "x-request-id"
        resource:
          service.name: "APISIX"
        collector:
          address: "otel-collector.<namespace>.svc.cluster.local:4318"
          request_timeout: 3
collector.address 就是指定 Trace 資料要送去哪裡resource.service.name 設成 "APISIX",這樣 APISIX 產生的 Span 才會在 Tempo 裡標成獨立的 service.name,跟 demo-app 的 Span 分得清楚。我們要驗證的是:送一筆請求出去,最後在 Tempo,透過 trace_id 查到的那條 Trace 裡,要同時看得到 APISIX 跟 demo-app 兩段紀錄——代表 Trace 真的從 APISIX 一路接到 demo-app,不是兩邊各自送資料、互不相關。
驗證策略分兩步,而且順序不能反過來:
trace_id:送測試請求,從 demo-app 自己的日誌裡讀出這筆請求的 trace_id。trace_id 去問 Tempo:Tempo 是專門用 trace_id 查詢的工具。它放棄了對 Span 內容本身的 Indexing,換到 極低的儲存成本,代價是沒辦法用「搜尋」的方式找 Trace,只能直接用 trace_id 當查詢路徑,像用主鍵查一筆資料。所以我們得先有一組 trace_id 在手上(第 1 步),才查得到東西。# 連送 5 次測試請求
for i in 1 2 3 4 5; do
curl -s -o /dev/null -H "Host: demo-app.example.com" "http://<APISIX 對外 IP>/api/hello"
done
# 從 demo-app 的 log 裡擷取 trace_id
kubectl logs -n <namespace> -l track=stable --tail=10 \
| grep "Processing hello request" \
| grep -oE 'trace_id=[0-9a-f]{32}'
連送 5 次 HTTP request,只要 5 筆裡有任何一筆完整就能抓到 trace_id。
# 建立一個 k8s tunnel,會用掉一個 terminal 視窗
kubectl port-forward -n <namespace> svc/tempo 13200:3200

# 開另一個 terminal 視窗
curl -s "http://localhost:13200/api/traces/<擷取到的 trace_id>" \
  | grep -o '"stringValue":"APISIX"\|"stringValue":"demo-app"'
要同時看到 APISIX 跟 demo-app 兩個 service.name,才代表這條 Trace 真的橫跨了閘道與應用層兩段 Span。
service.version 屬性理論上能拿來在 Tempo UI 上視覺化比對 Stable/Canary 兩個版本的效能差異,但今天沒有做,要等 Day21 才會真的動手比較。plugin_metadata 與插件實例 config 分屬不同 schema 的欄位範圍。GatewayProxy CRD 的 spec.pluginMetadata 欄位定義。spec.ingressClassName 的官方定義,Day17 已經引用過同一份文件。/api/traces/<traceID> 與 /api/search 兩個端點的官方定義。traceparent 的格式定義,Day07 已經引用過同一份規格。


 iThome鐵人賽
 看影片追技術