
上一篇我們介紹了 Epoch 與 Early Stopping,也知道模型不一定要訓練越久越好,不過在前面的模型訓練程式中,除了 epochs 之外,還有一個參數我們每次都直接設定成 batch_size=32
但為什麼是 32?可以改成 16 嗎?還是設成 64 會更好?
今天就來認識 Batch Size,並實際使用 16、32、64 訓練同一個 CNN,看看不同設定會帶來什麼差異
假設現在 Training Data 有 1000 張圖片,模型在訓練時,並不是一定要一次把 1000 張圖片全部丟進去才更新參數,而是可以把資料分成一小批一小批來處理
例如我們的 Training Data有 1000 張圖片,而我們的 Batch Size 設定為 100
第 1 Batch → 100 張
第 2 Batch → 100 張
第 3 Batch → 100 張
...
第 10 Batch → 100 張
模型每處理完一個 Batch,就會根據這一批資料計算 Loss,並更新一次 Weight 和 Bias
所以 Batch Size 就是模型每次更新參數前,會一起處理多少筆 Training Data
例如我們有 Training Data 3200 張而 Batch Size = 32,那麼一個 Epoch 大約會有 3200 ÷ 32 = 100 Batch,也就是模型完整看完一次 Training Data 的過程中,大約會更新參數 100 次
如果改成 Batch Size = 64,則 3200 ÷ 64 = 50 Batch,每個 Epoch 更新參數的次數也會跟著改變
如果 Batch Size 比較小,例如 batch_size=16
代表模型每次只使用 16 張圖片計算 Loss,再進行一次參數更新
因為每一批資料比較少,不同 Batch 之間的內容差異可能比較明顯,因此梯度更新通常也會有比較大的波動
但它的好處是一次處理的圖片比較少,通常需要較少的記憶體,所以當 GPU 記憶體有限時,降低 Batch Size 是常見的做法之一
假設改成 batch_size=64,每次會使用更多圖片一起計算 Loss,因為一次參考的資料比較多,估計出來的梯度通常會比較穩定。
但同時一次需要處理更多圖片,就需要儲存更多中間運算結果,因此通常需要更多記憶體,所以 Batch Size 也不是越大越好
而且 Batch Size 改變後,每個 Epoch 的參數更新次數也會跟著改變,因此最後的模型表現不一定會完全相同
其實沒有一個 Batch Size 適合所有模型
因此我們直接使用我們自己的 HAM10000 CNN 實際跑一次,這次比較:
Batch Size = 16
Batch Size = 32
Batch Size = 64
為了讓比較比較單純,其他設定盡量保持相同,只改變 Batch Size
為了避免三次實驗使用到前一次已經訓練過的模型,我們先把 CNN 寫成一個 Function,每次實驗都重新建立一個新的模型。
import tensorflow as tf

def create_model():

    model = tf.keras.Sequential([
       tf.keras.layers.Input(shape=(64, 64, 3)),
       tf.keras.layers.Conv2D(32,kernel_size(3,3),activation="relu",padding="same"),
       tf.keras.layers.MaxPooling2D(pool_size=(2, 2)),
       tf.keras.layers.Conv2D(64,kernel_size(3,3),activation="relu",padding="same"),
       tf.keras.layers.MaxPooling2D(pool_size=(2, 2)),
       tf.keras.layers.Flatten(),
       tf.keras.layers.Dense(128,activation="relu"),
       tf.keras.layers.Dense(7,activation="softmax")])

    model.compile(optimizer="adam",loss="sparse_categorical_crossentropy",metrics=["accuracy"])

    return model
這樣等等每一次實驗,都可以從一個新的 CNN 開始訓練。
這邊示範 batch_size=16 剩下兩個類似就不把程式碼貼上來了
from tensorflow.keras.callbacks import EarlyStopping

model_16 = create_model()

early_stopping_16 = EarlyStopping(monitor="val_loss",patience=3,restore_best_weights=True)

history_16 = model_16.fit(X_train,y_train,validation_data(X_val,y_val),epochs=50,batch_size=16,callbacks=[early_stopping_16])
接下來把三次實驗的 Validation Accuracy 畫在一起
import matplotlib.pyplot as plt

plt.plot(history_16.history["val_accuracy"],label="Batch Size = 16")
plt.plot(history_32.history["val_accuracy"],label="Batch Size = 32")
plt.plot(history_64.history["val_accuracy"],label="Batch Size = 64")

plt.xlabel("Epoch")
plt.ylabel("Validation Accuracy")
plt.title("Validation Accuracy with Different Batch Sizes")
plt.legend()
plt.show()
除了觀察 Validation Accuracy,我們也可以分別使用 Test Data 評估三個模型。
因為有使用 Early Stopping,所以三個模型實際停止的 Epoch 不一定相同,這也是正常的,代表不同 Batch Size 下,模型的訓練過程可能有所不同。
將 Batch Size 分別設定為 16、32、64 後,可以看到三組模型的 Validation Accuracy 都隨著訓練逐漸提升,但變化的情況並不完全相同。
loss_16, acc_16 = model_16.evaluate(X_test,y_test,verbose=0)
loss_32, acc_32 = model_32.evaluate(X_test,y_test,verbose=0)
loss_64, acc_64 = model_64.evaluate(X_test,y_test,verbose=0)

print("Batch Size 16 Test Accuracy:", acc_16)
print("Batch Size 32 Test Accuracy:", acc_32)
print("Batch Size 64 Test Accuracy:", acc_64)
從圖中可以發現: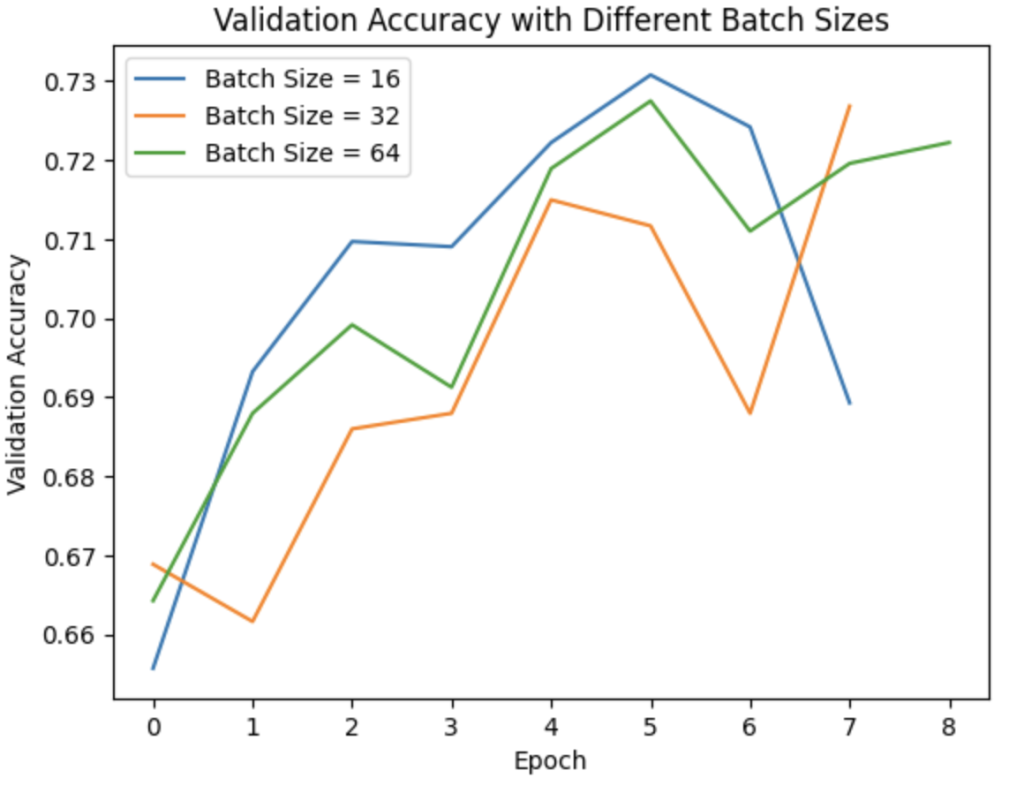
Batch Size = 16:Validation Accuracy 前期上升得相當明顯,在第 5 個 Epoch 左右達到約 73%,是三組實驗中出現的最高 Validation Accuracy,不過後面也出現明顯下降。
Batch Size = 32:前期的 Validation Accuracy 較低,中間也有一些波動,但最後一次訓練結果又上升到約 72.7%。
Batch Size = 64:Validation Accuracy 整體呈現逐漸上升的趨勢,中間雖然也有波動,但後期大約維持在 71%~72% 左右。
這次實驗也可以看到,不同 Batch Size 確實會讓模型的訓練過程產生不同變化。
其中 Batch Size = 16 曾經得到最高的 Validation Accuracy,但後期的下降也比較明顯;Batch Size = 64 的曲線相對沒有出現這麼大的下降,而 Batch Size = 32 則在最後一次訓練時再次提升。
不過,不能只根據某一個 Epoch 的最高 Validation Accuracy,就直接判斷哪一個 Batch Size 最好。
因為三個模型都使用了 Early Stopping,實際停止的 Epoch 不完全相同,而且模型訓練本身也可能存在一些波動。因此除了觀察 Validation Accuracy 的變化之外,還要是要使用相同的 Test Data 評估三個模型。
除了 Accuracy,Batch Size 還會影響另一件很實際的事情就是訓練速度。
Batch Size 越小,每個 Epoch 通常會有更多次參數更新;Batch Size 增大後,每個 Epoch 的 Batch 數量會減少。
不過實際訓練時間還會受到 GPU、記憶體、資料讀取方式和模型架構等因素影響,因此也不能直接說 Batch Size 越大就代表一定訓練越快,最準確的方法還是實際測試。
| Batch Size | 特性 |
|---|---|
| 較小 | 每次使用較少資料,梯度更新波動通常較大,需要的記憶體通常較少 |
| 較大 | 每次使用較多資料,梯度通常較穩定,但需要的記憶體通常較多 |
| 適中的 Batch Size | 在訓練速度、記憶體與模型表現之間取得適合目前任務的平衡 |
因此 Batch Size 並沒有一個固定的最佳答案,真正適合模型的 Batch Size,還是需要透過實驗比較。


 iThome鐵人賽
 看影片追技術