
上一篇我們終於建立了第一個 CNN Baseline Model,並在 Test Data 上得到:
Test Loss:0.7664
Test Accuracy:0.7349
看到 Accuracy 後,我們很容易直接用這個數字判斷模型好不好,如果今天有一個模型 Accuracy 達到 90%,是不是就代表它已經非常厲害了?
答案其實沒有這麼簡單
尤其我們前面已經發現 HAM10000 存在明顯的 Class Imbalance,如果只看 Accuracy,很可能會忽略模型在少數類別上的表現
今天就來認識另外三個常見的評估指標:Precision、Recall 與 F1-score
假設現在有 100 張圖片,90 張 A 類、10張 B 類,如果有一個很偷懶的模型,不管看到什麼圖片都預測全部都是 A 類,那它還是會答對 90 張,因此Accuracy = 90 / 100 = 90%,乍看之下模型 Accuracy 居然有 90%!
但仔細看就會發現,它其實連一張 B 類都沒有辨識成功,所以 Accuracy 告訴我們整體答對多少,但無法單獨告訴我們每個類別到底辨識得怎麼樣,這就是為什麼面對 HAM10000 這種 Class Imbalance Dataset 時,不能只看 Accuracy
在理解 Precision 和 Recall 之前,要先認識四個常見的名稱:
| 名稱 | 意思 |
|---|---|
| TP(True Positive) | 實際是 Positive,模型也預測 Positive |
| TN(True Negative) | 實際是 Negative,模型也預測 Negative |
| FP(False Positive) | 實際是 Negative,但模型預測成 Positive |
| FN(False Negative) | 實際是 Positive,但模型預測成 Negative |
假設現在我們只關心 mel,並把 mel 當作 Positive,那麼:
Accuracy 就是我們前面一直使用的正確率,公式:
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Accuracy 雖然很直觀,但當類別數量差距很大的時候,就可能無法完整反映模型表現
四、Precision:你說是的,有多少真的是?
Precision(精確率)回答的是模型預測為這個類別的資料中,有多少真的屬於這個類別?
Precision = TP / (TP + FP)
假設模型預測 20 張圖片是 mel,但實際檢查後只有 15 張真的是 mel,5 張其實不是 mel 那麼Precision = 15 / (15 + 5) = 0.75 = 75%
所以 Precision 越高,代表模型「預測成這一類」時,錯抓其他類別的情況越少
Recall(召回率)看的方向不太一樣,它回答真正屬於這個類別的資料中,模型成功找出了多少?
公式:
Recall = TP / (TP + FN)
假設 Test Data 中實際有 30 張 mel,但模型只成功辨識 15 張,另外 15 張被預測成其他類別,那麼:Recall = 15 / (15 + 15) = 0.5 = 50%
在醫學影像相關的模型評估中,漏掉目標類別可能是值得特別觀察的錯誤,因此 Recall 往往會是需要關注的指標之一,不過哪個指標最重要,仍要依實際任務、錯誤成本與用途決定
一個是從模型的預測結果出發,一個是從真正的 Label出發
| 指標 | 問的問題 |
|---|---|
| Precision | 我「預測是」的裡面,有多少真的對? |
| Recall | 「真的就是」的裡面,我找出了多少? |
既然 Precision 和 Recall 看的東西不太一樣,那有沒有辦法同時考慮兩者?這就是 F1-score,公式為:
F1 = 2 × (Precision × Recall)/Precision + Recall
F1-score 是 Precision 與 Recall 的調和平均,當其中一個很低時,F1-score 通常也會受到明顯影響
先讓模型預測所有 Test Data:
import numpy as np
y_pred_prob = model.predict(X_test)

# 找出每一張圖片機率最高的類別
y_pred = np.argmax(y_pred_prob, axis=1)

print(y_pred[:10])
print(y_test[:10])
上一篇的 Softmax 會產生 7 個類別的輸出,而 argmax() 就是找出其中最大值的位置,作為模型最後預測的類別。
接著使用 classification_report:
from sklearn.metrics import classification_report
print(
classification_report(y_test,  y_pred, target_names=class_names, digits=4, zero_division=0)
)
執行後,就可以看到每個類別各自的: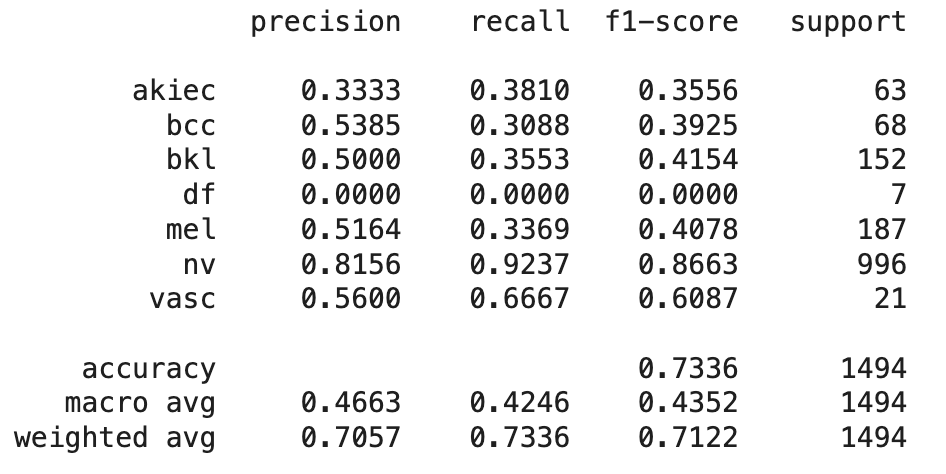
其中 support 代表 Test Data 中該類別實際有多少筆資料
這也是這次最重要的地方,上一篇我們得到 Test Accuracy ≈ 73.49%,但只有這個數字,我們不知道模型判斷各個類別的表現如何,因此透過classification_report,我們才可以進一步看到模型在不同類別上的 Precision、Recall 和 F1-score
Macro Average 會先分別計算每個類別的指標,再讓每個類別具有相同權重地取平均
也就是不管某個類別有 1000 張還是只有 100 張,都會被同等看待,因此在 Class Imbalance 的情況下,可
以幫助我們觀察模型是不是只在多數類別表現得比較好
Weighted Average 則會根據每個類別的 support 給予不同權重,資料越多的類別,對最後平均值的影響也越大
所以兩者看的角度不太一樣:
| 指標 | 特點 |
|---|---|
| Macro Average | 每個類別同等重要 |
| Weighted Average | 依各類別資料數量加權 |
對 HAM10000 這種不平衡資料來說,除了整體 Accuracy,也很值得一起觀察各類別指標與 Macro F1


 iThome鐵人賽
 看影片追技術