
從這篇開始換個方向:產品本身就是 AI,該怎麼測?
越來越多公司開始做自己的 AI Agent 產品,客服助理、智能搜尋、內部知識問答……當你的團隊也有一個這樣的產品要上線,測試的思維就跟以前不一樣了。
這篇先把 AI Agent 測試跟傳統軟體測試的差別講清楚。
QA 常見的工作可能包括:
| 測試類型 | 說明 | 例子 |
|---|---|---|
| 冒煙測試 | 新版本上線前的快速檢查 | 點一次按鈕,看有沒有爆炸 |
| 回歸測試 | 改了某個功能,檢查有沒有影響其他地方 | A 功能改了,確認 B、C、D 還能用 |
| 功能測試 | 根據規格書驗證功能有沒有 Bug | 輸入帳號密碼,看能不能登入 |
| 邊界測試 | 測試邊界情況 | 輸入 99999999,看會不會出錯 |
| 整合測試 | 測試多個模組一起動作 | 登入 → 查詢資料 → 結帳,全流程 OK? |
AI Agent(AI 代理):不只會回答問題,還會自己決定下一步要做什麼、要呼叫什麼工具的 AI 應用。
這裡只是借大家熟悉的產品說明概念,後面講的測試方式,可以自行帶入你們公司自己開發的 Agent 產品。
| 產品 | 你給它一句話 | 它背後自己決定的事 |
|---|---|---|
| ChatGPT | 「幫我查一下明天台北天氣」 | 要不要上網搜尋?搜什麼關鍵字?結果怎麼整理成回答? |
| Claude Code | 「幫我修這個 bug」 | 要讀哪些檔案?改哪一行?要不要跑測試確認? |
傳統軟體是「你點什麼,它做什麼」;Agent 是「你說目標,它自己想路徑」。
這就是測試變難的開始。
假設公司做了一個客服 Agent,使用者問「我的訂單到哪了?」,它會回答訂單狀態。
用傳統的角度,你可能會想到:按鈕能不能按、API 有沒有回 200、回覆有沒有出現、文案是否正確 ...等等
| 傳統角度會測的 | Agent 真正要測的 |
|---|---|
| 輸入框能不能送出 | 它有沒有理解我要什麼 |
| API 有沒有回應 | 它有沒有叫對工具(真的去調用訂單工具,而不是憑印象回答) |
| 文案是否正確 | 回覆的內容對不對、有沒有亂編 |
| 流程有沒有走完 | 它思考走的路徑是不是合理的那條 |
| 維度 | 傳統應用 | AI 應用 |
|---|---|---|
| 輸出 | 確定的(同一輸入永遠同一輸出) | 機率的(同一問題每次答案可能不同) |
| 驗證 | 功能測試(有沒有 Bug) | 內容評估(答案品質好不好) |
| 標準 | 規格書(清晰的需求) | 品質指標(如何判斷答案「夠好」) |
| 難度 | 二元判斷(對或錯) | 多元判斷(答案有多個可能對的情況) |
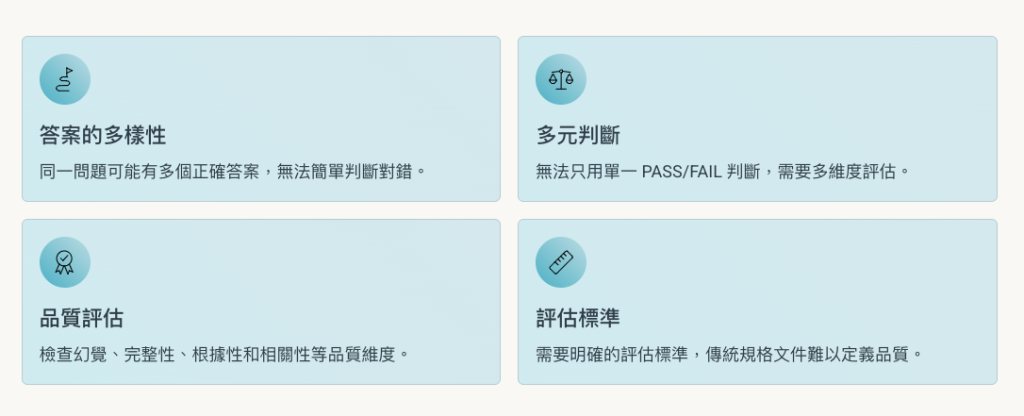
答案的多樣性(多個正確答案)
Q: 「我的包裹已經晚兩天了,還沒到怎麼辦?」

AI 可能回答的答案:
✅ A: 目前物流顯示配送中,建議再等 1~2 天...
✅ B: 可以提供物流單號,直接聯絡物流公司確認...
✅ C: 已延遲超過 2 天,可以幫你申請補寄或退款...

都是「對」的,但怎麼判斷 AI 選哪一個?
多元判斷
傳統測試應用:
登入功能 → 成功登入 → ✅ PASS / ❌ FAIL

AI 應用:
「包裹還沒到」→ AI 建議「申請退款」
                ↓
           這是對還是錯?
     - 如果用戶其實只想知道包裹在哪? ❌
     - 如果包裹真的已經延遲很久? ✅
     - 如果是他想要的處理方式? ✅
     - 無法一翻兩瞪眼
品質評估
傳統測試應用:只看有沒有 Bug

AI 應用:還要看
  - 答案有沒有幻覺(編造不存在的東西)?
  - 答案完不完整?(遺漏了什麼重要資訊嗎)
  - 答案有沒有根據?(是瞎掰還是有根據)
  - 答案有沒有相關性?(有沒有答非所問)
評估標準
傳統測試應用的標準很清楚:
「用戶帳號 = admin,密碼 = 123456 時應該能登入」
→ 規格文件定義清楚 → QA 按標準驗證 → PASS/FAIL

AI 應用:「客服 Agent 回答包裹延遲問題」
→ 什麼叫「好的回答」?沒人定義
→ 相關性好?
→ 完整性如何?
→ 有沒有幻覺?
→ 無法明確判斷

即使有規格文件說「回覆要親切且有幫助」,也很難寫出自動化規則判斷「是不是真的有幫助」


 iThome鐵人賽
 看影片追技術