
昨天講完 AI E2E 架構的前三個階段,腳本產出來了,每天也能用純程式跑。
但自動化真正痛的地方,是網站改版之後。
這篇講剩下三個階段:自我修復、收斂知識庫、代碼檢查與 AI 審核,也就是「讓測試養得起」的部分。
錯誤有人會去看,真正危險的是明明有問題卻顯示通過。
在 AI 自我修復的情境下,最常見的假綠燈長這樣:
開發不小心把功能改壞了
      ↓
測試顯示錯誤
      ↓
AI 以為是「測試寫得太舊」,把預期改成符合現在(壞掉)的畫面
      ↓
測試變綠 → 一個真實的 bug 被自動化「認證」成正常
測試壞掉時,AI 不是直接動手修,而是先判斷是哪種壞法: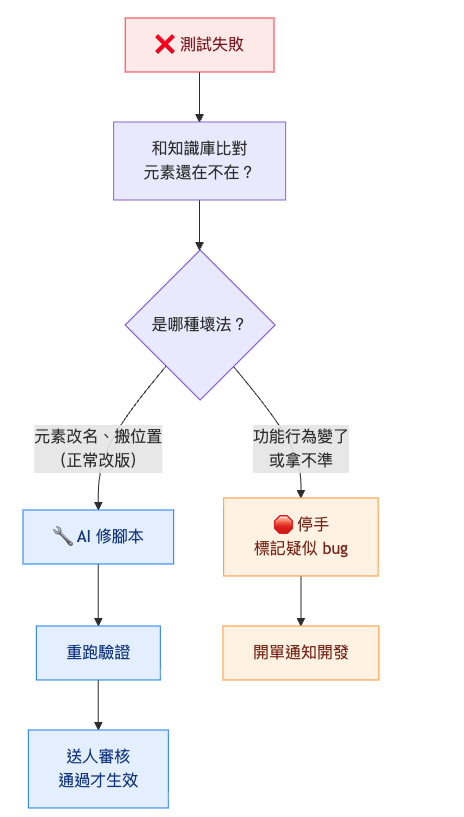
分界線定成三條硬規則:
| 狀況 | AI 怎麼做 |
|---|---|
| 按鈕搬家、改名字、流程多一步 | 這是改版,正常修 |
| 實際的結果或行為,跟原本的預期對不上 | 一律停手,開單給開發 |
| 拿不準是哪一種 | 一律當成疑似 bug 上報 |
| 反覆修不好 | 控制執行總次數,達上限回報給用戶做決定 |
寧可多一次人工確認,不可放過一個真 bug。
而且就算修好了,也不會自己生效,要送人審核過才算數。
知識庫幫每個頁面存一份「它長什麼樣」:元素位置、頁面結構與截圖、還有哪些測試依賴這個元素。
它有兩個用途:
但回寫知識庫是有條件的:只有「確認是正常改版」而且「經人審核」才能更新。
不然就會把壞掉的頁面凍成新標準,bug 直接被蓋掉。
「這個欄位在業務上代表什麼意思」,例如「顯示『已送出』代表對方看得到了」。
知識庫其他部分都能自動重建,只有這個要人補。留空的話,下一個接手的人或 AI 就得從零重新理解這頁。
交付前要過兩層把關:
| 誰來審 | 審什麼 | |
|---|---|---|
| 第一層 | 程式 | 明文禁止的事:密碼寫進程式、改到不該改的範圍。零成本、結果固定 |
| 第二層 | 另一個獨立的 AI | 機器判斷不了的事:重複的邏輯該不該整合、檔案放錯地方、跟既有做法不一致 |
最後還有一道驗收:重複跑,確認穩定才算完成。
⚠️ 時好時壞(flaky)比直接失敗更糟。
一支偶爾會錯誤的測試,久了大家就不信它,真的壞掉那次也會被當成「又是老毛病」放過去。
整套流程刻意留了幾個「停下來問人」的點:
| 環節 | 為什麼一定要人 |
|---|---|
| 核可「要測什麼」 | 業務判斷,不是技術判斷 |
| 填帳號密碼 | 憑證不經手 AI |
| 補欄位的業務語意 | AI 看得到畫面,看不懂業務 |
| 審核修復結果、知識庫更新 | 防止把 bug 修成綠燈 |
| 判定疑似 bug | 最終要不要開單,由人決定 |
AI 負責把事情做完,人負責把關「做得對不對」。


 iThome鐵人賽
 看影片追技術