
前面四天,把 Browser-use 跟 Chrome DevTools MCP 各自從安裝、功能一路跑到實戰。
兩個工具都能讓 AI 開瀏覽器跑 E2E 測試,但跑起來的「底層邏輯」完全不一樣。
這篇把兩者攤開來比,最後回答一個最實際的問題:我的團隊該選哪一個?
(以下 Chrome DevTools MCP 一樣簡稱 CDP)
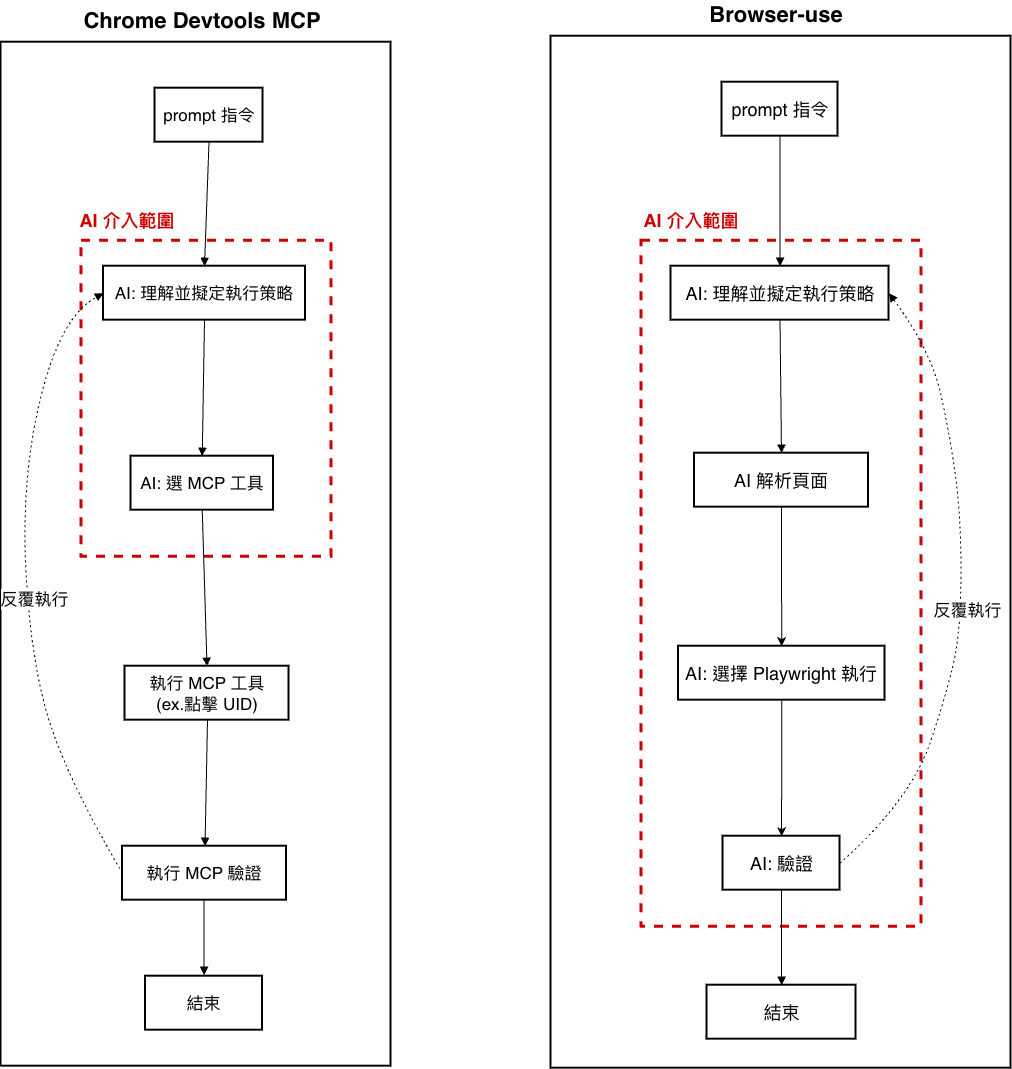
看紅色虛線框,也就是 AI 介入的範圍:AI 介入的環節越多,每一環就有可能會幻覺、判斷錯誤。
CDP 的動作是「確定性」的,browser-use 的操作是「語義性」的。
👉(這就像請人幫你按電梯。CDP 是按完回你「按了,燈亮了」;browser-use 是按完看一眼說「應該有按到吧」。)
| 項目 | CDP | browser-use |
|---|---|---|
| 修復策略 | 透過 DevTools Event(DOM change、Error log、Network event)偵測問題再即時 retry | 模型重新解讀整個頁面語義,再重新規劃「下一步行為」 |
| 成功率 | 高(靠具體 DOM 狀態判斷) | 中低(模型會誤判成「元素換地方」或「任務已完成」) |
| 延遲 | 低 | 高(修復過程 LLM 要重跑思考鏈多次) |
CDP 知道「發生了什麼」,browser-use 只能推測「可能發生了什麼」。
| 維度 | Browser-use | Chrome DevTools MCP |
|---|---|---|
| 上手速度 | ★★★★★ 不會寫程式的人也能描述流程,寫測試變成寫需求 | ★★★★☆ 測試案例直接貼,但 Prompt 規則要自己調到位 |
| 維護成本 | ★★☆☆☆ 表面上很低,但「它自己修好的到底對不對」得靠人看 | ★★★★☆ 因為失敗訊號可信 |
| 可控性 | ★★☆☆☆ 每次執行路徑都不一樣,這是設計使然,不是 bug | ★★★★☆ 有明確回饋、可以規定重試次數 |
| 知識沉澱 | ★☆☆☆☆ 這次學到的東西,下次完全不記得 | ★☆☆☆☆ 每次都重新 take_snapshot,一樣從零開始 |
CDP 把「可控性」補起來了,但「知識沉澱」那格,兩個都是空的。
| 項目 | 傳統方式 | browser-use | Chrome DevTools MCP |
|---|---|---|---|
| 元素定位 | ❌ 手動維護 XPath / CSS | ✅ AI 看畫面+頁面結構去推裡 | ✅ AI 純讀頁面結構推裡 |
| 改版抗壓性 | ❌ 改版就壞 | ⚠️ 它可能會「繞過去了」 | ⚠️ 會重新找元素,找不到就明確回報失敗 |
| 測試正確性 | ✅ 高 | ⚠️ 畫面看起來對就算過 | ✅ 較高,還能驗 Network / Console |
| 失敗訊號可信度 | ✅ 紅燈就是有問題 | ❌ 綠燈不一定可信 | ✅ 紅了大多是真的有問題 |
| 你的目標 | browser-use 適合嗎 | Chrome DevTools MCP 適合嗎 |
|---|---|---|
| 探索性測試:這頁有什麼可以測、有沒有明顯的坑 | ✅ 非常適合,它比你手動點得快,還會發現你沒想到的路徑 | ⚠️ 可以,但它比較「聽話」,要你給明確方向,不太會自己亂逛 |
| 一次性驗證:這個流程現在通不通 | ✅ 很適合,五分鐘給你答案,不用先寫一支腳本 | ✅ 很適合,而且能順便看 API 跟 Console 有沒有異常(尤其是爬蟲,效果真的很好) |
| POC / Demo:讓不寫程式的同事看到自動化的樣子 | ✅ 適合 | ✅ 適合,尤其想展示「連 API 都一起驗」的時候 |
| 回歸測試:每天跑、要能相信結果 | ⚠️ 需要足夠的技術成本進行開發 | ⚠️ 需要足夠的技術成本進行開發 |
| CI 守門:擋住不該進版的東西 | ❌ 目前不建議,沒有固定的程式碼產物 | ❌ 目前不建議,每次都重新判斷元素,建議轉成腳本再進 CI |
看出規律了嗎?
browser-use 跟 CDP 都只是「手腳」,真正在判斷的是背後接的 AI 模型。
我實驗時用同一份 Prompt、同一個測試案例,換了好幾個模型跑,結果差距非常大:
| 模型等級 | 實際表現 |
|---|---|
| 高階模型(各家當期的旗艦/主力模型) | UI 操作能完整跑完,產出的報告完整,生成的腳本有機會一次 PASS |
| 便宜或免費的小模型 | 步驟跑到一半就失敗、中斷,甚至根本無法執行 |
模型更新很快,這裡不列具體型號,重點是等級,不是名字。
畢竟想要用 AI E2E,其實這本身就是一件花 token 的事情,建議真的不要為了省錢用免費的公開模型,省下來的錢,會用你的時間加倍還回去 XD
這件事本身也是一個 QA 判斷題: 你以為你在選模型,其實你在選「這個測試結果值不值得相信」。
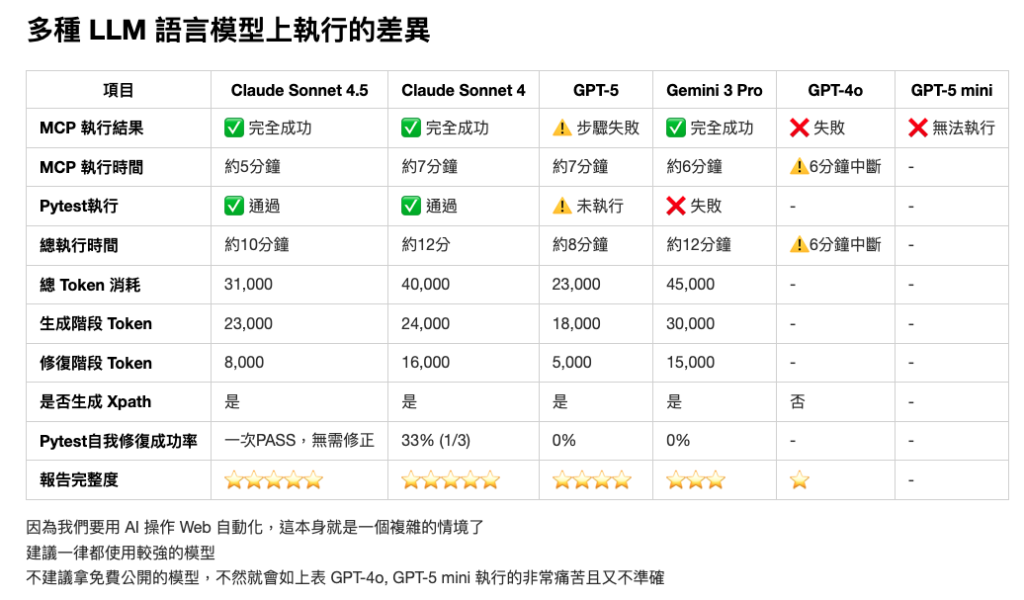
附上我之前針對 CDP POC 時的模型分析表格共大家參考就好,但因為模型迭代的實在太快了,這些就不準確了
老實說,比完之後我沒有「選一個就好」的答案。
兩個工具各自都很好,好到讓我看清楚,缺的那一塊到底是什麼:它們都不記得上次做了什麼。
一個不會累積的系統,第一百次執行跟第一次執行,能力完全一樣。


 iThome鐵人賽
 看影片追技術