

做到 Day 19 之後,Visual Learning Lab 已經有 PDF 分析、Source Atlas、Learning Scene、Spatial Learning World、互動模擬、來源追溯、Quiz 等功能。不過前幾天滑到一句話,讓我開始重新想這個專案接下來到底該怎麼做:
都已經在 Vibe Coding 了,為什麼還要重新發明別人早就做好的輪子?
這句話其實滿有道理。
PDF parsing、OCR、RAG、Knowledge Graph、互動教材、數學視覺化,GitHub 上早就累積了一大堆成熟專案。如果我花好幾天重新寫一個只能做到 60 分的版本,而開源世界已經有人做到 90 分,那不叫做「比較有自己的東西」,只是浪費這 30 天。
所以 Day 20 我沒有直接再新增一個功能,而是做了一次比較大的 Open-Source Leverage Sprint。
目標很簡單:先搞清楚哪些東西已經有人做得很好、哪些可以合法直接利用、哪些只能研究設計,以及 Visual Learning Lab 真正值得繼續自己做的核心到底是什麼。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
以前很多開發流程都是:
「我要某個功能。」
接著 ChatGPT 幫我定義需求,再交給 Codex 實作。
但 Day 20 我刻意換了一種方式。
我沒有直接指定:
「改成 Docling。」
也沒有說:
「幫我裝 MinerU。」
而是先和 ChatGPT 把問題定義成:
Visual Learning Lab 現在哪些地方正在重造輪子?開源世界有哪些成熟方案?哪些適合直接 reuse、哪些應該 wrap、哪些只能研究?
接著讓 Codex 自己去讀 GitHub、官方文件、License、deployment requirements,再回頭檢查我們目前的架構。
最後它整理了 30 個候選與既有元件,包含文件解析、RAG、Knowledge Graph、互動教材、數學 renderer、simulation framework 等不同方向。
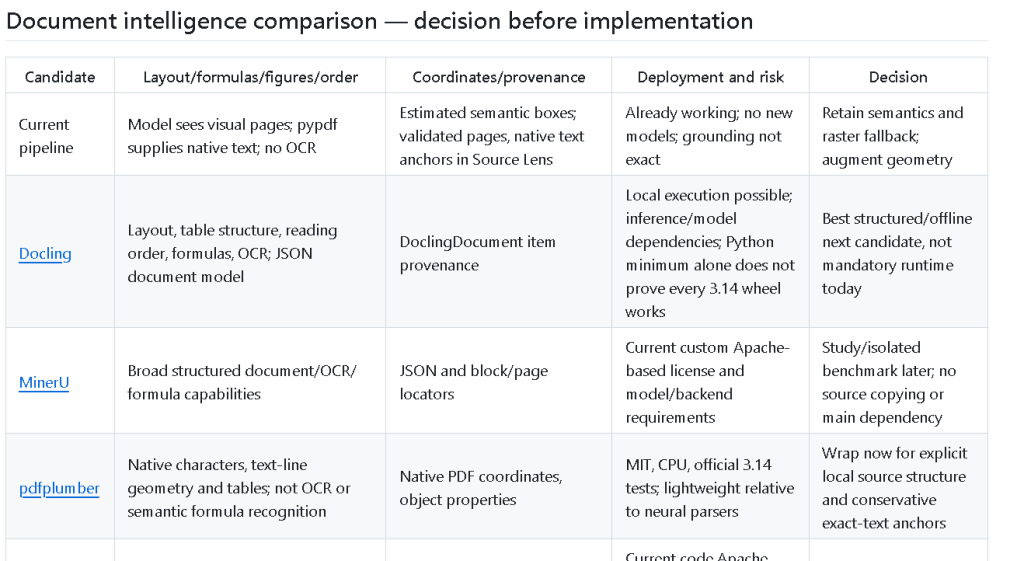
這張圖其實滿能代表今天的差別。
以前比較像:
想到功能 → 寫。
今天變成:
想到能力 → 找 prior art → 看 License → 看 deployment → 判斷值不值得整合 → 最後才寫。
有些東西真的已經不能再當成 Visual Learning Lab 的核心賣點了。
例如:
現在都有很多成熟工具。
Codex 甚至找到一些跟我們目前方向非常接近的 prior art。
例如 Augmented Physics 已經研究過 textbook diagram → embedded simulation;AlgeBench 有 semantic graph 與 3D visual learning;ViviDoc 甚至已經在使用類似 State / Render / Transition / Constraint 的思路;Docling Graph 也已經處理 document provenance 和 graph node 的連結。
所以做到 Day 20,我覺得有一件事情必須講清楚:
「教材可以變成互動內容」本身不是一個我們可以假裝只有自己想到的概念。
這反而讓方向變得比較清楚。
Visual Learning Lab 真正值得繼續做深的,應該是:
原始來源
    ↕
可驗證的 Semantic Entity
    ↕
Shared Learning State
  ↙      ↓      ↘
公式    世界     練習
    ↕
使用者互動 / 錯誤 / 學習狀態
也就是同一個概念能不能真的跨過原教材、公式、互動世界和學習活動,而且始終還是「同一個東西」。
研究完這一輪後,Codex 沒有直接把五六個大型專案全部塞進 requirements.txt。
最後第一個真正整合的是 pdfplumber。
原因跟 Day 19 很直接相關。
昨天做 Source Atlas 時,系統可以看到 PDF,然後估計某個公式、標籤或圖示大概位在哪裡。
但那個 bounding box 本質上還是模型估計,所以畫面下面我一直保留:
區域為估計定位,請核對原頁。
可是如果一份 PDF 本身就有真正的 text layer,那其實有些位置根本不用 AI 猜。
pdfplumber 可以直接讀 PDF 裡原生字元、文字行和座標。
所以 Day 20 多了一個:
本機解析文件結構
它不需要 OpenAI,也沒有模型推理。
對有 native text 的 PDF,系統可以先取得 deterministic geometry,再提供給 Source Atlas。
也就是以前:
AI:
這條公式大概在這裡。
現在有機會變成:
PDF parser:
這行文字實際座標在這裡。

AI:
這行文字語意上是 velocity equation。

Source Atlas:
把兩者接起來。
這個分工比全部交給模型合理很多。
我很喜歡 Day 20 最後沒有走成:
pdfplumber 比 AI 準,所以以後都不用 AI。
因為 pdfplumber 知道文字在哪裡,不代表它知道那個東西在「講什麼」。
例如它可以知道:
a(t) = (0,-g)
這行文字的座標。
但它不會因此自動知道:
所以 Day 20 做的是一個新的 Document Intelligence Adapter。
概念大概是:
PDF
 ↓
Document Intelligence Layer
 ├─ pypdf
 ├─ pdfplumber
 └─ 未來 Docling / OCR / 其他 parser
 ↓
Normalized Document Model
 ↓
Source Atlas / Semantic Compiler
也就是第三方 parser 只負責自己擅長的事情。
Visual Learning Lab 自己保留 semantic model。
這樣未來如果 Docling、OCR 或另一套 parser 對某些文件更強,也不用把整個產品推倒重做。
這輪也做了一個小型 benchmark。
使用 7 組明確標示的合成案例,包含:
加入 pdfplumber geometry 後,額外解析時間大約落在數十毫秒。
其中一條公式的 normalized bounding-box area,從:
0.087
縮到:
0.00757
看起來差很多。
但這裡我刻意不寫:
準確率提升 91%。
因為這不是準確率。
它只能證明:
加入 native PDF geometry 後,某些公式的框可以收得更緊。
如果框得超準,但 semantic mapping 認錯概念,那照樣是錯的。
所以這次我把它叫做 localization evidence,不是 accuracy benchmark。
真正的準確率,還是要等後面建立有人工 ground truth 的真實教材 benchmark 才能講。
Day 20 第一輪完成時:
新增 20 個測試
Focused:59 passed
完整 regression:202 passed
看起來很漂亮。
結果我實際打開 App,按:
「本機解析文件結構」
它直接跟我說:
此 PDF 暫無法使用本機結構解析,原始來源與 AI 定位仍可使用。
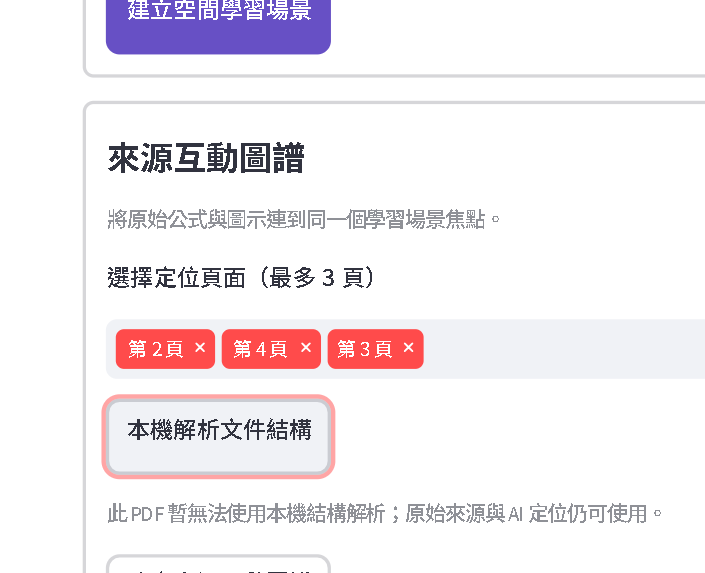
一開始還以為 PDF 本身沒有 native text。
但我拿完全同一份 projectile PDF,直接在 PowerShell 呼叫 pdfplumber。
結果:
[(1, 275, 256), (2, 640, 622)]
第 1 頁有 275 個可抽取文字,第 2 頁有 640 個,而且兩頁都有大量 native char objects。
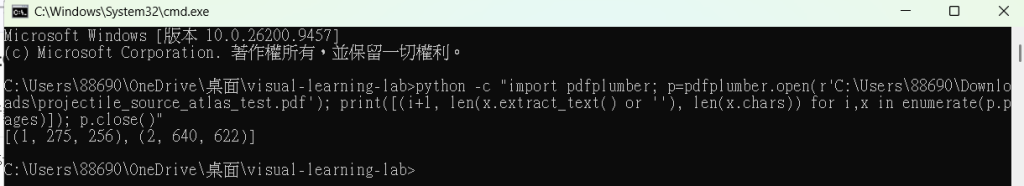
所以這次問題就縮得非常小了。
不是:
而是:
parser 明明成功,但從 parser → normalized model → Streamlit UI 的整合路徑出問題。
這就是我這幾天越來越喜歡 live-test 的原因。
Automated tests 可以保證很多東西。
但真正的使用順序,還是很容易抓到測試沒有想到的情況。
->後來 Codex 用我實際測試的 projectile PDF 重現問題。
最後找到的 root cause 非常有趣。
pdfplumber 其實成功解析出了:
34 個合法文字區域。
但在進入 Visual Learning Lab 的 normalized document model 時,其中一個 footer 被 Validator 丟掉了。
原因是那行普通文字裡有:
->
也就是兩個很普通的 ASCII arrow characters。
原本共用的 generated-text safety policy 只要看到 < 或 > 就直接拒絕,因為這些符號也可能出現在 HTML / markup 裡。
結果:
原本是為了防 AI generated markup 的安全規則,被錯誤套用到 PDF 裡的原生純文字。
其中一個 native region 被丟掉後,document normalization 又不允許接受「部分遺失」的結果,最後整份 native structure 就被 App 當成 unavailable。
這個 bug 我其實滿喜歡的。
因為它不是把 Validator 關掉就解決。
真正的修法是:
generated semantic text 和 native PDF text 本來就應該有不同 trust policy。
所以最後新增的是一套只給 native plain text 使用的 policy。
普通的:
->
可以留下來。
但是像:
<script>...</script>
或:
<svg onload=...>
仍然會被拒絕。
也就是沒有為了讓 demo 跑起來而把安全規則放寬。
這次 live bug 又新增了 8 個測試。
Day 20 最終變成:
Day 20 tests:28 passed
完整 regression 最後重新跑一次:
210 passed
而且這次測的不只是 synthetic fixture。
Codex 把我真人使用的那份 projectile PDF 原封不動放進 test fixture,比對 SHA-256,直接確保:
-> 仍然是普通文字做到這裡,我才比較敢說 Day 20 的整合真的有落地。
修完之後,我又拿之前的手寫機率論筆記測。
它仍然不能使用這套本機結構解析。
但這次我沒有把它當成 bug。
因為 pdfplumber 不是 OCR。
它處理的是:
PDF 裡真正存在的 native text。
如果一頁本質上只是手寫圖片,它就不應該突然裝作自己知道每一個字的位置。
所以目前流程是:
有 native text
→ 本機解析
→ native geometry

掃描 / 手寫 / image-only
→ 本機解析不可用
→ 回到原本 AI Source Atlas
而且原本的 AI source grounding 仍然可以使用。
這就是我想要的 graceful fallback。
不是:
新工具做不到 → 整個產品不能用。
而是:
做得到的地方用 deterministic tool,做不到再交回原本的方法。
Day 20 另外留下了一份 Open Source Reuse Ledger。
每個候選大概分成:
例如:
pdfplumber → REUSE NOW
Docling → ADAPT / WRAP,之後可以做更完整 structured document benchmark
JSXGraph → 很值得後面研究 direct manipulation
OpenSeadragon → 很適合未來 Source Atlas 的大型來源檢視
H5P / PhET → 學習互動與 UX 值得研究
LearnHouse → 可以研究 navigation,但 AGPL code 不直接搬
MinerU → License 和 deployment 都需要更小心
RAGFlow → 很強,但沒有必要把整個大型 RAG server 塞進 Streamlit
這個分類之後會變成開發規則。
從 Day 20 之後,之後的大功能都多一條規則:
在寫 substantial capability 前,先找 prior art。
也就是:
這件事聽起來很理所當然。
但老實說,前 19 天我還真的常常是:
想到東西 → 直接叫 Codex 做。
Day 20 算是正式把流程改掉。
這次也第一次比較認真整理第三方授權。
例如 pdfplumber 是 MIT,比較適合直接使用。
但專案裡原本使用的 PyMuPDF 是 AGPL / commercial licensing,這件事在未來真的公開部署、散布產品之前還需要處理。
另外像 MinerU、Marker、PhET、LearnHouse,也各有自己的 License、model weight 或 asset 條件。
所以我另外留下:
THIRD_PARTY_NOTICES.md
和:
OPEN_SOURCE_REUSE_LEDGER.md
至少之後不會發生:
Day 23 Codex 搬了一個東西,Day 30 已經沒有人記得它從哪裡來。
如果只看 App,今天新增最明顯的功能大概就是:
「本機解析文件結構」。
它甚至沒有 Day 18 的 Spatial Learning World 那麼炫。
但我覺得今天反而讓整個專案往前走了一大步。
因為我開始接受:
全部自己寫,不是優點。
如果別人已經把 PDF geometry 做得很好,就直接站上去。
如果別人已經做出成熟 graph renderer,就不要再花三天畫節點。
如果 H5P、PhET 已經花很多年研究互動教材 UX,那就研究它們。
Visual Learning Lab 真正該花力氣的,是把這些能力接成一個自己的系統。
做到 Day 20,我目前最想保留的核心變得更清楚:
原始教材裡的一個東西,可以變成一個穩定的 semantic entity。
這個 entity 可以同時出現在原教材、公式、互動世界、Quiz 和之後的 learner state。
使用者從任何一邊操作,其他 representation 都知道現在正在學同一個概念。
這個才是後面值得繼續做深的地方。
所以 Day 20 對我來說,不只是第一次真正接進一個開源工具。
更像是專案開發方式的轉折。
Vibe Coding 不應該只是:
AI 幫我更快重新發明輪子。
而應該是:
AI 幫我更快找到世界上已經存在的輪子,然後把有限的時間拿去造真正不一樣的車。


 iThome鐵人賽
 看影片追技術