

做到 Day 20,Visual Learning Lab 已經累積了一堆東西:PDF 分析、Source Atlas、Concept Map、Quiz、互動模擬、Spatial Learning World、來源追溯……
問題是,它開始有點像一間什麼都有的倉庫。
每一個功能單獨看都可以用,但使用者真的丟進一份教材之後,畫面會一路往下長:
摘要在上面、來源在下面、模擬又在更下面、Quiz 還要繼續滑。
功能越做越多,反而越不像一個完整的學習工具。
所以 Day 21 我先停下來處理一件很基本、但其實非常重要的事情:
讓這些功能第一次真的變成「同一個學習環境」。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
我和 ChatGPT 先把 Day 21 的第一個問題定義得很簡單:
使用者現在不是缺功能,而是不知道自己到底正在「理解」、「找來源」、「探索」,還是「練習」。
所以 Codex 沒有再新增第五、第六種功能,而是把原本的結果頁重新整理成四個主要模式:
而且不是單純用四個 tab 把原本內容全部塞進去。
這點我特別要求 Codex 注意,因為 Streamlit 的某些 tab 寫法即使使用者沒有打開,裡面的內容還是可能被執行。
所以現在的 Workspace 只會真正 render 當前模式。
這件事情表面上只是 UI 整理,但真正重要的是下一步。
Day 17 開始,我一直在做一個叫做 semantic focus 的東西。
簡單來說,就是讓系統知道:
使用者現在正在看哪一個概念?
Day 21 把它正式拉成整個 Workspace 共用的狀態。
例如我拿之前做的拋體運動教材測試。
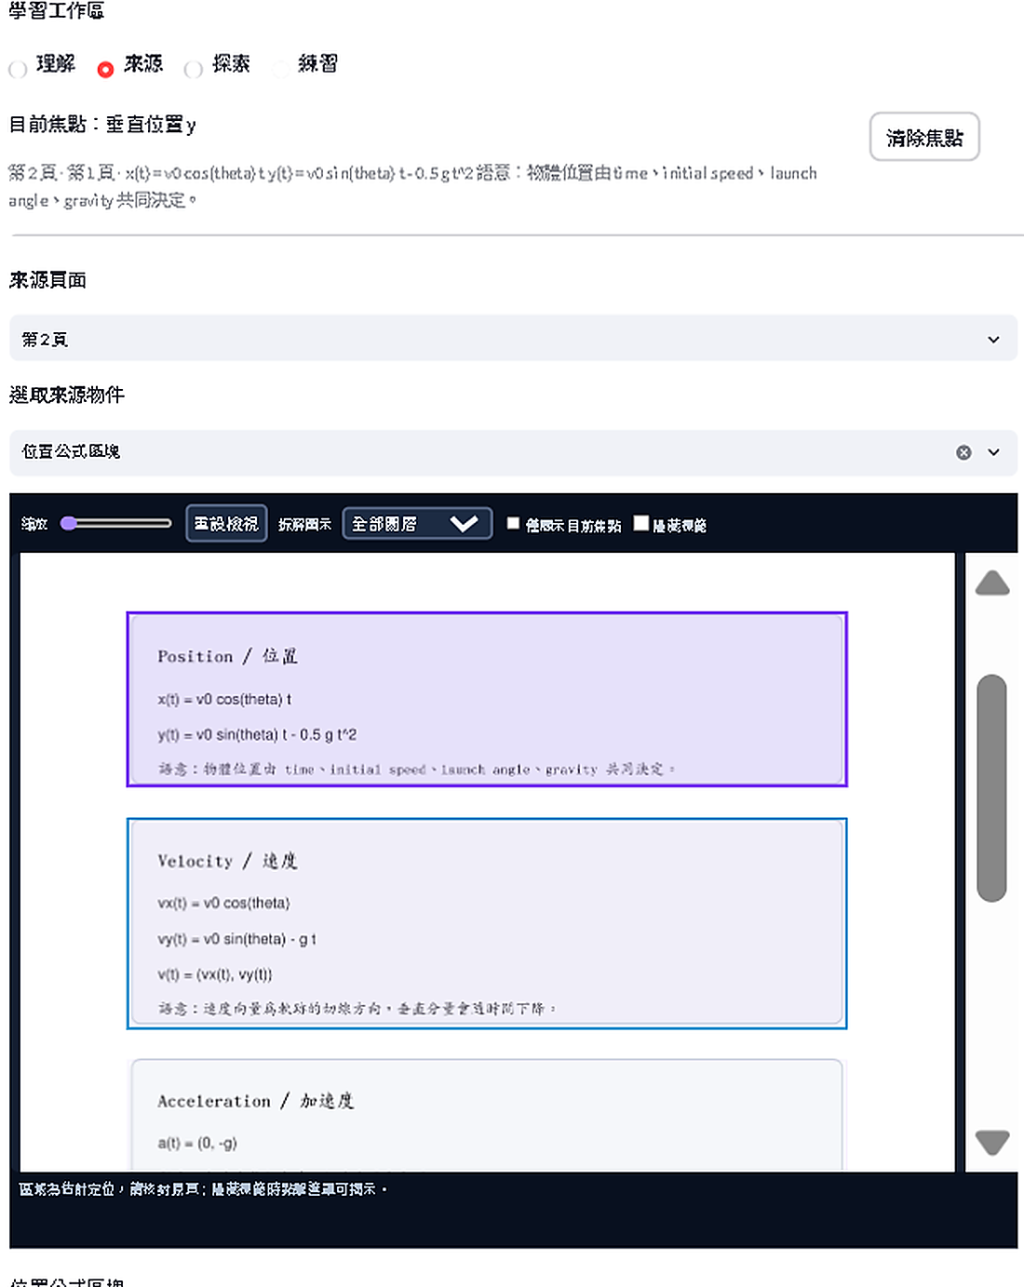
在「來源」裡,我可以直接選原始 PDF 裡的:
位置公式區塊
這時候上面的目前焦點會變成:
垂直位置 y
接著我切到:
「探索」
Spatial Learning World 並沒有重新從頭開始。
它知道我剛才正在看的是 y,所以互動場景裡和高度、垂直位置有關的狀態也會一起被 focus。
也就是:
原始 PDF 的位置公式
        ↓
semantic focus:垂直位置 y
        ↓
Spatial Learning World
        ↓
高度 / y 的互動狀態
再切回來源,原本選的東西也不會直接消失。
這一整段切換:
不需要再呼叫 AI。
它只是同一個 learning state 在不同 representation 之間切換。
這個功能其實沒有新增一個很炫的圖,但我覺得它對整個專案滿重要的。
因為到這裡,Visual Learning Lab 才開始不是:
「很多 AI 功能放在同一頁。」
而比較接近:
「同一個知識,可以從不同角度被觀察。」
Workspace 做完、實際測試也可以正常 Source → Explore → Source 之後,我其實還有一個一直很想做的東西。
前幾天我一直在想:
很多很難懂的東西,我們最後其實都是靠「比喻」才第一次真的懂。
像電流常被比成水流。
Queue 可以想成排隊的人。
Phase 可以想成不同角度的時鐘指針。
Feedback control 可以想成開車時一直修正方向。
如果 ChatGPT 本來就很會想比喻,那 Visual Learning Lab 能不能更進一步:
不只是把比喻講出來,而是把比喻直接變成一個可以操作的世界?
所以 Day 21 後半段,我把這個東西叫做:
這次的目標不是叫 AI 回答:
電流就像水流。
那 ChatGPT 本來就做得到。
我想要的是:
正式概念
   ↓
AI 找一個適合的譬喻
   ↓
正式概念 ↔ 譬喻概念
   ↓
建立一個安全的 AnalogySpec
   ↓
由本地 renderer 畫成互動世界
而且這個譬喻不能假裝自己就是物理事實。
所以每一個 Analogy World 都必須分清楚:
我不想因為畫面很好懂,就讓使用者最後記到一個錯的物理模型。
我另外做了一份很簡單的歐姆定律測試教材。
裡面只有正式內容:
V = IR
我故意沒有先在教材裡告訴它:
請使用水流比喻。
因為我要測的是系統自己能不能完成這件事情。
理想結果是:
| 正式概念 | 譬喻世界 |
|---|---|
| Voltage V | 推動差 / 壓力差 |
| Current I | 流量 |
| Resistance R | 管路的阻礙 / 窄口 |
而且不只是畫一張圖。
我要可以改 V、改 R,然後讓整個世界跟著動。
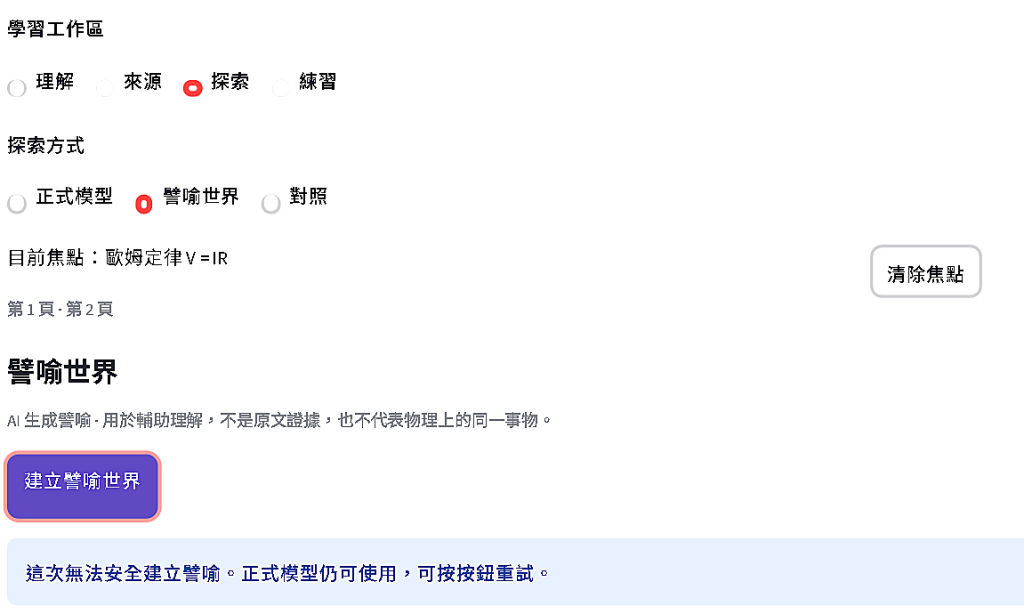
結果第一次按:
「建立譬喻世界」
畫面直接跟我說:
這次無法安全建立譬喻。正式模型仍可使用,可按按鈕重試。
這時候其實有一個很尷尬的地方。
前面的自動化測試是通過的。
但真的拿一份 PDF 丟進去,最經典、理論上最好做的 V = IR 都生不出來。
這讓我發現 Analogy Engine 第一版有一個很大的問題:
我要求 AI 一次把整個世界寫得太完美了。
它不只要想比喻,還要同時產生:
其中只要有一個欄位不符合 Validator,整個世界就直接被丟掉。
Codex 後來追到第一個真正的 rejection reason。
AI 產生了 6 組 formal ↔ analogy mapping,但是其中一些 mapping 本來就合理地會指向同一個 analogy entity。
舊 Validator 卻假設:
一個 mapping 一定要對一個完全不同的譬喻物件。
所以它把一個其實合理的結果當成錯誤。
修完之後,我再測。
還是失敗。
這次 rejection 發生在視覺 primitive 的 radius。
也就是說,整個 Analogy World 的核心其實已經有:
結果只因為一個非核心的視覺欄位不符合預期,整個世界還是直接被丟掉。
這個 bug 反而讓我和 ChatGPT 決定不再一直補:
「這個欄位也允許一下。」
真正應該修的是架構。
新的原則變成:
AI 負責:
這個概念是什麼
適合什麼譬喻
誰對應誰
哪裡會失真

App 負責:
安全 ID
預設大小
安全數值
renderer defaults
expression validation
互動狀態
而且開始把錯誤分成:
Fatal
像錯誤語意、安全問題、危險 expression、錯誤來源連結。
這些真的要拒絕。
以及:
Recoverable
例如一個非必要 animation 壞掉、一個 visual field 沒填好、一個 optional binding 不合法。
這些不應該讓整個 Learning World 死掉。
這次還多做了一個我滿喜歡的功能。
當 AI 已經產生 AnalogySpec,只是被 Validator 擋掉時,系統會把候選保留下來。
修完程式後可以按:
本地重驗已保留的譬喻
它會重新經過新的 normalization / validation。
不用再呼叫一次模型。
這個設計對之後其實很重要。
因為如果每修一個 renderer bug,我都要重新付一次 API,而且每次 AI 又會產生稍微不同的結果,那 debugging 會變得非常痛苦。
修完之後,再拿同一份歐姆定律教材測。
這次 Analogy World 終於真的建立成功。
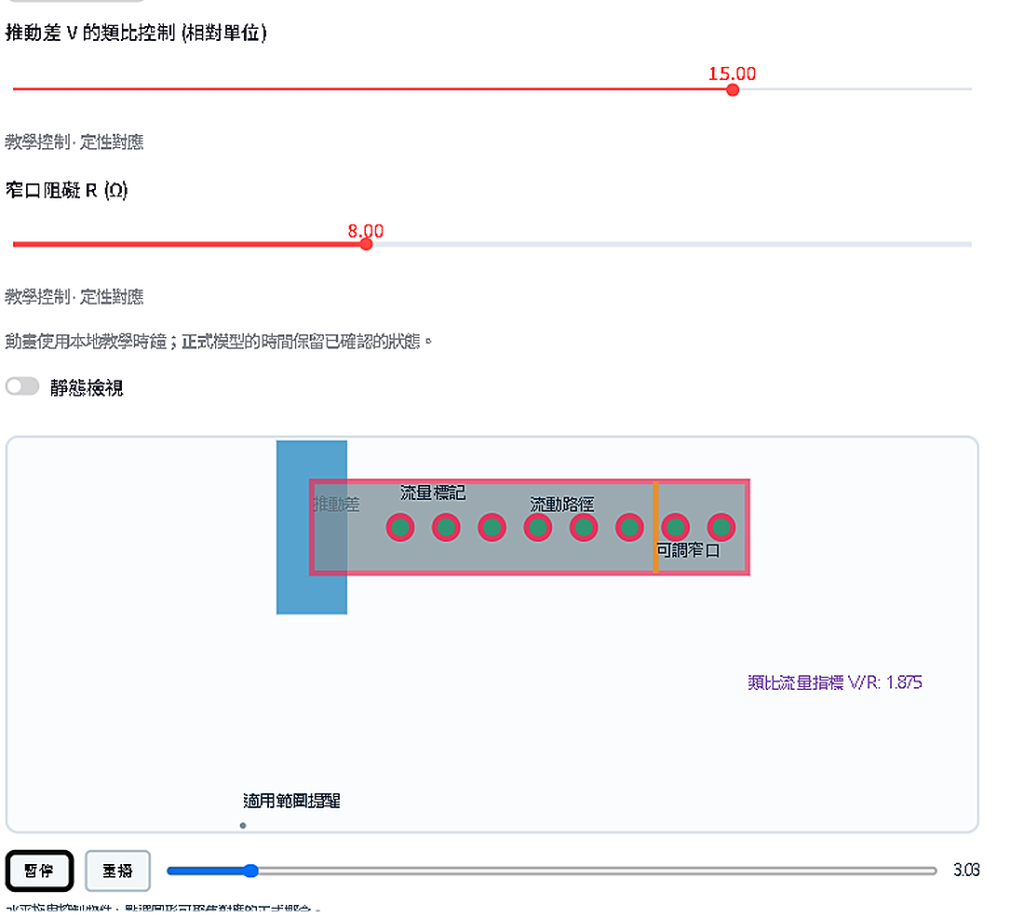
畫面上可以直接調:
中間是一個簡化的水流世界。
當我改變控制項時:
I = V / R 的結果也會一起更新而且這些操作全部是在本地完成。
建立好 Analogy World 後:
滑 slider 不需要再問 AI。
動畫不需要再問 AI。
切換焦點也不需要再問 AI。
AI 只負責把教材編譯成一次結構化的世界。
接下來都是 runtime 自己跑。
一開始看到 Analogy World 下面還有一堆像:
我第一眼其實也有點看不懂這些到底要幹嘛。
後來實際點才發現,它們不是單純把 AI 的 mapping dump 出來。
點某一個對應關係後,模擬世界裡相對應的東西也會被 focus。
也就是 Analogy World 也正式加入前面 Workspace 的那套 semantic focus。
正式模型:Resistance R
          ↕
Analogy mapping
          ↕
譬喻世界:窄口 / 阻礙
同一個概念只是換了一種 representation。
這和前半天 Source → Explore 的設計其實是同一件事情。
前半天:
原始 PDF
↓
semantic focus
↓
Spatial Learning World
後半天:
正式概念
↓
semantic focus
↓
Analogy World
做到這裡我開始比較清楚 Visual Learning Lab 後面應該往哪裡走。
我不想把它做成:
PDF → 一堆固定功能。
也不只是:
PDF → 模擬。
而是:
知識 → 找到最適合它的 representation。
有些東西有方程式和狀態,可以是真的 simulation。
有些東西比較像流程,可以變成 interactive process。
有些東西太抽象,可以用 Analogy World。
有些東西甚至根本不適合硬做成動畫,那就不要亂做。
所以我現在真正想往前推的方向,其實比較像:
輸入一段知識,系統先理解它的結構,再決定怎樣「看」它最合理。
Learning Workspace 第一階段完成時:
26 個 Day 21 focused tests 通過。
後來 Analogy World 加入,再經過真人測試抓到兩次 Validator 問題後,相關測試擴充到:
87 個相關測試通過。
這次我沒有在最後再跑一次完整 regression suite,所以我不會寫成:
所有測試全部通過。
目前能確定的是 Day 21 相關測試通過,而且最重要的兩條真人流程都實際跑過:
Source
→ semantic focus
→ Explore
→ 回 Source
以及:
V = IR
→ 建立 Analogy World
→ 調整 V / R
→ 水流世界本地更新
如果只看功能數量,今天好像只是:
但我覺得真正的進展反而是底下這個:
Source Evidence
      ↕
Semantic Entity
      ↕
Shared State
  ↙    ↓     ↘
來源  正式模型  譬喻世界
      ↕
   Learner Action
前幾天的 Visual Learning Lab 比較像:
AI 幫我產生很多學習素材。
現在我開始希望它變成:
AI 把教材編譯成一個有狀態、可以操作、而且不同 representation 彼此知道對方的學習世界。
當然,今天的水流世界還很粗糙。
它離真正很好看的教育模擬還差很多,也不代表現在什麼教材都能成功生成。
但至少 Day 21 終於證明了一件事情:
AI 產生的譬喻,不一定只能停在文字。
它可以先被結構化,再被驗證,再變成一個可以操作的世界。
而下一個問題也變得很直接:
如果今天歐姆定律可以變成水流世界,那 Queue、Phase、Probability、控制系統,甚至完全不同領域的教材,是不是也可以讓系統自己決定最適合的互動形式?
Day 22,我想正式開始測這件事情。


 iThome鐵人賽
 看影片追技術