

Day 21 做完 Analogy World 之後,我其實有一個很大的疑問。
歐姆定律可以變成水流世界,拋體運動可以變成 Spatial Learning World,機率可以畫集合、機率樹和 Monte Carlo。
但如果最後每多一種教材,我都還是要另外寫:
「這是 Queue,所以畫 Queue。」
「這是 Phase,所以畫旋轉向量。」
「這是 Projectile,所以畫拋物線。」
那 Visual Learning Lab 本質上還是很多 Demo 拼起來而已。
所以 Day 22 我想正面處理一個更大的問題:
系統能不能不是先知道題目名稱,而是看懂一段知識的結構,再自己決定「這個東西最適合怎麼被看見」?
這一天我把這個方向正式叫做:
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
我前幾天一直在講「希望什麼教材都可以變成模擬」。
但真的做到這裡之後,我反而發現這句話不夠精準。
因為很多知識根本不應該硬塞進物理模擬。
像 Queue 描述的是:
First In, First Out
它最重要的是順序和狀態改變,不需要重力、不需要座標,也不需要 3D。
有些知識是方程式和連續變化,適合 simulation。
有些是狀態與流程,適合 interactive process。
有些是集合、拓樸或階層結構,適合 structural visualization。
有些很抽象,譬喻反而最好懂。
甚至有些只是定義,硬加互動反而是在製造噪音。
所以 Day 22 真正的目標變成:
教材 / 概念
     ↓
理解知識結構
     ↓
Representation Planner
     ↓
選擇最適合的 Learning World
     ↓
安全的 Runtime
而不是:
教材
↓
不管三七二十一全部動畫化
這個差異對我來說滿重要的。
Day 20 開始,我已經決定不要看到功能就重造輪子。
所以這次我和 ChatGPT 給 Codex 的要求不是:
幫我做一個 Universal Renderer。
而是先去看現在已經有哪些東西可以重用。
Visual Learning Lab 本來就已經有:
Spatial World、Probability World、Analogy World、Interactive Lab、Plotly、Graphviz 和 Workspace state。
Day 22 最後採用的架構反而很小:
一個語意表示規劃器 + 一組 capability adapter。
也就是 Planner 不負責自己畫所有東西。
它比較像交通警察。
如果教材包含連續數值、時間變化和方程式,就送去既有 dynamic runtime。
如果是空間運動,就送 Spatial World。
如果是集合或機率結構,就重用 Probability runtime。
如果是很適合類比的抽象關係,就送 Analogy World。
只有原本真的缺的一類——「狀態/流程型知識」——才新增一個很小的 Process Runtime。
這次也重新掃了一輪相關 prior art 和開源元件。實作繼續重用 Plotly(MIT)、Graphviz Python(MIT)和 Streamlit(Apache-2.0),流程狀態的設計則參考 XState(MIT)的 guard / transition 思路。
最後沒有增加任何新的 dependency。
我覺得這反而是好事。
因為 Day 22 不是在比「今天新增多少套件」,而是在看:
我們能不能讓現有能力開始被同一個 compiler 調度。
這次我刻意選 Queue 當 acceptance case。
原因是它和前面做的一堆物理東西差很多。
一個 Queue 需要的其實只是:
A → B

enqueue(C)

A → B → C

dequeue()

B → C
所以新的 Process Runtime 只有五種受控操作。
它不是一個 Queue App。
同一套 runtime 還要能表達 FIFO、LIFO,甚至有限狀態流程。
也就是 production code 裡不能寫:
if topic == "queue":
    ...
真正應該判斷的是:
ordered collection
+
insert transition
+
remove transition
+
ordering constraint
Codex 也做了一個很直接的檢查:
把六個測試案例的題目名稱全部換成誤導性的名稱,Representation Planner 的決策仍然相同。
至少目前核心 routing 不是靠 keyword 猜題目。
先跑離線 manual demo。
初始狀態:
A → B
加入 C:
A → B → C
移除第一個:
B → C
Front、Rear、reset 也都正常。
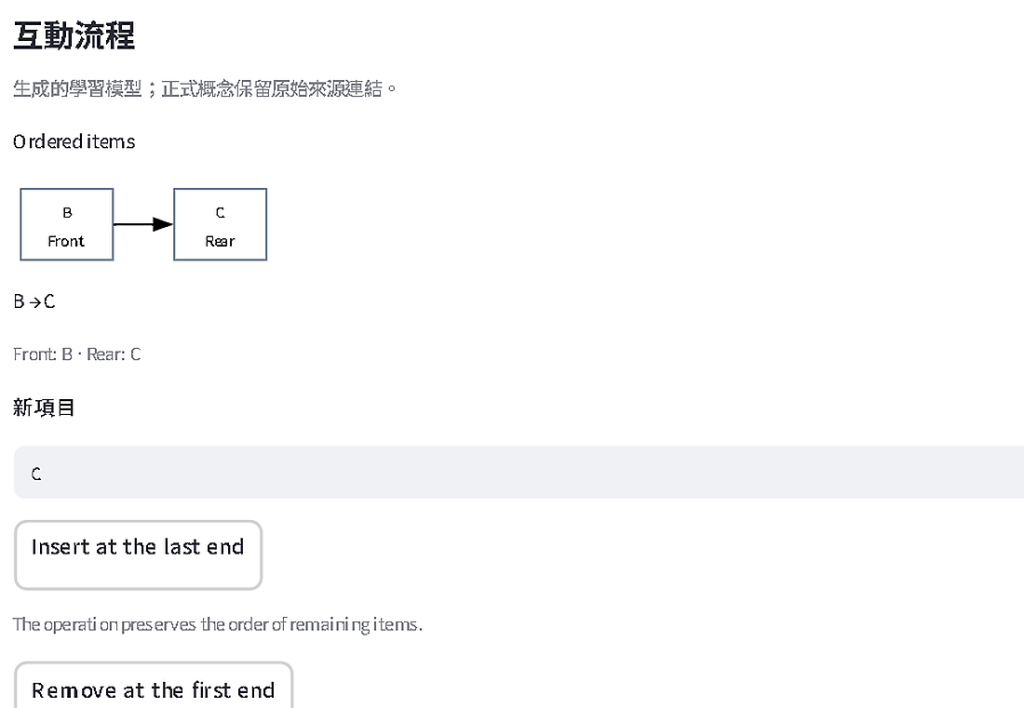
這一步證明:
Process Runtime 本身是真的可以互動。
但這還不夠。
因為這只是我們自己準備好的 fixture。
如果我自己先把 QueueSpec 寫好,再證明 QueueSpec 可以跑,那其實沒有證明 AI 看得懂陌生教材。
完成 architecture 後,我先做了一輪 deterministic benchmark。
| 教材結構 | 系統選擇 |
|---|---|
| 相位/正弦波 | 動態數學世界 |
| FIFO Queue | 通用互動流程 |
| Ohm's Law | 譬喻世界 |
| 拋體運動 | 空間動態世界 |
| 機率 | 集合/機率世界 |
| 純定義型概念 | 不強迫建立互動 |
這裡我覺得最後一列特別重要。
如果系統真的想往「Universal」走,它一定要有能力說:
這個東西沒有必要模擬。
不然所謂 AI 視覺化最後很容易變成什麼東西都硬畫一張看起來很炫的圖。
這六個案例的架構驗證全部符合預期。
但我還是不想就這樣宣布 Day 22 成功。
因為真正重要的是:
把一段普通教材真的丟進正式 App,它會不會自己走到 Process Runtime?
我開正式的 app.py,不是 manual demo。
接著直接貼一段很普通的英文教材:
A queue is a FIFO data structure.

FIFO means First In, First Out.

enqueue(x):
adds x to the rear of the queue.

dequeue():
removes the item at the front.

front:
returns the first item without removing it.

Example:
Start with A, B.
Enqueue C → A, B, C.
Dequeue → B, C.
正常「開始理解」,再進「探索」。
結果它一開始確實看懂這是一個流程。
畫出了:
「從後端加入元素」
↓
「依加入順序排列」
↓
「查看前端元素」
↓
「從前端移除元素」
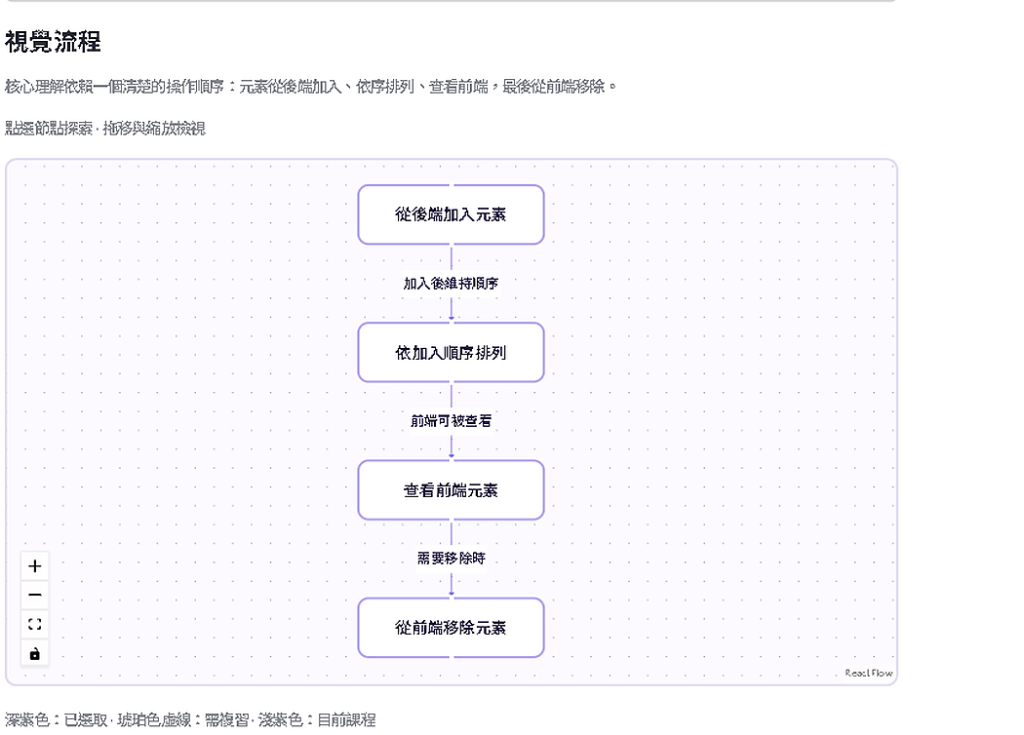
這張圖其實不算錯。
問題是,這是原本就有的 Visual Flow。
它可以告訴你流程,但不能真的 enqueue、dequeue。
所以我再按:
「選擇適合的學習表示」
結果直接變成:
目前無法安全建立此表示。既有學習功能仍可使用,可明確重試。
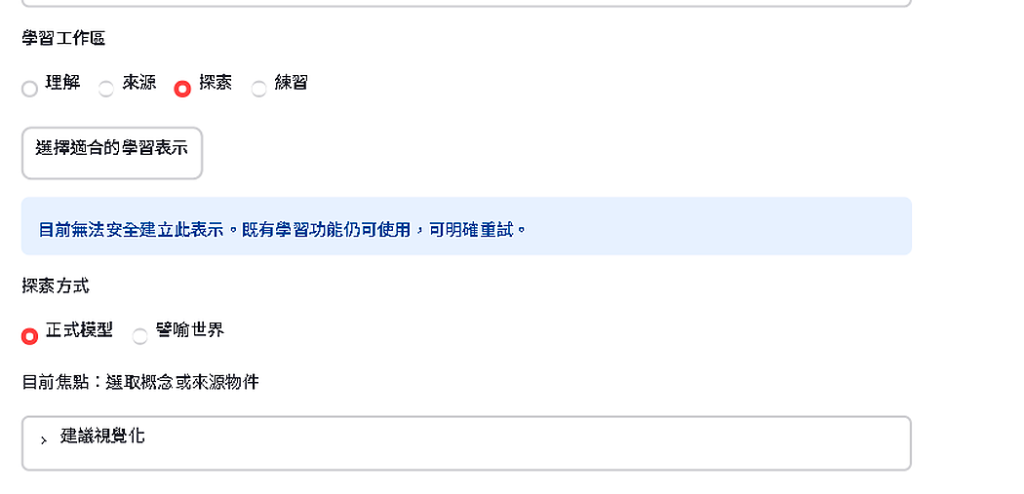
這時候 Day 22 的狀態其實很清楚:
Generic Runtime        PASS
Offline Architecture   PASS
Deterministic Benchmark PASS

Real Material
→ AI Planner
→ Compiler
→ Runtime              FAIL
這個失敗比測試全綠更重要。
我讓 Codex 不要再做新功能,直接把 manual fixture 和 production generated spec 拿來比。
最後確認到 normalize_process 有一個 contract bug。
舊 Validator 不允許:
Process ID 和 Formal Concept ID 使用相同 identity。
但在真實生成裡,這其實完全可能是一個合法狀況。
而 manual demo 之所以一路正常,是因為它剛好刻意用了不同的 Process ID 和 Concept ID。
也就是:
測試 fixture 剛好閃過了真實世界會遇到的情況。
這個問題和 Day 21 Analogy World 的 bug 很像。
我們又再次撞到:
AI 被要求填太多低階 runtime 細節。
所以這次修法沒有變成:
Queue 的 ID 特別放行。
而是改成:
由可信任的 application code 衍生安全 Process ID。
另外也讓程式自己補上安全 display defaults、丟棄不重要但不合法的 optional annotation,並保存失敗候選和受控 diagnostics。
模型負責「這個流程代表什麼」。
程式負責「這個東西如何安全執行」。
這個分工我現在越來越確定是對的。
這裡還有一個很重要的小細節。
第一次真人失敗的原始 candidate 當時沒有被保存。
所以雖然我們後來確定找到了一個真的存在、而且會錯誤拒絕合法 ProcessSpec 的 identity bug,我不能反過來說:
「第一次失敗百分之百就是它造成的。」
這件事情沒有證據。
所以後面的 diagnostics 和 candidate preservation 也是這次修正的一部分。
之後如果又出現類似問題,就不會只剩一句:
「無法安全建立此表示。」
而是可以保留 sanitized candidate,在不重新花 API 的情況下重驗 compiler。
修完之後,我重新走一次真正的 production path。
不是 fixture。
不是 manual_day22.py。
就是正式 App、正式文字輸入、正式分析、正式 Representation Planner。
這次成功進入 Interactive Process Runtime。
我可以自己輸入新的元素、enqueue、dequeue、reset。
例如輸入新項目後,Queue 真的會變:
A → B → C
dequeue:
B → C
Front=B。
Rear=C。
Reset 又回到:
A → B
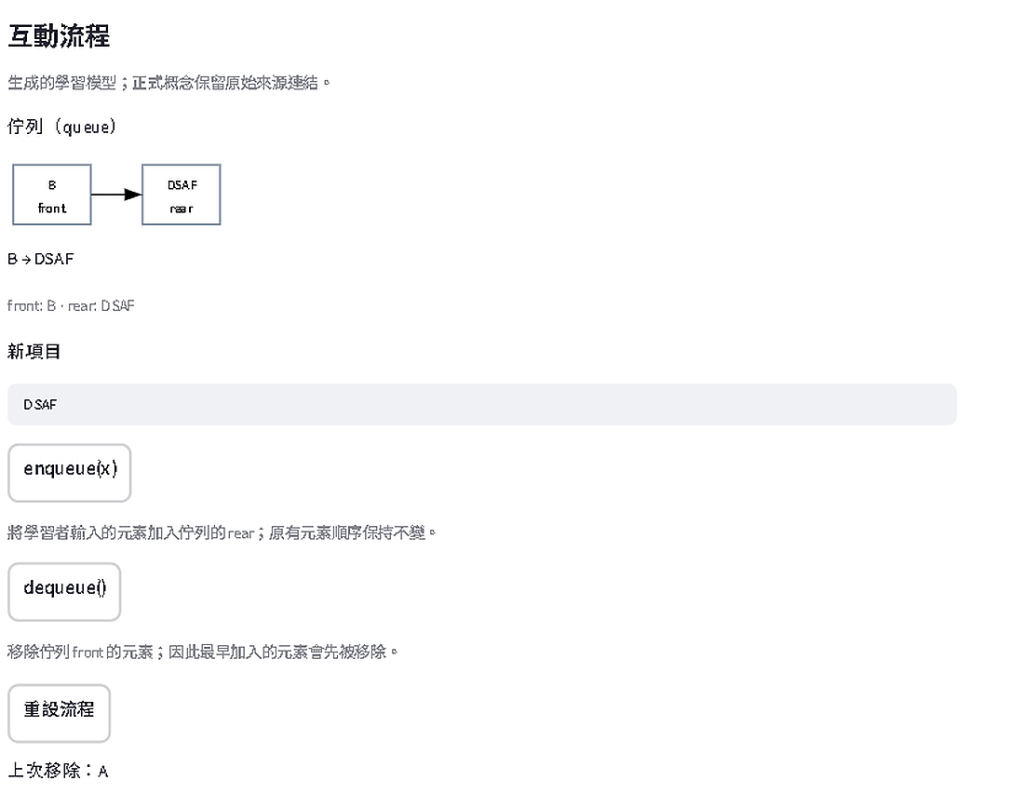
更重要的是:
正常生成過程只用了:
一次教材分析 + 一次 representation planning。
也就是兩次模型請求。
世界建立好之後:
enqueue、dequeue、reset、focus、Workspace navigation 全部都是:
0 額外 AI 呼叫。
這就是我一直想做的 runtime model:
AI 編譯一次
↓
本地一直玩
而不是:
每按一次按鈕
↓
再問一次 AI
Day 22 第一階段 architecture 完成時:
211 個 focused regression 通過。
完整 regression:
331 passed。
後來真人 Queue 測試抓到 production contract bug,修正後另外跑:
35 個 targeted focused tests 全部通過。
最後再跑一次完整 regression:
339 passed。
這次也有特別涵蓋:
FIFO、LIFO、formal focus、本地 transition,以及 production Queue 的 contract regression。
而且沒有新增 dependency,也沒有為 Queue 寫 topic-name routing。
當然還沒有。
目前我們真正證明的只是:
同一個架構,已經可以把幾種差異很大的知識送到不同 Learning World。
而且 Queue 是目前很重要的一個證據。
因為它第一次真的離開了:
「數學/物理模擬」。
目前大概變成:
Projectile
→ Spatial World

Phase
→ Dynamic Mathematical World

Probability
→ Structural / Probabilistic World

Ohm's Law
→ Analogy World

FIFO Queue
→ Interactive Process World

Definition-only concept
→ 不強迫互動
這開始比較像 compiler。
但還不能說:
什麼教材丟進去都可以。
因為目前真正的 production 真人測試仍然很少。
最大的未知已經從:
「我們能不能做出這些 runtime?」
變成:
「碰到沒看過的教材時,Planner 到底有多常選對?選對之後 Compiler 又有多常接得住?」
這兩個問題其實完全不同。
如果 Planner 選錯,那要修的是 semantic reasoning。
如果 Planner 選對,但 compiler 爆掉,那要修 runtime contract。
如果都成功了,但畫出來根本不好懂,那又是第三種問題。
所以 Day 23 我不想直接再加新功能。
我想開始拿一批真的陌生教材去攻擊它。
先凍結題目。
第一次跑不能偷偷改答案。
再把失敗拆成:
表示選錯
編譯失敗
Runtime 不夠
Grounding 失敗
安全拒絕
UX 把正確結果藏起來
然後再決定下一步到底該補哪裡。
做到 Day 22,我第一次覺得 Visual Learning Lab 開始不像:
「AI 幫我做很多不同的視覺化功能。」
而比較像:
「AI 先理解知識的結構,再把它編譯成適合這個知識的學習世界。」
這條路還很長。
但至少今天,Queue 不再是一張 Queue Demo。
它是第一個證明:
同一個 compiler,可以開始走出物理世界。


 iThome鐵人賽
 看影片追技術