
昨天結尾留了一個問題:推論算出「已超過退貨期限」,但客人問的根本不是能不能退貨,W3 拿著這個不相關的推論回了一封答非所問的信。
那封信的毛病,程式檢查抓不到——字數沒超過、沒有禁用詞、每個數字都有來源。要抓它得先理解客人在問什麼。所以今天做驗收:程式檢查一層、另一個模型檢查一層,不過就退件重寫。
做完之後我拿同一批信跑了有驗收和沒驗收兩個版本。結果是沒驗收的那版比較好。
整體結構如下圖,兩層檢查的分界是「這件事能不能寫成規則」。
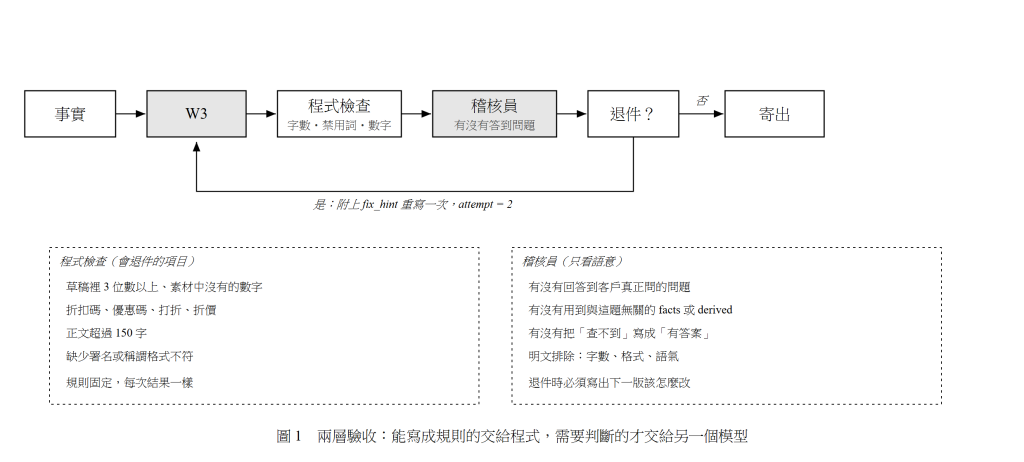
第一層是程式。這部分 Day 13 就做好了,W3 的合規檢查節點會算草稿字數、比對禁用詞、檢查署名和稱謂、抓出沒有來源的數字、找折扣字眼。
但不是每一項違規都該退件。語氣提醒(例如用了「盡快」這種接近禁用詞的字)記下來就好,真正要擋的是會造成實際損害的:
const HARD = /無來源數字|折扣字眼|超過字數|缺少署名|稱謂格式/;
const hardViolations = codeViolations.filter((v) => HARD.test(v));
第二層是另一個 Agent,我叫它稽核員。它的 prompt 最重要的部分是寫清楚「你不檢查什麼」:
## 你只檢查這三件事
1. 有沒有回答到客戶真正問的問題。
   客戶問 A,草稿回答 B,即使 B 的內容完全正確,也算沒回答到。
2. 有沒有使用與這個問題無關的資料。
   facts 與 derived 裡的東西不一定都該用。
   例如客戶問的是「能不能把退貨改成換貨」,那「退貨期限還剩幾天」就不是這題的重點。
3. 有沒有把「查不到」寫成「有答案」,或反過來。

## 你不檢查這些
字數、禁用詞、署名格式、有沒有附來源,這些由程式檢查,不是你的工作。
語氣好不好也不是你的工作。
不寫這段的話,稽核員會開始評論語氣、建議換個說法、嫌結尾太制式,然後每一封都退件。把程式已經在做的事明文排除掉,它才會專心在語意上。
還有一條例外要寫進去,否則整套會垮:
草稿說「我這邊幫您確認後,最晚 24 小時內回覆您」是合法的處理方式,
當資料裡確實沒有答案時,這就是正確的做法,不要因此 reject。
沒有這句,稽核員會把所有「查不到所以會再確認」的信全部退件,因為它們看起來都像沒回答問題。
Review Guard 這個 Code 節點把兩層的結果合起來,產生一個 retry 布林值和一段 fix_hint,後面接一個 Switch。
退件那條線重新呼叫 W3,這次 attempt 填 2,並把退件原因和修改建議一起傳進去。W3 的 prompt 本來就處理過這種情況:
這是第 2 次撰寫。上一版被退件的原因:…
修改建議:…
只退一次。第二版再被退就直接走人工,不要無限迴圈——這條在這批測試裡沒有觸發,但要先寫好。
做 smoke test 的時候,我拿昨天那封「我申請了退貨,想改成換貨」去試,稽核員的判斷是:
reject:草稿使用了與目前訂單狀態矛盾的資料。訂單 A10297 已處於「退貨處理中」,
但草稿卻引用退貨限制與期限來告知客戶無法退貨。

fix_hint:請移除關於「超過 7 天退貨期限」與「已開封不接受退貨」的拒絕理由,
因為訂單狀態已顯示為退貨處理中,不應在已受理的情況下告知客戶無法退貨。
抓得非常準,重寫之後的草稿也乾淨了。我當下覺得這篇穩了。
不過同一次 smoke test 裡,程式層也報了一個違規:「無來源數字:10297」。那是訂單編號,而這正是 Day 13 修掉的 bug——合規檢查只比對 facts 的 value,沒有比對 source 和客人的問題。
我那天寫了 v2 版的檢查程式,但主線用的 W3 從 Day 13 到現在一直是 v1。整整八天,我在 Day 18 還特別註明過「三個版本的 W3 都是 v1」,然後就忘了。
所以今天先把主線的 W3 換成 v2:prompt 和合規檢查一起換。換完再跑正式實驗。
同樣 8 封退貨信,兩個版本的差別只有「有沒有接稽核員和退件迴圈」,W3 都是 v2。
| 沒有驗收 | 有驗收 | |
|---|---|---|
| 完整通過 | 8/8 | 7/8 |
| 退件次數 | 不適用 | 1 |
| tokens 中位數 | 9329 | 10571 |
| 延遲 p50 | 7.5 秒 | 10.0 秒 |
| 延遲 p95 | 9.8 秒 | 21.5 秒 |
加了驗收之後,分數從 8/8 掉到 7/8,token 多 13%,延遲中位數多三分之一,p95 翻了一倍。
被退件的是這封:
A10308 的冷萃咖啡包我還沒拆,想退可以嗎?
這張單到貨 4 天、商品未開封,FAQ 寫得很清楚:未開封且外包裝完整的咖啡豆,可在到貨 7 天內申請退貨。第一版草稿照這條回答,是對的。
稽核員的理由是:
草稿將「冷萃咖啡包」直接套用在「咖啡豆」的退貨條件上,
但資料中並未明確說明咖啡包與咖啡豆共用同一項退貨規定。
嚴格說起來這個質疑不算錯,FAQ 條目的標題確實寫「咖啡豆的退貨限制」,沒有明文涵蓋咖啡包。但重寫之後的草稿變成這樣:
關於您詢問訂單 A10308 的冷萃咖啡包是否可退貨,我這邊幫您確認後,最晚 24 小時內回覆您。
本來查得到的答案,變成要再等 24 小時。對客人來說這是明顯的退步,而且後面還得有一個真人來處理一件本來不需要人處理的事。
八封信,程式檢查一次都沒有觸發,稽核員只退件一次,而那一次是誤判。
我不覺得這代表驗收沒有價值,但它讓我看清楚一件事:驗收這一層的價值,完全取決於它檢查的東西有多容易出錯。
W3 升級成 v2 之後,這 8 封信本來就全對。一個本來就不會錯的東西,再加一層會誤判的檢查,結果只能更差——這是算術問題,不是設計問題。稽核員只要有一點點誤判率,分數就會從 8/8 往下掉。
而在升級之前,同一個稽核員確實抓到了 Day 20 那封答非所問的信。所以正確的順序是:先把上游修到不太會錯,再看剩下的錯誤有沒有共同模式,有的話才針對那個模式加檢查。
我的做法剛好相反。我是先看到一個錯誤案例,然後蓋了一層通用的檢查去攔它,結果上游一修好,這層檢查就只剩下誤判的功能。
整理一下我現在的判斷。
程式那一層要留著,而且成本幾乎是零。它檢查的都是確定的規則:字數、禁用詞、署名、折扣字眼、沒有來源的數字。這些規則不會誤判,也不會隨著上游變好而失去意義——哪天改了 prompt 導致 W3 開始寫長信,它馬上就會擋下來。這一層的角色跟 Day 15 那 53 題沒有鑑別度的考題一樣,是防止退步。
LLM 那一層就要看情況。它適合的場景是:上游的錯誤率確實不低、錯誤的型態說不清楚(寫不成規則)、而且錯誤的代價大於多等一輪的代價。客訴信、退款承諾、金額相關的回信符合這些條件,一般的查單回信不符合。
所以我接下來的做法是:程式檢查對所有信都跑,稽核員只對 needs_human 為真的信跑。那些信本來就要給人看過,多一層機器檢查不會讓情況更糟,而且能幫人先篩掉明顯的問題。
至於誤判的成本,當它只套用在本來就要人審的信上時就降下來了——稽核員退件退錯了,人還是會看到。
驗收分兩層:程式檢查規則、另一個模型檢查語意。稽核員的 prompt 要明文寫出「你不檢查什麼」,並且要允許「我幫您確認後回覆」這種合法的處理方式。退件時把原因和修改建議傳回 W3,attempt 填 2,只退一次。
8 封退貨信實測,有驗收的版本 7/8、沒驗收的 8/8,唯一一次退件是誤判,把一封答對的信改成了要再等 24 小時。結論不是驗收沒用,而是它的價值取決於上游的錯誤率——先修上游,再決定要不要加這一層,以及加在哪些信上。
另外補了一筆八天前的債:主線的 W3 從 Day 13 之後一直沒換成修好的 v2,今天才發現。
明天談 context 交接:主管該傳多少資料給專員,傳整封信和傳摘要差在哪裡。


 iThome鐵人賽
 看影片追技術