
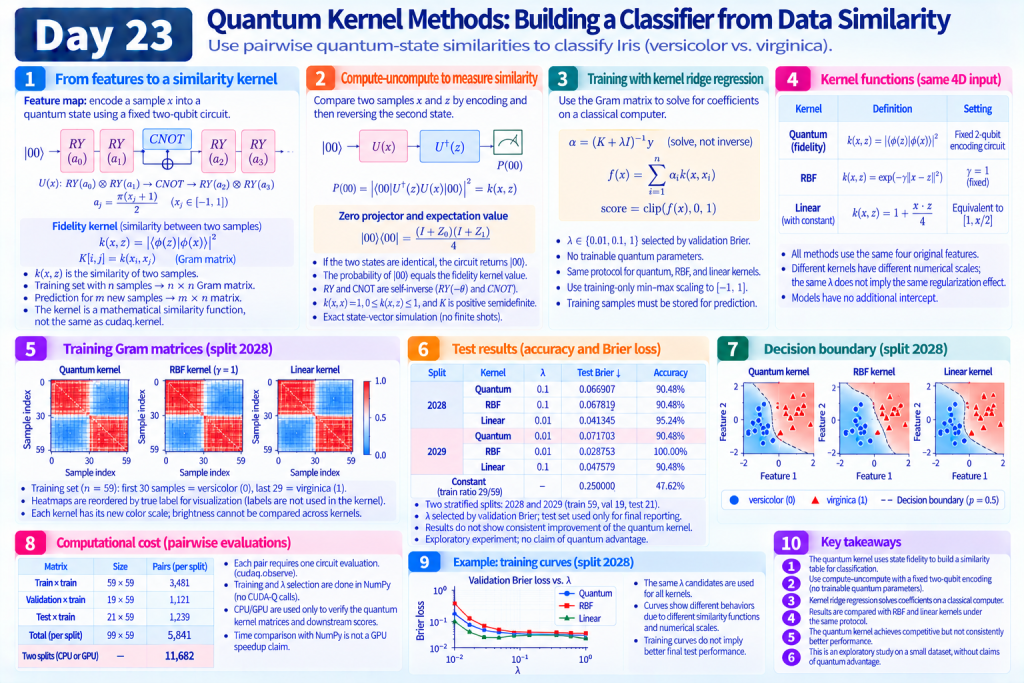
Day22 改變資料進入電路的排程。今天固定編碼電路,改問另一件事:若兩筆資料各自變成量子狀態,它們有多像?能不能用這張相似度表做分類?
想像交友軟體用「共同興趣」推薦朋友:不必先學一套複雜的打分旋鈕,只要先算出每對人之間有多相似,再讓一般演算法依這張表做決定。量子核方法也類似——電路負責把資料變成狀態,相似度由狀態重疊決定,預測係數則在一般電腦上求解。
程式:kernels.py、experiment.py、demo.py、plot_results.py、test_kernels.py。實測見 結果報告。沿用 .venv,無需新增套件或下載資料。
Day23 builds a classifier from pairwise quantum-state similarities on a fixed two-qubit Iris encoding. A fidelity kernel forms Gram matrices for kernel ridge regression with validation-only λ selection; RBF and linear kernels share the same protocol. NumPy solves coefficients, then CUDA-Q CPU/GPU verifies quantum matrices without claiming quantum advantage.
特徵是描述一筆資料的數值,例如花瓣長度。**特徵映射(feature map)**把這些數值轉成另一種表示;這裡用電路 U(x),把初始狀態 |00⟩ 轉成資料 x 的量子狀態 |φ(x)⟩。
本章使用保真度核(fidelity kernel):以兩個狀態內積的絕對值平方衡量相似度。內積可以想成振幅重疊;振幅絕對值平方才是量測機率。
k(x,z) = |⟨φ(z)|φ(x)⟩|²
K[i,j] = k(x_i, x_j)
k(x,z) 是兩筆資料的相似度;訓練有 n 筆時,Gram 矩陣(格拉姆矩陣)就是 n×n 的相似度表。對 m 筆新資料則建 m×n 表:每一列是一筆查詢,每一欄對應一筆保存的訓練樣本,欄位順序必須一致。預測仍需要訓練樣本,不能只存少量電路權重。
此處的「核函數」是數學上的相似度函數,與 CUDA-Q 標記量子程式的 @cudaq.kernel 不是同一件事。Havlíček 等人展示以量子特徵空間估計核來分類的方法。[P5] 本章是自行設定的小型電路加核嶺迴歸(kernel ridge regression,KRR),並非原論文電路或支援向量機(SVM)的完整重現。
兩個量子位元分段接收四個特徵,固定執行:
U(x): RY(a0)⊗RY(a1) → CNOT(q0→q1) → RY(a2)⊗RY(a3)
a_j = π(x_j+1)/2
RY 以指定角度旋轉單一量子位元;⊗ 表示兩位元各自操作。CNOT 是受控反相閘:計算基底下 q0 為 1 時翻轉 q1。縮放後特徵 x_j ∈ [−1, 1],故角度 a_j ∈ [0, π]。所有角度由資料決定,沒有需要訓練的量子參數。
比較 x 與 z 時,先執行 U(x),再執行 U(z)†。符號 † 在此表示電路的反向操作。這個流程叫 compute–uncompute:先編碼,再試用另一筆資料的電路撤銷編碼。
|00> → U(x) → U(z)† → P(00)
P(00) = |⟨00|U(z)†U(x)|00⟩|² = k(x,z)
若兩筆資料準備出相同狀態,反向會回到 |00⟩;一般情況下,回到全零的機率就是核值。反向電路必須倒轉閘順序,並把每個閘換成反向:RY 角度取負,CNOT 再做一次即可撤銷。kernels.py 明確列出步驟。
全零投影可理解為只對 00 記 1、其餘記 0;其期望值(依機率加權的平均)就是 P(00):
|00⟩⟨00| = (I+Z0)(I+Z1)/4
I 是單位操作;Z0、Z1 對該位元的 0/1 結果分別記 +1/−1。本章以 cudaq.observe(..., shots_count=-1) 直接從模擬狀態算期望值,不用有限次量測抽樣。一次 observe 不代表真實硬體只需量測一次。
原始比較電路有 8 個 RY 與 2 個 CNOT;編譯器可能合併相鄰旋轉。此處沒有量測量子處理器(QPU)延遲,也未換算硬體原生閘成本。
NumPy 參考路徑分別準備兩個狀態,再以 abs(vdot(state_z,state_x))**2 算相似度——與反向電路是不同計算路徑,供 CUDA-Q 核對。CPU/GPU 都用來模擬電路。
正規化狀態的量測機率總和為 1,因此本章核滿足 k(x,x)=1、k(x,z)=k(z,x),數值介於 0 與 1。
更關鍵的是半正定(positive semidefinite,PSD):對任意實數權重向量 c,cᵀKc ≥ 0。光是每一格非負還不夠。把狀態寫成密度矩陣 ρ(x)=|φ(x)⟩⟨φ(x)|:
k(x,z) = Tr[ρ(x)ρ(z)]
cᵀKc = ||Σ_i c_i ρ(x_i)||²_F ≥ 0
Tr 是對角線元素總和;‖·‖_F² 是各元素絕對值平方總和,因此不會為負。精確計算的 Gram 矩陣因此是半正定。
半正定允許某些非零 c 得到 0;正定則要求非零 c 一定為正。重複或極相似的表示可能讓矩陣奇異(無法直接求逆)。測試檢查密度矩陣內積、對稱性、對角線與最小特徵值;浮點誤差可能產生極小負值,報告保留原始結果,沒有把負值改成 0 來「修正」矩陣。
若所有狀態末端都加上相同、與資料無關的酉操作 V,重疊不變:V†V=I,共同末端操作會在比較時抵消。只在尾端加固定糾纏閘,不會自動改變核;本章 CNOT 放在兩段資料旋轉之間,後面仍有依資料變化的操作。
所有方法接收相同四個原始特徵。各欄位只用訓練資料的最小/最大值縮放到 [−1, 1],越界截斷。不用標籤建縮放規則,也不用 PCA。
| 核函數 | 定義 | 設定 |
|---|---|---|
| 量子核 | 狀態內積絕對值平方 | 固定兩位元編碼電路 |
| RBF(徑向基底函數) | exp(−γ‖x−z‖²) | 預先固定 γ=1 |
| 線性核加常數 | 1+x·z/4 | 等價於特徵 [1, x/2] |
RBF 依直線距離算相似度,距離越遠越接近 0;γ 控制下降速度。線性核用內積 x·z;額外常數特徵讓輸出能整體平移,但該係數同樣受正則化限制,不是不受限的截距。
核嶺迴歸用相似度表求每筆訓練樣本的係數 alpha,再加權組合成預測。[D20] 正則化在貼近訓練標籤之外,加入限制函數大小的懲罰;λ 控制懲罰強度。不同核的數值尺度不同,相同 λ 不代表相同限制效果。
alpha = np.linalg.solve(K_train + lam * np.eye(n), y_train)
raw_score = K_query_train @ alpha
score = np.clip(raw_score, 0, 1)
predicted_class = score >= 0.5
solve 直接解線性方程組,不先求反矩陣。每個 λ 共用同一張 K,不必重跑量子電路。
目標是 sum_i(f(x_i)−y_i)² + λ‖f‖²:前半是未除以 n 的平方誤差總和;後半是再生核希爾伯特空間(RKHS)中的函數範數懲罰。模型沒有額外截距。
原始分數可能超出 [0, 1],因此同時保存原始值與截斷值;以 0.5 為門檻算準確率與 Brier 分數(輸出與 0/1 標籤的平均平方誤差)。截斷不保證校準機率;求解器也不是直接最小化截斷後 Brier。
測試另比較線性模型的原始形式(primal)與對偶形式(dual),並檢查同步重排訓練樣本與係數後預測是否一致。
沿用 Day20 的 Iris 二分類:去重後 99 筆;種子 2028/2029 兩組切分,各訓練 59、驗證 19、測試 21。資料列編號、縮放規則與來源 SHA-256 皆保存。
各模型只比較 λ∈{0.01,0.1,1},依驗證截斷後 Brier 選 λ,平手取較小 λ,最後才對測試評分。無隨機初始化權重;2 切分 × 3 核 × 3 λ=18 次傳統 KRR 求解。
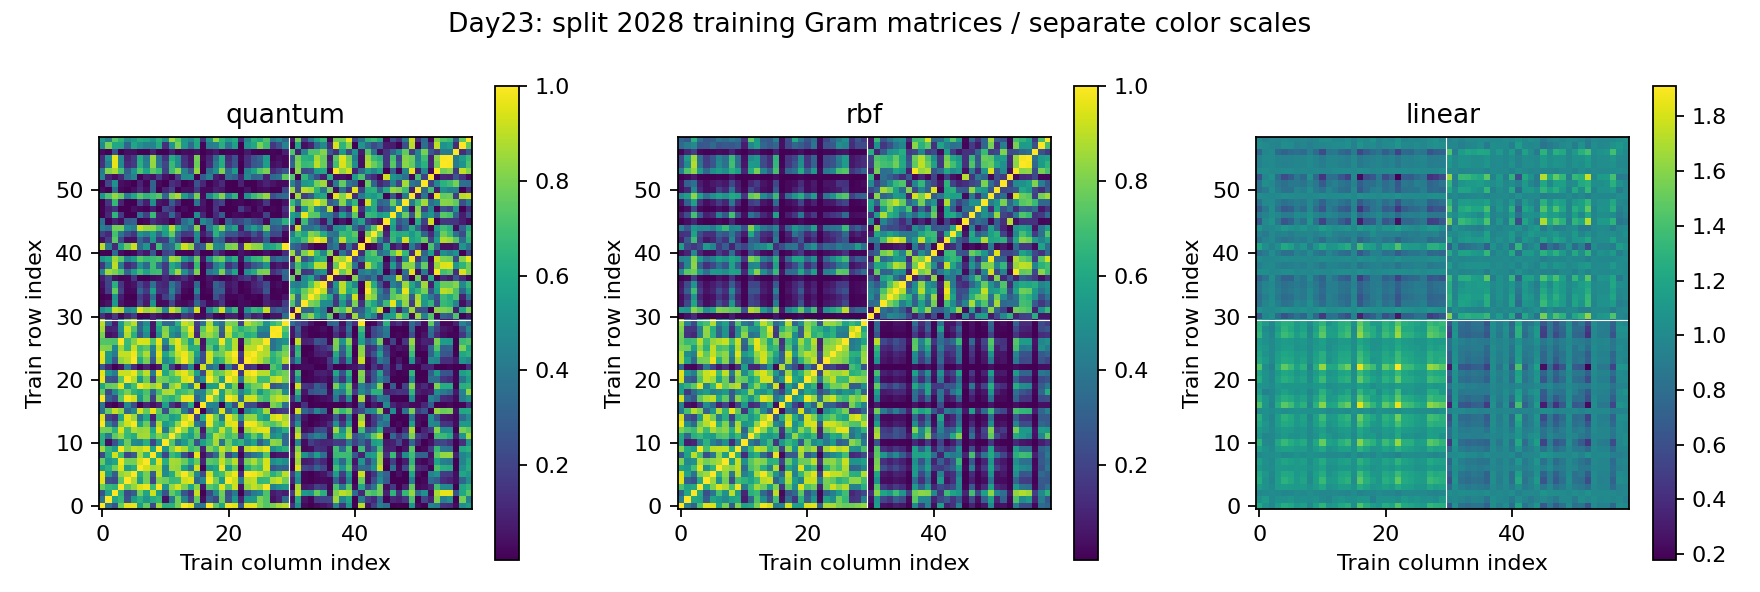
熱圖按原有類別分組顯示(前 30 筆類別 0、後 29 筆類別 1);標籤不參與核計算。各圖色階獨立,不能以亮度直接比較不同核的「品質」。
選定測試結果(完整表見 結果報告):
| 切分 | 核 | λ | 測試 Brier | 準確率 |
|---|---|---|---|---|
| 2028 | quantum | 0.1 | 0.066907 | 90.48% |
| 2028 | rbf | 0.1 | 0.067819 | 90.48% |
| 2028 | linear | 0.01 | 0.041345 | 95.24% |
| 2029 | quantum | 0.01 | 0.071703 | 90.48% |
| 2029 | rbf | 0.01 | 0.028753 | 100.00% |
| 2029 | linear | 0.1 | 0.047579 | 90.48% |
訓練先驗基準 p=29/59:兩切分測試準確率皆 47.62%、Brier 約 0.250。量子核兩次測試準確率都是 90.48%,本次並未一致勝過 RBF/線性核。
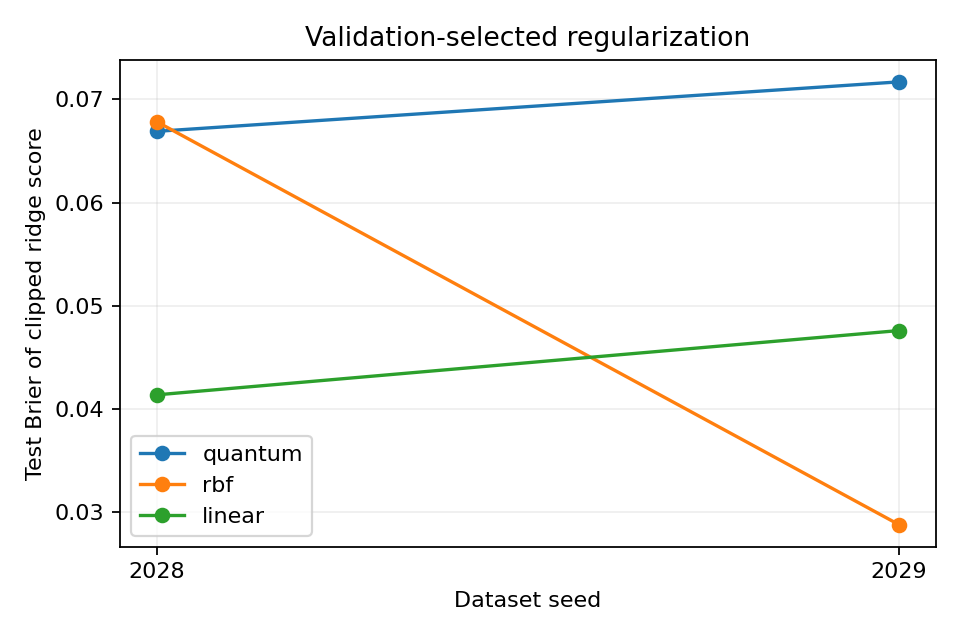
兩組切分互相重疊,且測試資料已在 Day20 公開,屬探索性實驗。RBF 的 γ 固定、λ 只有三個候選——不是充分調參後的排行榜。與 Day22 的 73 次目標函數評估預算不同,不能直接跨章比速度或準確率。
先以 NumPy 建矩陣、選 λ、求 alpha;訓練過程沒有呼叫 CUDA-Q。再由 CPU/GPU 模擬器重建全部量子核矩陣元素,用固定 alpha 核對分數。
每組切分的配對次數:
| 矩陣 | 大小 | 配對次數 |
|---|---|---|
| 訓練 × 訓練 | 59×59 | 3,481 |
| 驗證 × 訓練 | 19×59 | 1,121 |
| 測試 × 訓練 | 21×59 | 1,239 |
| 合計 | 99×59 | 5,841 |
每個後端兩組切分共 11,682 次 observe(含對角線與對稱位置的重複計算以便核對)。每筆新資料仍需與 59 筆訓練樣本比較。
完整保存矩陣需 O(n²) 空間;直接求解通常 O(n³);m 筆新資料需 O(mn) 配對。n 加倍時,矩陣空間約四倍、直接求解主要計算量約八倍。
NumPy 可先存狀態再用矩陣乘法比較,工作量與逐對反向電路不同,不能把兩邊計時相除宣稱 GPU 加速。兩個量子位元可由一般電腦有效模擬,沒有計算優勢結論。
GPU 使用 fp32;核誤差可能經 alpha 放大,故分別要求矩陣誤差小於 1e-5、截斷分數誤差小於 1e-4。實測:CPU 最大核誤差約 8.9e-16、分數誤差約 5.5e-14;GPU 約 3.6e-07/1.5e-05,皆通過。完整矩陣以 NPZ 保存;沒有用 GPU 結果重訓或重選 λ。
模擬未加硬體噪聲,也未用有限 shots。若改以有限次量測估相似度,抽樣誤差可能破壞半正定性;相關修正尚未納入。
沿用 requirements-day23.txt,不需 scikit-learn。OMP_NUM_THREADS=1 將 CPU 執行緒數設為 1。示範四個輸入依序為花萼長/寬、花瓣長/寬(公分)。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day23/experiment.py train
OMP_NUM_THREADS=1 python articles/day23/experiment.py verify
OMP_NUM_THREADS=1 python articles/day23/experiment.py verify --backend nvidia
OMP_NUM_THREADS=1 python articles/day23/plot_results.py

OMP_NUM_THREADS=1 python articles/day23/demo.py --features 6.0 2.9 4.5 1.5
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day23 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY23_TARGET=nvidia python -m unittest discover -s articles/day23 -p 'test_*.py' -v
示範可加 --split-seed 2029 或 --backend nvidia,載入保存的訓練樣本順序、縮放規則與 alpha,不需重訓。預設 CPU 可獨立跑訓練、驗證、示範與測試;完整報告需要 CPU 與 GPU 驗證摘要。
輸出在 results/day23/,重跑覆寫同名檔案;重訓後需再跑 verify 與繪圖。報告核對設定、資料與選定模型的內容摘要。已保存的 GPU 紀錄結束時仍有 cudaErrorCudartUnloading;數值驗證與測試退出碼為 0,該結束錯誤根因尚未定位。
本章驗證了:固定兩位元特徵映射上的保真度核、Gram 矩陣對稱/近 PSD 性質、驗證集選 λ 的 KRR 流程,以及 CPU/GPU 對量子核矩陣與下游截斷分數的一致性。未宣稱量子優勢、充分超參數搜尋、SVM 重現、QPU 結果,或有限 shots 下的核估計。
Day24 回到可訓練電路,觀察梯度是否可能小到難以使用——也就是 Barren Plateau(貧瘠高原)相關的診斷。
完整索引見 REFERENCES.md。
[N7] Jan Schnabel and Marco Roth. “Quantum kernel methods under scrutiny: a benchmarking study.” Quantum Machine Intelligence 7, 58 (2025);研究論文。原始來源;完整書目。
本章實作量子核;這篇基準研究可直接銜接核的選擇、資料編碼與選參數流程,避免只以單一設定判定方法優劣。


 iThome鐵人賽
 看影片追技術