
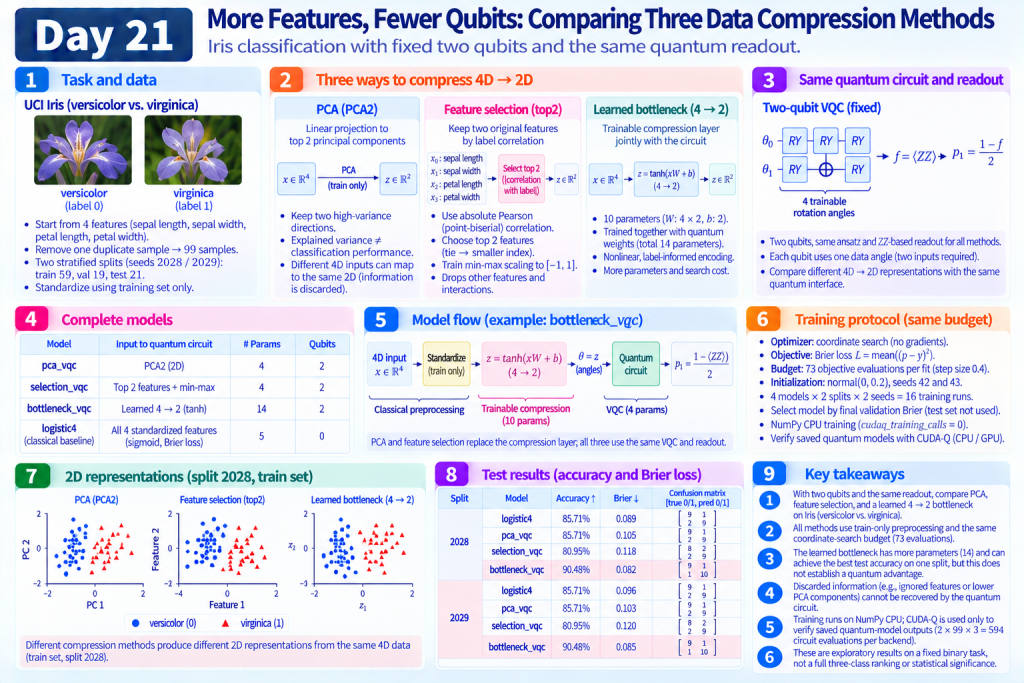
Day 20 把 Iris 四維壓成兩個主成分再分類。今天把「為什麼壓成兩維、怎麼壓」拆開看:固定兩個量子位元與同一套量子讀出,只換四維→二維的表示方法。
想像行李箱只能裝兩格,手邊卻有四樣東西。你可以:把四樣混成兩包(PCA)、只帶看起來最有用的兩樣(特徵選擇)、或做一個可調的打包機跟後面的分類器一起學(可訓練壓縮層)。打包方式不同,路上能用的資訊也不同;丟掉的東西,後面再接量子電路也救不回來。
程式:reduction.py、experiment.py、demo.py、plot_results.py。沿用 Day 20 切分與 .venv;訓練在 NumPy CPU,CUDA-Q 核對保存模型。
Day21 keeps two qubits and ZZ-based readout fixed while comparing PCA, label-ranked feature selection, and a learned 4→2 bottleneck for Iris binary classification, plus a four-feature logistic baseline. Train-only rules, shared coordinate-search budgets, and CUDA-Q verification apply; discarded information is not recovered by the quantum circuit.
本日角度編碼每位元一個資料角度 → 一次準備要兩個數。這是此電路介面,不是「兩位元永遠只能用兩特徵」的定律。
| 方案 | 怎麼處理四維 | 代價 |
|---|---|---|
| PCA2 | 線性組成兩個高變異方向 | 高變異 ≠ 一定有助分類 |
| 特徵選擇 | 保留兩個原始欄位 | 好解釋;丟欄位與交互作用 |
| 可訓練壓縮層 | 4→2 與電路一起依損失更新 | 參數與搜尋變多 |
| (對照)加位元/振幅/分段 | 見 Day13/22 | 本日實測前三種+經典基準 |
versicolor/virginica、去重後 99 筆;切分種子 2028/2029(59/19/21)。所有方法先用訓練平均/標準差標準化。PCA、排序、min-max 都只在訓練集擬合;驗證選種子、測試最後評分。[D14]
測試集已在 Day 20 公開,本日是系列內探索實驗,不是新的盲測。
PCA2:重用 Day 20 SVD/符號/範圍縮放。解釋變異是變動占比,不是分類能力。程式會沿被捨棄方向擾動輸入,確認不同四維可撞成相同主成分。
特徵選擇:各欄與二元標籤的絕對 Pearson(point-biserial)分數,取前兩欄(平手取較小索引),再 train min-max 到 [-1,1]。不看測試挑欄;未算 p 值。[D19]
可訓練壓縮層:
raw4 → 標準化 → tanh(zW+b) → 角度編碼 → Ansatz → ZZ → p1=(1−ZZ)/2
編碼 10 參數+量子 4=14。三個量子方案共用同一 p1 讀出,不接 Day 19 sigmoid 頭。
| 模型 | 輸入 | 參數 | 位元 |
|---|---|---|---|
| pca_vqc | PCA2 | 4 | 2 |
| selection_vqc | top2+minmax | 4 | 2 |
| bottleneck_vqc | 4→tanh2 | 14 | 2 |
| logistic4 | 完整四維標準化→sigmoid | 5 | 0 |
logistic4 補上「經典模型可看完整四維」的對照;仍用 Brier,不是標準交叉熵邏輯斯求解器。
2 切分 × 4 模型 × 種子 42/43=16 次擬合;各 73 次目標函數 × 59 筆。參數多不會自動多預算。細節與圖見 實驗報告。
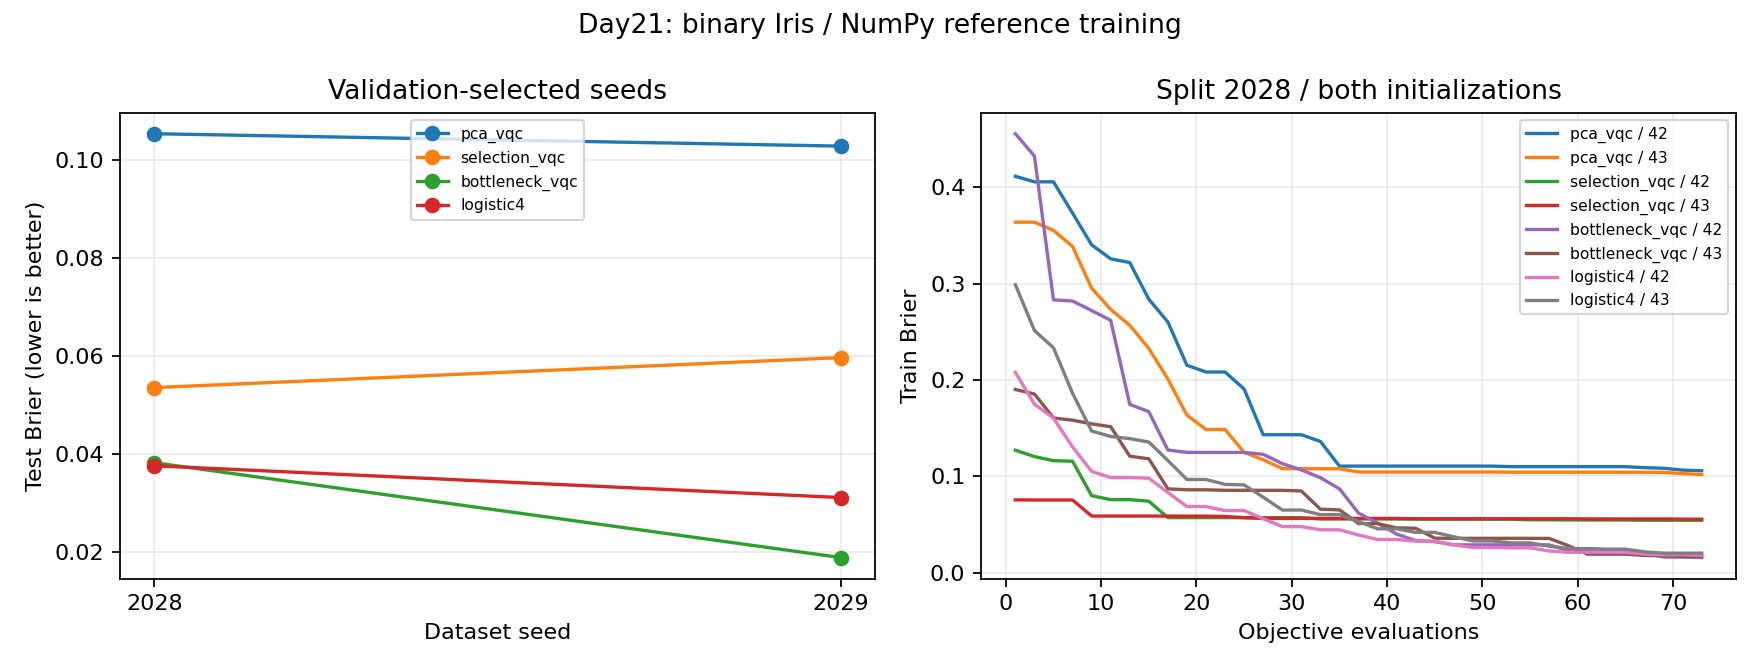
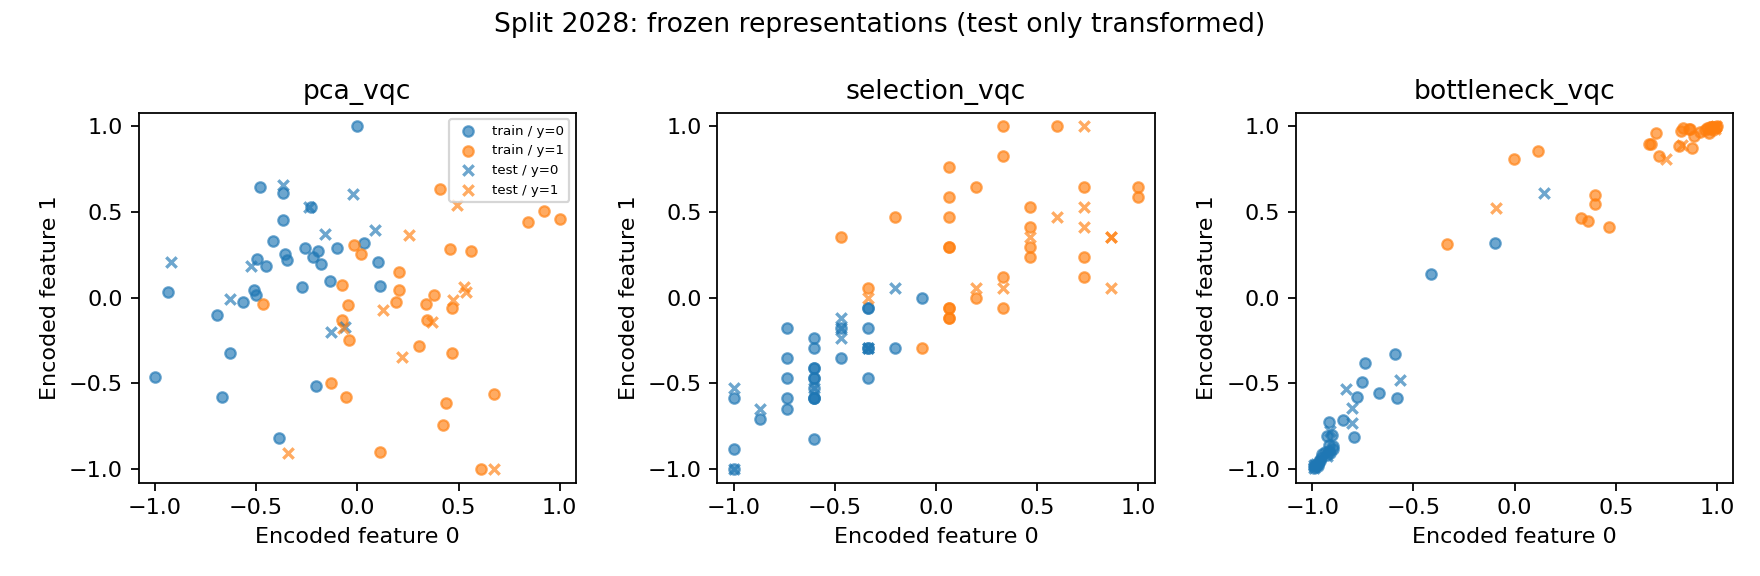
不要只比準確率;壓縮層變好也不等於量子優勢——它多了用標籤訓練的編碼層。完整消融對照本日未做。
cudaq_training_calls=0。選定後每後端核對三個量子模型:2×99×3=594 次 observe。驗證時間可能含編譯/快取,不能與訓練秒數相除當 GPU 加速。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day21/experiment.py train
OMP_NUM_THREADS=1 python articles/day21/experiment.py verify
OMP_NUM_THREADS=1 python articles/day21/experiment.py verify --backend nvidia
OMP_NUM_THREADS=1 python articles/day21/plot_results.py
OMP_NUM_THREADS=1 python articles/day21/demo.py --features 6.0 2.9 4.5 1.5
輸出在 results/day21/。測試涵蓋 train-only 邊界、排序/PCA 相容、丟失方向碰撞、CUDA-Q 對齊。
下一篇 Day 22 實作資料重複編碼。
NumPy 實作、未裝 scikit-learn。索引:REFERENCES.md。
[N6] Kevin W. Aoun et al. “Quantum State Preparation via Neural Network Encoding in Quantum Machine Learning.” arXiv:2605.31006v1 (2026);預印本。原始來源;完整書目。
本章處理特徵與降維;該研究提供可學習編碼的比較方向。壓縮後是否保留任務資訊,仍須在相同切分下評估。

 iThome鐵人賽
 看影片追技術
看更多

