
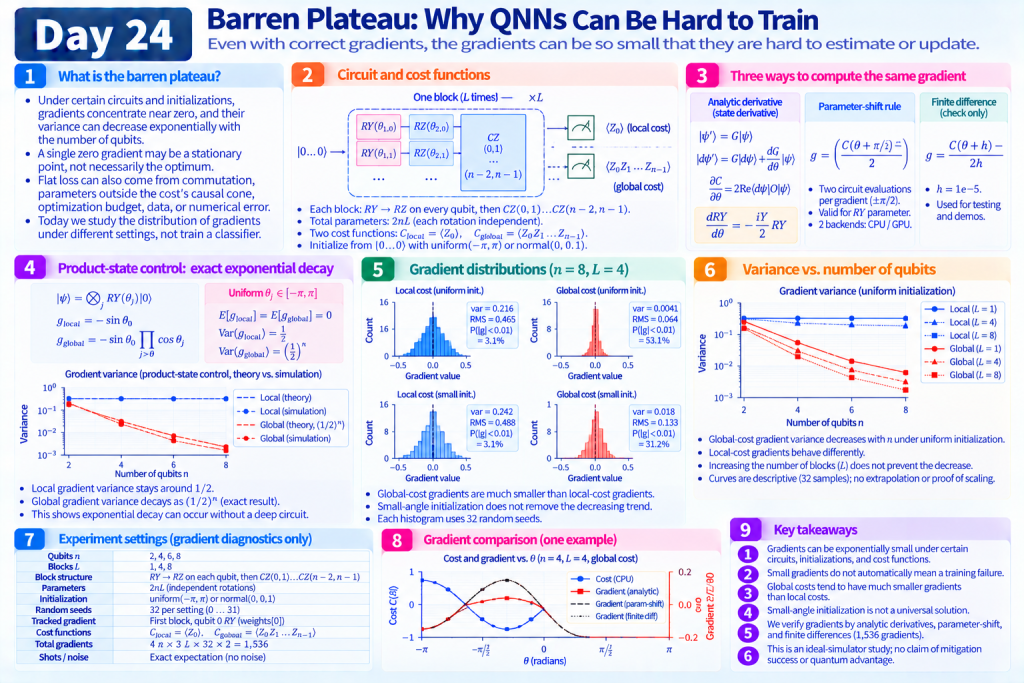
Day23 固定編碼、用狀態相似度建模型。今天回到需要更新電路權重的量子神經網路(QNN),問另一件事:梯度就算算對了,會不會還是小到難以估計或更新?
想像在一片幾乎完全平坦的高原上找下山路:指南針(梯度)幾乎總是指向「沒有方向」。這不是地圖畫錯,而是地形本身太平。Barren Plateau(貧瘠高原)研究關注的,正是在特定電路與初始化分布下,梯度集中在零附近、變異數還可能隨量子位元數指數縮小的現象。
Day17 確認梯度怎麼算;本章比較量子位元數、電路區塊數、目標涵蓋範圍與初始化,不執行分類器訓練。
程式:landscape.py、experiment.py、demo.py、plot_results.py、test_landscape.py。實測見 結果報告。沿用 .venv,使用既有套件。
Day24 diagnoses whether correctly computed QNN gradients can still be too small to use: one tracked RY parameter across qubit counts, block depths, local vs global Z costs, and two initializations. Matrix derivatives and parameter-shift cross-check 1,536 gradients; a product-state control shows exact exponential variance decay for the global cost. This ideal-simulator study does not claim mitigation success or QPU results.
Barren Plateau 文獻關注:在指定電路與初始化分布下,梯度集中於零附近,且梯度變異數可隨量子位元數呈指數下降。McClean 等人的結果與隨機電路及 2-design 性質有關,並非宣稱所有 QNN 都無法訓練。[P6]
單次梯度為 0,可能只是落在駐點(當下的一階變化率為零);駐點不一定是最佳解。其他原因包括:參數控制的操作與量測量對易(交換順序結果不變)、參數不在目標的因果範圍、程式漏接參數,或微小差值估計造成數值誤差。損失停滯也可能來自最佳化器、預算、資料或損失設計。因此本日固定參數位置,在多個初始化上看分布,而不是挑一條平坦訓練曲線就下結論。
初始化分布描述訓練開始前權重如何隨機抽出;變異數衡量相對平均值的分散程度。指數下降例如每加一個量子位元就乘上 1/2,比每次減固定值更快接近零。
2-design 是一種隨機性條件:對涉及至多二階矩的統計量,平均表現與理想均勻隨機酉操作一致。不能只憑電路「看起來隨機」就認定成立。
| 項目 | 本日設定 |
|---|---|
| 量子位元數 n | 2、4、6、8 |
| 區塊數 L | 1、4、8 |
| 每個區塊 | 每位元依序 RY→RZ,再 CZ(0,1)…CZ(n−2,n−1) |
| 量子參數 | 2nL,每個旋轉獨立 |
| 初始狀態 | 全部從零態開始 |
| 初始化 | 均勻(−π,π);常態(0, 0.1) |
| 隨機種子 | 每組 0…31,共 32 個樣本 |
| 梯度座標 | 第一區塊、第 0 位元的 RY,weights[0] |
| 局部目標 | C_local=⟨Z0⟩ |
| 全域目標 | C_global=⟨Z0 Z1 … Z(n−1)⟩ |
| Shots/噪聲 | 直接算期望值,無噪聲 |
RY/RZ 分別繞 Y/Z 軸旋轉;CZ 是受控相位閘,只對兩位元皆為 1 的分量改正負號。區塊是固定順序的一組操作,重複 L 次。
Z 量測將 0 記 +1、1 記 −1。局部目標只取第 0 位元平均;全域目標先把各位元記分相乘再平均。⟨·⟩ 表示期望值。
四種 n × 三種 L × 兩種初始化 × 32 種子=768 個電路初始化;每個算兩種目標的同一個梯度=1,536 個梯度數值。沒有 Iris、準確率或訓練/測試切分——本章只診斷目標如何隨參數改變。
L 是區塊數,不是編譯後電路深度。每區塊有 2n 個單位元閘、n−1 個 CZ;狀態向量有 2^n 個複數振幅。GPU 記憶體在 n≤8 並非瓶頸,也不做加速結論。
兩個目標都在 [−1, 1],避免把任意尺度差異當成梯度消失;但它們是不同任務。換成局部目標可能改變問題本身,不保證原本的解仍正確。[P7] 本章並非該論文局部 2-design 模板的完整重現。
NumPy 參考同時更新量子狀態與導數狀態(參數微幅改變時狀態如何變化)。G 是當前閘,θ 是所選參數,O 是量測量:
|ψ'> = G|ψ>
|dψ'> = G|dψ> + (dG/dθ)|ψ>  # 第二項只在 weights[0] 對應的 gate 加入
∂C/∂θ = 2 Re⟨dψ|O|ψ⟩
dRY/dθ = (-iY/2) RY
NumPy 以張量軸套用單位元閘,不建大型 2^n×2^n 矩陣。陣列排序把第 0 位元放在最高位;CUDA-Q 直接用 spin.z(0) 指定量測量,避免把後端內部位元順序當成相同陣列排序。
參數位移法把同一個角度加減 π/2,再由兩次目標值之差算導數:
g = [C(θ0+π/2) − C(θ0−π/2)] / 2
此規則適用於本日獨立 RY 參數。每個梯度兩次 observe,兩後端各 3,072 次;保存兩個位移後期望值,不只存相減結果。測試與示範另以中央有限差分(h=1e-5)核對。實測最大絕對誤差:CPU 約 1.9e-15、GPU 約 8.7e-07,皆通過。
乘積態表示每位元可各自描述、沒有糾纏。考慮 ⊗_j RY(θ_j)|0⟩,θ_j 獨立均勻於 [−π, π]:
C_local = cos θ0
C_global = ∏_j cos θ_j

g_local = −sin θ0
g_global = −sin θ0 × ∏_(j>0) cos θ_j
由 E[sin θ]=0、E[sin² θ]=E[cos² θ]=1/2,可直接推導:
E[g_local] = E[g_global] = 0
Var(g_local) = 1/2
Var(g_global) = (1/2)^n
這是對指定分布與目標的精確結論,不是用四個資料點擬合所得。一般電腦就能展示:全域目標的梯度變異數呈指數縮小。
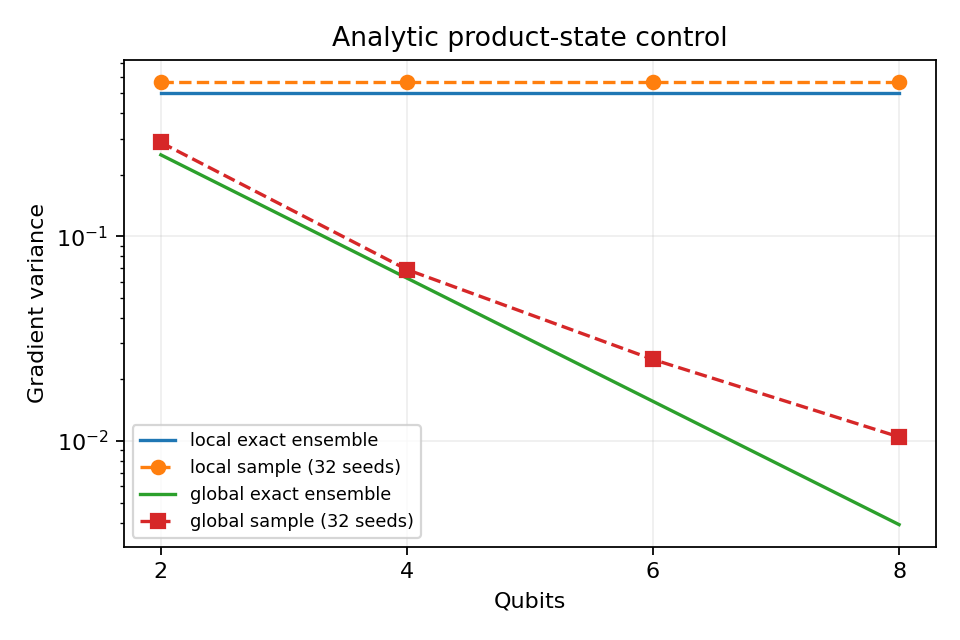
主實驗單一區塊的 RZ 與 CZ 都對 Z 讀出對易,因此對兩種目標也有相同解析形式。CZ 可能改變糾纏,但此時不改變這些期望值——不要把單一區塊的下降歸因於「電路很深」。測試會直接核對單一區塊解析式。
對照的 32 樣本另用長度 n 的均勻向量;主實驗用長度 2nL、交錯 RY/RZ 的向量,故相同種子並非逐筆相同角度。分布上的理論比較仍成立。
對固定(n、L、初始化、目標)的 32 個梯度,報告平均值、樣本變異數(ddof=1)、RMS、絕對值中位數,以及 |g|<0.01 的比例。0.01 只是描述性門檻,不是 Barren Plateau 判定標準。
ddof=1 表示離均差平方和除以 31。RMS(均方根)先平方再平均再開根,避免正負抵消。
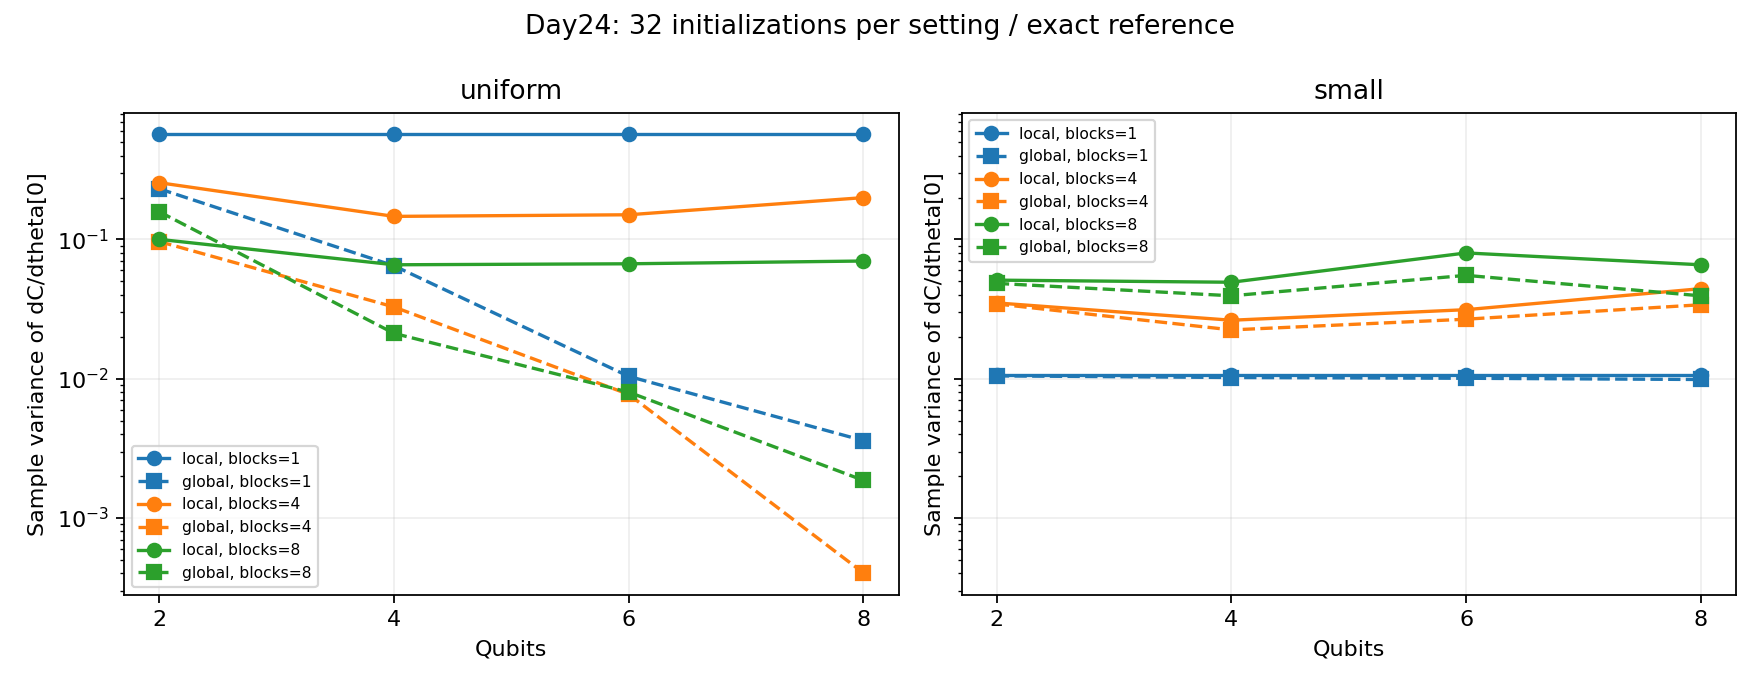
本次均勻初始化下,全域目標的梯度變異數隨 n 下降(例如 L=1 時,n=2→8 的樣本變異數約從 0.23 降到 0.0036);局部目標反應不同。小角度組沒有呈現相同下降趨勢,但不能據此宣稱「可擴展訓練已解決」。
每組僅 32 樣本、最多 8 位元;沒有估信賴區間或做規模擬合。曲線連線只幫助閱讀,不表示證明單調或指數關係。不同設定重用種子,曲線可能相關。固定索引 0 的參數不代表完整梯度向量,也不代表所有參數。
完整數值見 結果報告。
本章 small 是常態(0, 0.1),不是由互為反向區塊構成的恆等初始化。即使所有旋轉為 0,CZ 仍是非恆等酉操作,只是對初始全零態沒有作用。
在全零權重,兩種目標皆為 1 且梯度=0;測試明確驗證此駐點。若要最小化本日目標,這也不是想要的最小值。因此「把權重設小」可能避開某些隨機分布的集中,也可能落在駐點附近——不能只看變異數較小就說更容易訓練。
排查可依序核對:參數是否影響輸出、參數位移與參考是否一致、目標尺度與涵蓋範圍、跨初始化分布、n/L 依賴,最後再比較最佳化器與初始化的訓練結果。本日只完成前述梯度診斷。
本章從模擬狀態直接算期望值。若改成每個位移各執行 S 次獨立量測(每次結果 ±1),參數位移估計的變異數為:
Var(g_hat) = [(1−C_plus²)+(1−C_minus²)] / (4S) ≤ 1/(2S)
這是在 ±1 量測與兩組獨立 shots 假設下的推導,不是本日實測。典型抽樣誤差按 1/√S 縮小;梯度很小時,可能需要更多 shots 才能把訊號與波動分開。增加最佳化器迭代次數本身不會改善單次梯度估計解析度。
GPU fp32 與 CPU fp64 有浮點差異,驗證用絕對誤差容許值 1e-5;接近 0 的梯度不用相對誤差(除以近零會放大比例)。本日沒有噪聲引起的貧瘠高原實驗,不能把浮點誤差叫做量子噪聲。
沿用 requirements-day24.txt,不新增套件:
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day24/experiment.py run
OMP_NUM_THREADS=1 python articles/day24/experiment.py verify
OMP_NUM_THREADS=1 python articles/day24/experiment.py verify --backend nvidia
OMP_NUM_THREADS=1 python articles/day24/plot_results.py

OMP_NUM_THREADS=1 python articles/day24/demo.py --qubits 4 --depth 4 --initialization uniform
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day24 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY24_TARGET=nvidia python -m unittest discover -s articles/day24 -p 'test_*.py' -v
示範可加 --seed、--backend nvidia,比較導數狀態法、參數位移與有限差分。CPU 可獨立跑實驗、驗證、示範與測試;完整圖表需兩後端驗證摘要。
輸出在 results/day24/,重跑覆寫同名檔案。SHA-256 核對設定與樣本,避免引用舊後端摘要。已保存 GPU 紀錄結束時有 cudaErrorCudartUnloading,驗證與測試退出碼為 0;根因尚未定位。
本章驗證了:三條路徑下單參數梯度一致、均勻初始化時全域目標變異數隨 n 縮小的現象、乘積態對照的精確 (1/2)^n 公式,以及小角度/全零駐點的行為。未宣稱此 CZ 電路滿足論文全部假設、未證明漸近指數律、未驗證改善策略的分類成效,也未做 QPU 或噪聲實驗。
Day25 進入第二個真實資料集 Wine,把表示、模型與成本的限制帶回分類任務。
[N8] Martín Larocca et al. “Barren plateaus in variational quantum computing.” Nature Reviews Physics 7, 174–189 (2025);綜述論文。原始來源;完整書目。
本章量測梯度隨設定改變的情形;這篇綜述可延伸辨認不同成因。單一小型實驗中的小梯度,仍不足以證明隨規模增長的貧瘠高原。


 iThome鐵人賽
 看影片追技術