
昨天的 Dashboard 能一眼看出 Todo App 的狀況,但前提是有人打開來看。今天要把昨天的查詢寫成告警規則,出問題時自動通知到 Discord。
Prometheus(定期評估告警規則)
      │  條件成立,且持續一段時間
      ▼
Alertmanager(分組、去重、決定通知誰)
      │
      ▼
Discord / Slack / Email
Prometheus 只負責判斷「有沒有問題」,通知交給 Alertmanager。分開的好處是同一個問題觸發很多次時,Alertmanager 會合併成一則通知,不會洗版。
kube-prometheus-stack 兩個都裝好了,還內建上百條 K8s 的告警規則。
| 狀態 | 意思 |
|---|---|
| Inactive | 條件不成立 |
| Pending | 條件成立,但還沒持續到 for 設定的時間 |
| Firing | 持續成立超過 for,送到 Alertmanager |
for 用來過濾短暫的波動。記憶體突然衝高 10 秒就恢復,不值得通知;持續 5 分鐘才是真的有問題。
今天目標:寫三條 Todo App 的告警規則,讓 Alertmanager 通知到 Discord,並實際觸發一次告警。
轉發 Prometheus 到本機 9090,終端機保持開著:
kubectl port-forward svc/monitoring-kube-prometheus-prometheus -n monitoring 9090:9090
打開 http://localhost:9090,上方選單 Alerts,會看到內建的告警規則和它們目前的狀態。
有一條 Watchdog 永遠是 Firing,這是故意的。它像心跳一樣持續送出,用來確認整條告警流程是通的。
minikube 上可能看到
KubeControllerManagerDown、KubeSchedulerDown等告警是 Firing。這是因為 minikube 的這些元件只監聽本機,Prometheus 拉不到資料,不代表叢集有問題。Step5 會設定讓它們不要送到 Discord。
kube-prometheus-stack 用 PrometheusRule 這個 CRD 管理告警規則,跟 Deployment 一樣寫成 YAML、用 kubectl apply 套用。
在 monitoring/ 建立 todo-app-alerts.yaml:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: todo-app-alerts
  namespace: monitoring
  labels:
    release: monitoring
spec:
  groups:
    - name: todo-app
      rules:
        - alert: TodoApiDown
          expr: |
            sum by (namespace) (kube_deployment_status_replicas_available{namespace=~"dev|staging", deployment=~".*-api"}) == 0
          for: 1m
          labels:
            severity: critical
            service: todo-app
          annotations:
            summary: "{{ $labels.namespace }} 的 API 沒有可用的 Pod"

        - alert: TodoApiHighMemory
          expr: |
            sum by (namespace, pod) (container_memory_working_set_bytes{namespace=~"dev|staging", container="api"})
            /
            sum by (namespace, pod) (kube_pod_container_resource_limits{namespace=~"dev|staging", container="api", resource="memory"})
            > 0.8
          for: 5m
          labels:
            severity: warning
            service: todo-app
          annotations:
            summary: "{{ $labels.pod }} 記憶體使用率 {{ $value | humanizePercentage }}"

        - alert: TodoPodRestarting
          expr: |
            sum by (namespace, pod) (increase(kube_pod_container_status_restarts_total{namespace=~"dev|staging"}[15m])) > 2
          for: 0m
          labels:
            severity: warning
            service: todo-app
          annotations:
            summary: "{{ $labels.pod }} 過去 15 分鐘重啟超過 2 次"
三條規則分別對應昨天的 Panel 3、Panel 2、Panel 4,重點說明:
release: monitoring:Prometheus 只會載入帶有這個 label 的 PrometheusRule,值是 Day 27 的 Release 名稱。少了它規則不會生效,而且不會有任何錯誤訊息。expr:就是昨天的 PromQL 加上比較條件。查詢有結果,代表條件成立。namespace=~"dev|staging":告警規則不能用 Grafana 變數,改用正規表示式同時監控兩個環境。sum by 保留 namespace,通知才知道是哪個環境出事。labels:severity 標示嚴重程度;service: todo-app 等一下讓 Alertmanager 挑出要送到 Discord 的告警。annotations:通知的內容。{{ $labels.xxx }} 帶入 label 的值,{{ $value }} 帶入查詢結果。for: 0m:重啟次數本身就是 15 分鐘的累積結果,不需要再等。套用:
kubectl apply -f todo-app-alerts.yaml
回到 Prometheus 的 Alerts 頁面,等一兩分鐘後重新整理,會出現 todo-app 群組,三條規則都是 Inactive。
一直沒出現的話,先檢查
release: monitoring這個 label 有沒有寫對。
在 Discord 選一個頻道,點齒輪 編輯頻道 → 整合 → Webhook → 新 Webhook,再按 複製 Webhook 網址。
Webhook 網址等同密碼,拿到的人都能發訊息到這個頻道,不要 commit 進 Git。
用 Slack 的話,改成 Slack 的 Incoming Webhook 和
slack_configs,設定方式類似。
Alertmanager 的設定透過 kube-prometheus-stack 的 values 傳入。在 monitoring/ 建立 alertmanager-values.yaml:
alertmanager:
  config:
    route:
      receiver: "null"
      group_by: ["alertname", "namespace"]
      group_wait: 30s
      group_interval: 5m
      repeat_interval: 4h
      routes:
        - receiver: discord
          matchers:
            - service = "todo-app"
    receivers:
      - name: "null"
      - name: discord
        discord_configs:
          - webhook_url: "<你的 Webhook 網址>"
route:決定告警送到哪裡。預設送到 null(不通知),只有 service="todo-app" 的告警送到 Discord,Step1 那些 minikube 的假警報就不會吵到你。group_by:同一條告警、同一個 namespace 的會合併成一則通知。group_wait:第一次觸發時先等 30 秒,把同時發生的告警收集起來一起送。repeat_interval:問題一直沒解決的話,每 4 小時再提醒一次。這個檔案有 Webhook 網址,把它加進 repo 根目錄的 .gitignore:
monitoring/alertmanager-values.yaml
先查出目前的 chart 版本:
helm list -n monitoring
CHART 欄位的 kube-prometheus-stack- 後面就是版本號,例如 91.8.2。在 monitoring/ 執行升級,版本號換成你查到的:
helm upgrade monitoring prometheus-community/kube-prometheus-stack -n monitoring --version 91.8.2 --reuse-values -f alertmanager-values.yaml
--version:一定要加。沒指定的話,helm upgrade 會順便把 chart 升到最新版,可能帶來預期外的變動。--reuse-values:沿用安裝時的設定,只套上這次的 alertmanager.config。確認設定有載入,轉發 Alertmanager 到本機 9093:
kubectl port-forward svc/monitoring-kube-prometheus-alertmanager -n monitoring 9093:9093
打開 http://localhost:9093,Status 頁面的 Config 看到 discord 就代表成功了。
設定有錯的話不會套用,Config 還是舊的。看 operator 的 log 找原因:
kubectl logs -n monitoring deploy/monitoring-kube-prometheus-operator --tail=20
把 dev 的 API 縮到 0 個,模擬 API 掛掉:
kubectl scale deployment todo-dev-api -n dev --replicas=0
用 dev 是因為 staging 有 HPA 維持最少 2 個 Pod,加上 ArgoCD 的 selfHeal,手動改會被還原。
回到 Prometheus 的 Alerts 頁面,TodoApiDown 會先變成 Pending,1 分鐘後變成 Firing,再過 30 秒左右 Discord 就會收到通知。昨天的 Dashboard 切到 dev,Panel 3 也會顯示 0。
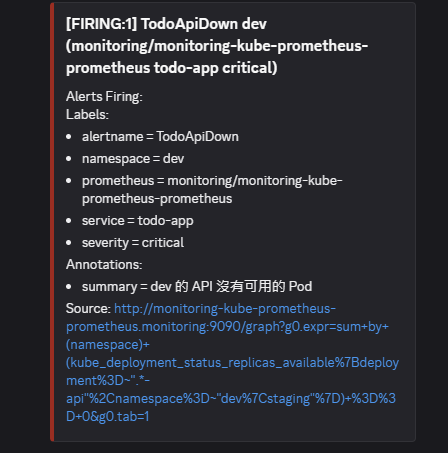
從 scale 到收到通知大約 2 分鐘:kube-state-metrics 更新狀態、Prometheus 每 30 秒評估一次規則、
for: 1m、Alertmanager 的group_wait: 30s,每一段都要時間。
把 API 恢復:
kubectl scale deployment todo-dev-api -n dev --replicas=1
過一兩分鐘,Discord 會收到 RESOLVED 的通知,代表問題已經排除。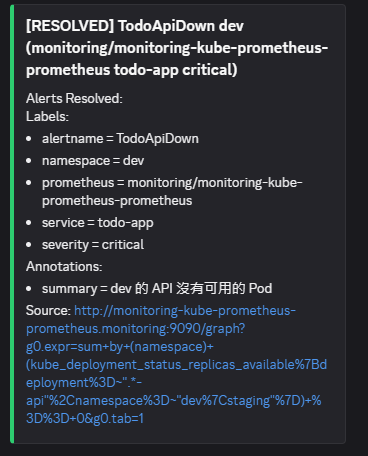
git pull
git add monitoring/todo-app-alerts.yaml .gitignore
git commit -m "Add Todo App alert rules"
git push
告警規則跟 Dashboard JSON 一樣進 Git 管理;Webhook 網址所在的 alertmanager-values.yaml 不 commit。
練習結束後,到 port-forward 的終端機按 Ctrl + C 停掉。
critical 要立刻處理,可以打電話叫人;warning 上班時間再看就好。今天的 severity label 就是為了之後分流。TodoApiDown 就是服務已經出問題,要馬上處理;記憶體和重啟次數則是提早提醒,讓你在使用者受影響之前先處理。for 過濾短暫波動,告警會經過 Inactive → Pending → Firingrelease: monitoring 才會被載入null
helm upgrade 更新設定時要加 --version,避免意外升級 chart告警只是通知哪邊「出了問題」,但要知道「為什麼」,需要去看 log。明天會學 Loki,把所有 Pod 的 log 集中起來,在 Grafana 裡查詢。



 iThome鐵人賽
 看影片追技術