
昨天的告警能在出問題時通知我們,但通知只說了「dev 的 API 沒有可用的 Pod」,要知道原因需要看 log。今天用 Loki 把所有 Pod 的 log 集中起來,在 Grafana 裡查詢。
kubectl logs 在開發時很好用,但真的出問題時會遇到幾個限制:
--previous 也只能看到上一次重啟前的。昨天的告警可能在半夜觸發,等你早上起來看,出事的 Pod 可能早就被重建了。所以 log 要在 Pod 消失之前就先收集起來。
各個 Pod 的 log
      │
      │  Alloy 收集(透過 K8s API 讀取 log)
      ▼
Loki(儲存 log)
      │
      │  Grafana 用 LogQL 查詢
      ▼
Grafana Explore
namespace、pod、container 等 label,再送到 Loki。以前常見的組合是 Loki + Promtail,但 Promtail 已經停止維護,官方改推 Alloy 來收集 log。
今天目標:安裝 Loki 和 Alloy,在 Grafana 加上 Loki 資料來源,查詢 Todo App 的 log,並模擬一次故障,用 log 找出原因。
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
monitoring/ 建立 loki-values.yaml,改成適合練習的單機模式:deploymentMode: SingleBinary
loki:
auth_enabled: false
commonConfig:
replication_factor: 1
storage:
type: filesystem
schemaConfig:
configs:
- from: "2024-04-01"
store: tsdb
object_store: filesystem
schema: v13
index:
prefix: loki_index_
period: 24h
singleBinary:
replicas: 1
# 關掉其他部署模式的元件
backend:
replicas: 0
read:
replicas: 0
write:
replicas: 0
# 關掉練習用不到、又很吃記憶體的元件
chunksCache:
enabled: false
resultsCache:
enabled: false
lokiCanary:
enabled: false
test:
enabled: false
deploymentMode: SingleBinary:所有功能跑在一個 Pod 裡,適合本機練習。auth_enabled: false:關掉多租戶,不然每次查詢都要帶租戶 ID。storage.type: filesystem:log 存在 Pod 掛載的磁碟裡。正式環境通常會存到 S3 這類物件儲存。chunksCache:預設會跟叢集要好幾 GB 的記憶體,minikube 撐不住,一定要關掉。monitoring,跟 Prometheus、Grafana 放在一起:helm install loki grafana/loki -n monitoring -f loki-values.yaml
kubectl get pods -n monitoring -l app.kubernetes.io/name=loki -w
等 loki-0 和 loki-gateway-... 都 Running 後按 Ctrl + C。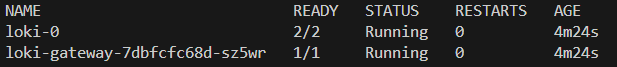
Pod 卡在
Pending的話,用kubectl describe pod看 Events。Insufficient memory代表記憶體不夠,可以先把 dev 縮到 0 個副本騰出空間。
monitoring/ 建立 alloy-values.yaml:controller:
type: deployment
replicas: 1
alloy:
configMap:
content: |
// 1. 找出 dev 和 staging 的所有 Pod
discovery.kubernetes "pods" {
role = "pod"
namespaces {
names = ["dev", "staging"]
}
}
// 2. 把 K8s 的資訊轉成 log 的 label
discovery.relabel "pods" {
targets = discovery.kubernetes.pods.targets
rule {
source_labels = ["__meta_kubernetes_namespace"]
target_label = "namespace"
}
rule {
source_labels = ["__meta_kubernetes_pod_name"]
target_label = "pod"
}
rule {
source_labels = ["__meta_kubernetes_pod_container_name"]
target_label = "container"
}
}
// 3. 透過 K8s API 讀取這些 Pod 的 log
loki.source.kubernetes "pods" {
targets = discovery.relabel.pods.output
forward_to = [loki.write.default.receiver]
}
// 4. 送到 Loki
loki.write "default" {
endpoint {
url = "http://loki-gateway.monitoring.svc.cluster.local/loki/api/v1/push"
}
}
設定由四個區塊串成一條流水線,每個區塊的輸出接到下一個區塊:找出 Pod → 貼上 label → 讀取 log → 送到 Loki。
namespaces:只收集 dev 和 staging,減少 minikube 的負擔。controller.type: deployment:Alloy 的 Chart 預設是 DaemonSet,每個 Node 跑一個。但 loki.source.kubernetes 是透過 K8s API 讀取整個叢集的 log,跑多個會重複收集,所以改成只跑 1 個的 Deployment。helm install alloy grafana/alloy -n monitoring -f alloy-values.yaml
kubectl get pods -n monitoring -l app.kubernetes.io/name=alloy
Running 之後,看 log 確認沒有錯誤:kubectl logs -n monitoring deploy/alloy --tail=20
資料來源可以在 Grafana UI 手動新增,但跟 Day 28 的 Dashboard 一樣,Grafana 重啟後就會消失。所以改用 kube-prometheus-stack 的 values 設定。
monitoring/ 建立 grafana-loki-values.yaml:grafana:
additionalDataSources:
- name: Loki
type: loki
url: http://loki-gateway.monitoring.svc.cluster.local
access: proxy
跟昨天一樣,先用 helm list -n monitoring 查出 chart 版本,再升級:
helm upgrade monitoring prometheus-community/kube-prometheus-stack -n monitoring --version 91.8.2 --reuse-values -f grafana-loki-values.yaml
--reuse-values會保留昨天設定的 Alertmanager,不用再傳一次alertmanager-values.yaml。
升級後 Grafana 的 Pod 可能會重建,原本的 port-forward 會斷線,重新執行一次:
kubectl port-forward svc/monitoring-grafana -n monitoring 3001:80
打開 Grafana,Connections → Data sources 會多一個 Loki。點進去拉到最下面按 Test,顯示成功就完成了。
左側選單 Explore,上方的資料來源選 Loki,切到 Code 模式。
1. 用 label 選出要看的 log
{namespace="staging", container="api"}
大括號的寫法跟 PromQL 一樣,這會列出 staging 所有 API Pod 的 log,不用再一個一個 Pod 查。每筆 log 點開可以看到它的 label,知道是哪個 Pod 印出來的。
2. 用關鍵字過濾內容
{namespace="staging", container="api"} |= "GET"
|= 是「包含這個字串」,常用的還有這幾個:
| 寫法 | 意思 |
|---|---|
|= "error" |
包含 error |
!= "health" |
不包含 health,常用來濾掉健康檢查的 log |
|~ "(?i)error|exception" |
符合正規表示式,(?i) 代表不分大小寫 |
大括號裡的 label 篩選會用到索引,速度很快;
|=是把選出來的 log 逐行掃過。所以要先用 label 把範圍縮小,再用關鍵字過濾。
3. 把 log 算成數字
sum by (pod) (count_over_time({namespace="staging", container="api"} [5m]))
count_over_time 計算 5 分鐘內有幾筆 log,結果變成時間序列,可以像 Prometheus 的指標一樣畫成圖。換成 |~ "(?i)error" 過濾後再計算,就是每個 Pod 的錯誤數量。
把 dev 的 MySQL 停掉,模擬資料庫掛掉:
kubectl scale statefulset todo-dev-mysql -n dev --replicas=0
打開 dev 的 Todo App,新增或重新整理幾次,讓 API 去連資料庫。接著到 Explore 查詢:
{namespace="dev", container="api"} |~ "(?i)error|exception"
會看到 API 連不上 MySQL 的錯誤訊息,log 會明確寫出是哪個連線失敗。dev 的 log level 是 debug,訊息會比 staging 詳細。
查不到結果的話,先拿掉
|~那段,看 API 實際印出什麼,再依照 log 的內容調整關鍵字。
這就是實務上排查問題的流程:
收到告警(Day 29)→ 看 Dashboard 找出哪裡異常(Day 28)→ 查 log 找出原因(今天)
確認完把 MySQL 恢復:
kubectl scale statefulset todo-dev-mysql -n dev --replicas=1
今天的三個 values 檔都沒有密碼,可以直接 commit:
git pull
git add monitoring/loki-values.yaml monitoring/alloy-values.yaml monitoring/grafana-loki-values.yaml
git commit -m "Add Loki and Alloy for log collection"
git push
練習結束後,到 port-forward 的終端機按 Ctrl + C 停掉。
Loki 是靠 label 建索引,每一組不同的 label 組合會存成一條獨立的資料流(stream)。如果把使用者 ID、請求 ID 這類值很多的欄位設成 label,資料流數量會暴增,Loki 反而變慢、變吃資源。
所以 label 只放 namespace、pod、container 這類值的種類有限、而且常用來縮小範圍的欄位。使用者 ID 這種細節留在 log 內容裡,需要時再用 |= 搜尋。
業界常說的可觀測性(Observability),通常包含三種資料:
Todo App 的架構還不複雜,Metrics 和 Logs 已經足夠排查大部分問題。等服務拆成更多元件,請求要經過好幾個服務時,Traces 的價值才會真正顯現。
kubectl logs 只能看單一 Pod,Pod 消失 log 就沒了,要靠集中式的 log 系統{label} 選範圍、|= 過濾內容,count_over_time 能把 log 算成數字這 30 天從一個 Todo App 開始,部署到 K8s、用 Helm 管理多環境、CI 自動 build、ArgoCD 自動部署,最後用 Prometheus、Grafana、Alertmanager 和 Loki 建立監控。從寫完程式到上線、再到上線後知道它跑得好不好,整條流程都串起來了。
當初開始寫這個系列,是希望透過每天先學一點基礎知識,再搭配實際操作,加深對 K8s 核心概念和周邊工具的印象。為了讓大家每天讀文章不要太有負擔,每篇都盡量寫得精簡,這樣的取捨讓內容沒辦法講得很深入,但我相信這 30 天下來,還是有打下一些基礎!
非常感謝一路看到今天的你!K8s 還有很多主題值得深入學習,系列結束後,也期待大家都能繼續往下探索。之後如果遇到覺得不錯、值得分享的內容,我會再繼續寫下去~



 iThome鐵人賽
 看影片追技術