
📡 GitHub 不保證剛好一次,要自己做到。回「收到了」只代表 GitHub 不會再送,所以通知要先存進資料庫再回覆,才不會漏;GitHub 送失敗的不會自動補,要定期自己要求補送;補送回來的、重複的通知,開調查前先用編號認出收過的,才不會做兩次。
昨天在 Day 24|Prompt Injection 擋不完,怎麼辦?,我們讓被外部文字帶偏的 Agent 拿不到私有資料,或寫出去前先停下來讓人看。今天看 Agent 被叫起來的那一刻:改由 GitHub 的通知叫它,每件工作有沒有剛好開始一次?
快速回顧一下:Day 18 的 Agent 退款 timeout 後重送,帶同一把 idempotency key,Stripe 就認得出是同一筆。今天反過來,GitHub 送、我們收,要認出重複的是我們自己。
假設團隊做了一個幫忙查問題的 Agent。有人在 GitHub 開 Issue 回報問題,它就去讀 Issue、翻相關的 log,最後把結果留言在那張 Issue 底下。查一次要跑好幾分鐘、花一份模型的 token。
要讓 GitHub 上有人開 Issue 時叫起自己的 Agent,常見的接法是 webhook:在 repo 設定裡登記一個我們伺服器的網址,有人開 Issue,GitHub 就送一個 HTTP 請求到那個網址。團隊用 FastAPI 寫了接收服務收通知。GitHub 只等 10 秒,等 Agent 查完再回一定來不及,所以收到先回「收到了」,再用 FastAPI 內建的 BackgroundTasks,在同一支程式裡叫 Agent 去查。
第一次出事是在部署的時候。部署要把舊程式關掉,Agent 一查就好幾分鐘,還沒查完程式就被關了,正在查的和排在後面的都跟著不見。GitHub 收到的是成功,不會再送,這幾張 Issue 就一直沒人查;等有人發現已經過了三天,連 GitHub 讓你手動補送的期限都過了。
團隊照 GitHub 文件改了兩件事:通知先寫進資料庫,寫好才回「收到了」,再由 worker(在背景專門處理待辦的程式)拿出來查;另外寫一支排程,每小時查一次 GitHub 記成送失敗的通知,要求 GitHub 補送。
第二次出事,反而是補送造成的。有天資料庫很忙,Issue 731 的通知寫進去花了 12 秒。資料其實存好了,worker 也開始查了,可是超過 10 秒,GitHub 把這則記成送失敗。一小時後排程要求補送。補送的通知連 GitHub 給的編號都跟第一次相同,資料庫卻沒拿這個編號擋重複,又存了一筆,worker 又查了一次。同一張 Issue 留下兩則差不多的留言,花了兩份 token。
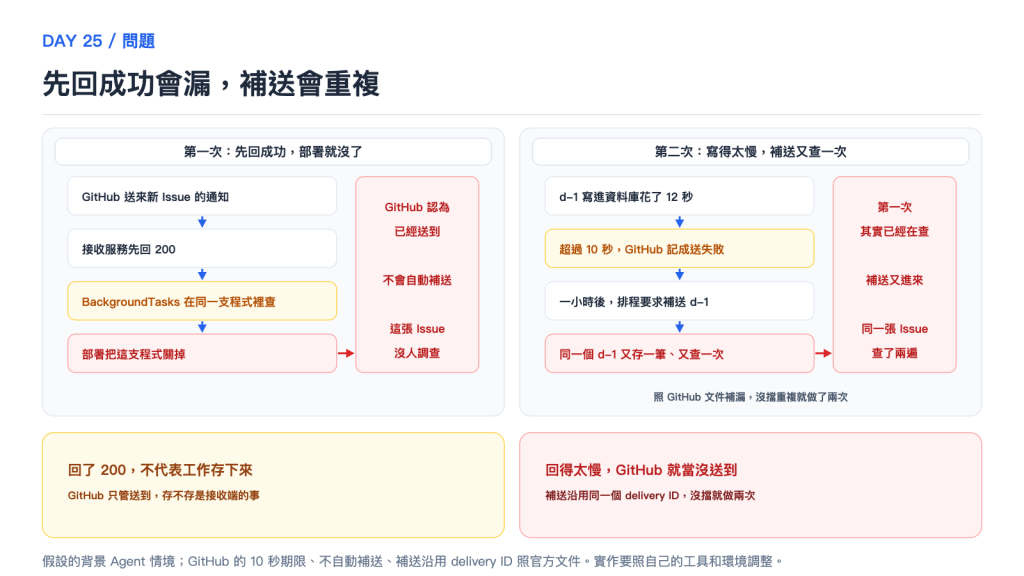
圖:左邊是第一次,先回 200、調查在同一支程式裡跑,部署把程式關掉就沒了;右邊是第二次,寫入花了 12 秒,GitHub 記成送失敗,排程補送同一則,又查了一次。這是示意,實作要照自己的工具和環境調整。
兩次出事,模型都沒做錯,錯在 Agent 被叫起來之前:一次是收到了沒存下來,一次是同一則通知被處理了兩次,而且是照文件補漏才帶出來的。下面先拆開一則通知從送出到叫起 Agent 經過哪幾步、GitHub 保證了什麼、用 Claude Code 的話誰在管,再講三個做法:先存再回、認出收過的、定期對帳。
Day 1 的 Agent loop 是有人送出一則訊息才開始跑。開頭這個 Agent 沒有人跟它聊天,要等 GitHub 上發生事情才開始,所以 Harness 得有辦法知道「GitHub 那邊有人開了 Issue」。
辦法有兩種。一種是輪詢(polling):每隔幾分鐘自己呼叫 GitHub 的 API,問有沒有新的 Issue。另一種是 webhook,GitHub 的文件這樣介紹:你訂閱某些事件,事件一發生,GitHub 就把資料送到你的伺服器,實際上是一個打到你事先登記網址的 HTTP POST。文件也拿兩者比過:webhook 不用一直呼叫 API,事件一發生就送來,接近即時;要盯的東西很多時,輪詢很快就會用完 API 的呼叫額度。
不只 GitHub,Stripe 有人付款、Shopify 有新訂單,也都用 webhook 通知你。要把一個現成的網站接進自己的 Harness,讓那邊發生的事叫起 Agent,最常見的就是這個接法:在那個網站登記一個網址,自己在網址後面寫一支程式收。一則通知從送出到叫起 Agent,會經過這幾步:
GitHub:有人開了 Issue 731
  │ 1. 送一個 HTTP POST 到我們登記的網址
  │    內容是哪個 repo、哪張 Issue、誰開的;header 帶這次送出的編號
  ▼
接收服務(跑在我們的伺服器上)
  │ 2. 驗證簽章,確認真的是 GitHub 送的
  │ 3. 把要查的事記成一筆待辦
  │ 4. 10 秒內回 GitHub「收到了」(HTTP 2XX)
  ▼
worker(在背景處理待辦的程式)
  │ 5. 拿出待辦,叫起 Agent
  ▼
Agent loop:讀 Issue、翻 log、在 Issue 底下留言
第 1 步是 GitHub 做的。登記網址時選好要聽哪些事件,例如 Issue 被開啟、被加標籤;事件一發生,GitHub 就送一則通知。每次送出都帶一個編號,放在 X-GitHub-Delivery header 裡,叫 delivery ID,後面認重複會用到它。
第 2 到 4 步是接收服務,這是我們自己寫的程式。網址是公開的,誰都打得到,所以先用登記時設定的 webhook secret 驗證簽章,確認通知真的來自 GitHub。GitHub 送出後只等 10 秒,Agent 查一次要好幾分鐘,接收服務不能等查完才回,只能先把待辦記下來就回「收到了」。
第 5 步交給 worker,它一筆一筆拿出待辦,叫起 Day 1 那個 Agent loop。從這裡開始,就是前面二十幾天在講的事。
接 webhook,等於 Harness 多了一個入口:以前是有人在畫面上送訊息,現在是 GitHub 送通知。第 1 到 5 步 Agent 都還沒開始跑,模型不知道這幾步發生什麼,通常也沒人看著。開頭兩次出事都在這幾步:第一次是第 3 步的待辦只放在接收服務那支程式裡,程式一關就沒了;第二次是第 3 步寫資料庫寫了 12 秒,拖到第 4 步超過 10 秒。
輪詢的時候,什麼時候查、查到哪裡都在自己手上,這次漏了下一輪再查就好。改成 webhook,什麼時候送、送失敗怎麼辦,就照 GitHub 的規則。GitHub 的規則在兩份文件裡:最佳實務要求接收端在十秒內回 2XX,沒做到這次就記成送失敗;處理送失敗通知的文件寫得很直接,GitHub 不會自動重送失敗的通知。要補,得自己在畫面上或用 API 要求重送,而且只能補最近三天的。
「送到沒」這件事,訊息系統有現成的分法。Kafka 是常用的訊息系統,它的設計文件分成三種:
同一段也提醒,很多系統號稱剛好一次,可是送的一方或收的一方會當掉、收的程式又有好幾個的時候,常常就做不到。
拿這三種去對 webhook。GitHub 自己不重送,比較接近 at most once,可能漏;你用 API 補送之後,同一則又可能收到第二次。Stripe 走另一邊,它的 webhook 文件寫正式環境會自動重送最多三天、間隔越拉越長,也寫明同一個事件偶爾會收到不只一次,接近 at least once。兩家並排:
GitHub
  要多快回      → 10 秒內回 2XX
  沒回成功      → 記成失敗,不會自動重送;3 天內可以手動或用 API 補送
  會不會重複    → 會,補送的那幾則
  怎麼認出重複  → 每次送都帶一個編號(X-GitHub-Delivery header),補送時沿用原本的

Stripe
  要多快回      → 在任何可能 timeout 的邏輯之前先回 2xx,文件沒寫幾秒
  沒回成功      → 正式環境自動重送,最多三天
  會不會重複    → 會,文件寫偶爾會收到同一個事件不只一次
  怎麼認出重複  → 事件 ID,記下處理過的,不再處理
兩家都沒有承諾剛好一次,要做到得靠我們自己:收到的通知先存下來,就不會漏;再用編號認出收過的,就不會重複。兩半合起來,效果上就是剛好一次。後一半在微服務的設計模式裡叫 idempotent consumer:收訊息的程式把處理過的訊息 ID 記在資料庫裡,同一個 ID 再來就丟掉。
Claude Code 有兩種方式被 GitHub 事件叫起來,收 webhook 這一段都不用自己寫。
GitHub Actions 裡的 claude-code-action。 Claude Code 的文件寫,workflow 沒給 prompt 時,它等的是 Issue、PR 留言或新 Issue 內文裡的 @claude;給了 prompt,任何 GitHub 事件都能叫它起來。收 webhook 的是 GitHub 自己,每個符合條件的事件啟動一次 workflow。同一張 Issue 會帶出好幾則通知,GitHub Actions 的文件剛好舉過:帶兩個標籤開 Issue,會啟動三次 workflow,一次給開 Issue,兩次給加標籤。
Claude Code 的文件在控制花費那段,建議用 GitHub 的 concurrency 設定限制同時跑的數量。concurrency 的文件寫,它把 workflow 分組,同一組同時只會跑一個;已經有一個在跑,新來的就排隊;預設只留一個排隊的,再來一個就把它取代,設成 queue: max 最多能排 100 個,順序也不保證。用 Issue 編號分組,Issue 731 就不會同時跑兩個 Claude;可是開 Issue 那次跑完,排在後面的加標籤那次還是會再跑一遍,兩次不會併成一次。
Routines 的 GitHub 觸發。 Routines 是存在雲端的 Claude Code 設定,照排程、API 呼叫或 GitHub 事件自動跑,目前是 research preview,GitHub 這邊只支援 PR 和 Release 兩類事件。文件寫每個事件都開一個新的 session,同一個 PR 更新兩次,就是兩個各自獨立的 session;GitHub 事件超過每小時上限的部分會被丟掉,等時間窗重置才再收。
其他產品也讓事件叫起背景 Agent:Cursor Automations 可以接排程、Slack、Linear、GitHub、PagerDuty 和自訂 webhook;LangChain 講的 ambient agents,是聽著事件串流、照事件行動的 Agent。兩篇文章都沒提送達保證和去重。
用現成產品的話,收通知、存下來這段平台會做,但每則通知都會叫起一次新的 Claude,同一張 Issue 會不會查兩次,還是要自己顧。自己接通知的話,兩件事都要自己做,下面三節講的就是這種情況。
開頭那個接收服務先回應、再把工作交給背景處理,本身沒有錯,GitHub 和 Stripe 的文件都要你這樣做:先回應,耗時的工作排進 queue 再處理。問題在背景工作放在哪裡。FastAPI 的文件說 BackgroundTasks 在回應之後執行,適合寄通知信這種小工作;重的、要分到好幾支程式或好幾台機器跑的,建議改用 Celery 這類工具,背後要有 RabbitMQ 或 Redis 這種另外存著的 queue。開頭的調查一跑好幾分鐘,卻跟接收服務綁在同一支程式裡。用 Kubernetes 部署的話,它關掉舊程式時預設只給 30 秒收尾,時間到還在跑的就強制結束。
再加上「回應」和「存下來」的先後。回了 2XX,GitHub 就當作送到了,不會再送;待辦如果只在程式裡,程式一結束,就沒有任何地方記得這筆。改法就是開頭團隊後來做的:在資料庫開一張收件表,每收到一則通知就記一筆,寫進去了才回 GitHub;worker 從收件表一筆一筆拿出來處理。開頭第一次漏掉,改前和改後的順序並排是這樣:
改前:收到通知 → 回 200 → BackgroundTasks 在同一支程式裡叫 Agent 查
      部署關掉這支程式 → 正在查的、排在後面的都不見了,GitHub 認為已送達,不會補送

改後:收到通知 → 驗證簽章 → 寫進收件表(同一個編號只存一筆)→ 寫進去了才回 2XX
      → worker 從收件表拿出來 → 開調查
      部署發生在任何兩步之間 → 已經存進收件表的,重開後的 worker 接著處理;
                              還沒回 2XX 的,GitHub 記成送失敗,後面的對帳會補
改後唯一要守住的先後是「存好了才回成功」;回應和 worker 開始處理誰先誰後都沒關係。存好才回也有代價:寫入慢到超過 10 秒,資料明明存好了,GitHub 一樣記成送失敗,之後補送回來就是第二次。開頭第二次出事就是這樣,下一節講怎麼認出來。
收件表就是前面 idempotent consumer 說的那張表。那份模式說明的例子用訊息 ID 當主鍵,同一個 ID 第二次寫入會失敗,接收服務就知道這則收過了。
收件表和 queue 如果是兩套系統,可以照 transactional outbox 的做法接起來:在同一筆資料庫 transaction 裡寫進收件紀錄和一筆「待送進 queue」的紀錄,提交之後再由另一支程式送進 queue。用既有的資料庫和 queue 就好,不必在 Harness 裡重做一套訊息系統。不要只因為函式叫 enqueue(),就假設資料已經存好,要查那個服務什麼時候才算寫入成功。
開頭第二次進來的是同一則通知。前面說過 GitHub 每次送出都帶一個 delivery ID,補送時會沿用原本的值。所以收件表拿來源和 delivery ID 當唯一鍵:補送回來的那則寫不進第二筆,接收服務就知道收過了,照樣回成功,不再交給 worker。
這就是 Day 18 講的冪等:同一件事做兩次,效果跟做一次一樣。Day 18 是 Agent 往外送、由 Stripe 認出重送;這裡是通知往內送,由我們的收件表認出重送。
還有一種重複,delivery ID 認不出來:兩則不同的通知,要做的是同一件事。前面 GitHub Actions 文件舉的例子就是這種,帶標籤開 Issue,GitHub 會送一則「開了 Issue」、再送一則「加了標籤」。假如團隊也想讓後來才補上 security 標籤的 Issue 被查,接收服務對兩種通知都會開調查;有人開 Issue 時順手貼上標籤,兩則幾乎同時到,delivery ID 不同,收件表各存一筆,兩個 worker 各拿一則,就會撞在「開調查」這一步。
這時要認的是「要做哪件事」,用 business key:由「哪個客戶、哪個 repo、哪張 Issue、做什麼」組成,例如 tenant_7/repo_a/issue_731/investigate。資料庫設計裡把這種從資料內容本身組出來的 key 叫 business key。要擋住第二筆,靠的是資料庫的 unique constraint:設定某幾個欄位的組合不能出現兩筆,第二筆寫入會直接失敗。改前和改後並排:
改前:先查「issue_731 有沒有進行中的調查?」→ 沒有 → 開一筆
      worker A 和 B 同時查,都看到沒有 → 開了 run_88 和 run_89

改後:資料庫設 unique constraint:同一個 business key 只能有一筆進行中的調查;worker 不先查,直接開
      worker A 開 run_88 成功
      worker B 寫入失敗 → 把「加標籤」這則當新資料附到 run_88,請它醒來看
先查再開,兩個 worker 同時查,都會看到「還沒有」;交給資料庫擋,誰先誰後都只會開出一筆。
business key 跟 Day 18 從「做哪一件事」算出 Operation ID 是同一個想法:從工作內容組出來,不管哪一則通知、哪個 worker 來算,都是同一個。key 怎麼組,決定擋的範圍:只用 issue_731,不同客戶的 repo 都可能有 Issue 731,會擋錯;只用 repo,同一個 repo 的所有 Issue 會擠成一筆調查。unique constraint 也只擋「同時有兩筆進行中的調查」。
調查做完之後才到的通知要另外處理。例如 run_88 已經查完,GitHub 晚送的一則通知才進來,這時沒有進行中的調查,unique constraint 擋不到,直接開就會把同一張 Issue 再查一遍。所以 worker 先看這件工作有沒有查完的調查:有就把通知記在那筆調查底下、標成忽略;只有明確要求重查,例如有人留言請 Agent 再查一次,才開新的一筆。
這一層只管「同一件工作只開一次」。調查途中寄信、開 PR 這類外部操作 timeout 之後 retry,靠的是 Day 18 的 Operation ID;worker 當掉、別的 worker 接手時怎麼擋住舊的那一個,是 Day 6 的執行權版本。
先存再回,擋得住「回了成功卻沒存」,擋不住「根本沒送到」:接收服務剛好停機,或回應超過十秒,GitHub 都記成送失敗,而且不會自己重送。GitHub 文件給的做法就是開頭那支排程:定期查出送失敗的通知,再要求補送。送失敗的清單裡,有些其實已經處理過,只是回得太慢,像開頭那則花了 12 秒的;補送沿用原本的 delivery ID,收件表會擋掉這幾則。只能補三天內的,這支排程至少要比三天跑得勤。
送的那一方自己也會出狀況。GitHub 2024 年 7 月的可用性報告寫,7 月 5 日一次設定變更讓 webhook 的背景工作被拒絕,通知平均晚到 24 分鐘、最久 71 分鐘。如果對帳已經從 GitHub API 查到這張 Issue、自己補了一筆收件紀錄,晚到的通知才進來,兩筆紀錄沒有共同的 delivery ID,要靠 business key 才認得出是同一件工作。
另一道是對帳:排程定期從 GitHub 查「還開著、卻沒有對應工作的 Issue」,用 business key 比對 GitHub 上該有的工作和收件表裡已經有的。Shopify 的 webhook 文件也這樣建議:送達不保證,app 不能只靠 webhook,要定期把資料拉回來對。比對出來的落差,我會照類型分開處理,這套分流是我的建議:
| 對帳看到的落差 | 下一步 |
|---|---|
| GitHub 上有、收件表沒有 | 補建收件紀錄,走正常入口,不直接叫模型 |
| 有收件紀錄、沒有對應的調查 | 先看當時的決定:判定忽略的不開,判定要做的才補派 |
| Issue 已經關閉 | 記下忽略理由;已經在查的,照政策取消 |
| 調查還在跑,很久沒進度 | 交給 Day 6 的執行權版本和 Day 7 的恢復流程接手 |
這張表由排程的對帳程式在查完 GitHub 之後使用,不讓模型猜是哪一種。
第二列要能判斷,收件紀錄就得存下當時的決定和理由;把「刻意忽略」和「沒查到」記成同一種結果,下一輪掃描還會再撞到同一張 Issue。
對帳查的是現在的狀態。一張 Issue 在兩次掃描之間開了又關,只查目前還開著的,就找不回它。要每個事件都不漏,得靠補送失敗的通知,或 GitHub 保存的事件歷史;換成別的來源,如果它的通知沒有固定的編號、也查不了目前狀態,就只能把限制講明,改成提高輪詢頻率或留人工對帳。
前面三節的做法,落到資料庫裡是兩張表。收件表記「收到了哪些通知」,一則通知一筆;調查表記「開了哪些調查」,一次調查一筆。補送回來的同一則通知,由收件表認出來;開 Issue、加標籤這種不同的通知要做同一件事,由調查表擋下第二筆。
收件表至少要有這幾欄,值用開頭 Issue 731 那則通知:
| 欄位 | Issue 731 那則的值 | 為什麼要存 |
|---|---|---|
source、delivery_id |
GitHub、d-1 |
這則通知是誰送的、編號多少。兩個合起來設成不能重複,補送回來的 d-1 寫不進第二筆,接收服務就知道收過了。少了它,補送會被當成新的通知再查一次 |
payload |
開 Issue 那則通知的原文 | worker 要從裡面讀出是哪個客戶、哪張 Issue;事後查問題的人也要看當時收到什麼 |
business_key |
tenant_7/repo_a/issue_731/investigate |
worker 從原文組出來,代表「要做哪件事」;開 Issue 和加標籤兩則通知,算出來是同一個值。少了它,worker 認不出兩則通知要做同一件事 |
status、理由 |
剛存進來是 received;接上調查後改成 attached;決定不處理就是 ignored,附上理由 |
worker 靠 received 找出還沒處理的;對帳時靠它分出「刻意不查」和「漏了沒查」。少了它,刻意忽略的每次對帳都會再撞到 |
run_id |
run_88 |
這則通知接到哪一次調查。之後要查這次調查是被哪幾則通知叫起來的,就靠這欄 |
調查表至少要有這幾欄:
| 欄位 | Issue 731 的值 | 為什麼要存 |
|---|---|---|
run_id |
run_88 |
這次調查的編號,Agent 查的每一步都記在它底下 |
business_key |
tenant_7/repo_a/issue_731/investigate |
跟收件表那欄同一個值。資料庫設 unique constraint:同一個 business key 只能有一筆進行中的調查,兩個 worker 同時開,只有一個開得成 |
status |
查的時候是 active,查完是 finished |
上面那條規則只看進行中的,查完的擋不到,所以 worker 開之前要先看有沒有查完的 |
兩張表各由一支函式寫。receive_webhook 是接收服務收到每一則通知時跑的,只寫收件表;start_or_attach 是 worker 從收件表拿出一筆 received 時跑的,決定開新的調查、交給進行中的那一筆,還是忽略:
def receive_webhook(request, verify, inbox):
    event = verify(request)                          # 簽章不對、不是我們客戶的 repo,就拒絕
    if event is None:
        return 401
    inbox.insert_if_absent(event.source, event.delivery_id, event)  # 同一個來源和 delivery ID 已經有了,就不再寫
    return 200                                       # 存好了才回「收到了」


def start_or_attach(item, runs):
    done = runs.finished(item.business_key)          # 這件事已經查完了嗎?
    if done and not item.asks_rerun:
        item.mark("ignored", reason="已經查完", run_id=done.id)  # 晚到的通知不重開
        return
    try:
        run = runs.create_active(item.business_key)  # 開一筆進行中的調查
    except UniqueViolation:                          # 已經有進行中的,資料庫不讓開第二筆
        run = runs.active(item.business_key)
        run.attach(item)                             # 把這則通知交給它,正在查的 Agent 也看得到
    item.mark("attached", run_id=run.id)
用開頭 Issue 731 的幾則通知走一遍:
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
接收服務呼叫 receive_webhook |
GitHub 送來 Issue 731 被開啟的通知 d-1,資料庫很忙,寫了 12 秒 |
收件表存好 d-1,狀態是 received;回「收到了」時已經超過 10 秒,GitHub 記成送失敗 |
worker 呼叫 start_or_attach |
拿到 d-1 |
沒有查完的、也沒有進行中的,開出 run_88;d-1 改成 attached,記下 run_88 |
接收服務呼叫 receive_webhook |
一小時後排程要求補送,d-1 又進來 |
收件表已經有 d-1,什麼都沒寫,照樣回「收到了」;沒有新的待辦,worker 不會再查一次 |
| 接收服務和 worker 各跑一次 | run_88 還在查,有人補上 security 標籤,GitHub 送來加標籤的通知 d-2(團隊也設定要處理這種通知) |
delivery ID 不同,收件表另存一筆;worker 算出的 business key 跟 d-1 一樣,開調查被資料庫擋下,d-2 交給 run_88 |
worker 呼叫 start_or_attach |
run_88 查完之後,GitHub 晚送的通知 d-3 才進來 |
查到 run_88 已經查完,d-3 也沒要求重查,標成 ignored,不開新的調查 |
| 對帳排程 | 每小時 | 查出 GitHub 記成送失敗的通知要求補送,第三列那次就是這樣來的;再比對 GitHub 上還開著的 Issue 和收件表,漏掉的補建一筆 received,照樣交給 worker |
第三列就是開頭第二次出事少掉的那一步:當時收件表沒拿 delivery ID 擋,補送的 d-1 又存成一筆新的待辦,worker 就又查了一次。
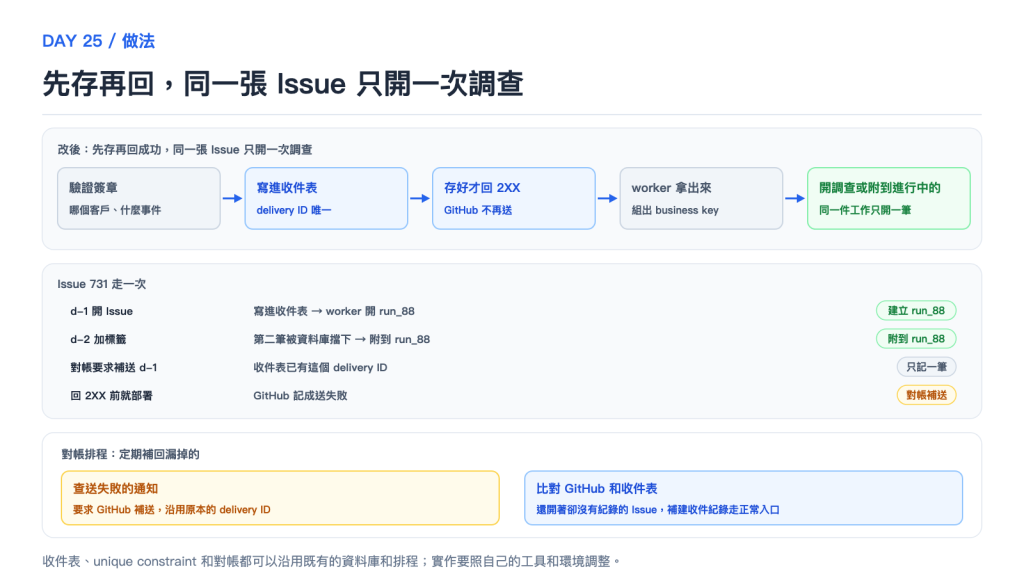
圖:上方是改後的順序,存進收件表才回 2XX,worker 再照 business key 開新的調查,或附到進行中的那一筆;中間是 Issue 731 的幾則通知各自的結果;下方是對帳排程補回漏掉的。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 24:Agent 不會在同一輪讀到外人寫的內容、讀了私有資料,又寫到公開的地方。下一步是讓它被叫起來的這一段不漏、不重複。
第一步,先存再回成功。 接收服務驗證簽章之後,把通知寫進資料庫的收件表,用來源和 delivery ID 當唯一鍵,寫進去了才回 2XX。做到這步,部署和當機不再吃掉已經回過成功的通知。用現成 queue 服務的,先查它的文件,確認回應前資料已經寫入。
第二步,同一張 Issue 只開一次調查。 替 business key 設 unique constraint,讓 worker 直接開,被擋下就附到進行中的那一筆。沒做這步,同一張 Issue 的幾則通知會各叫起一個 Agent,費用和留言都會重複。
第三步,排程對帳。 定期查送失敗的通知要求補送,再比對 GitHub 上還開著的 Issue 和收件表。沒做這步,接收服務停機那段時間的 Issue 就永遠沒人處理。
用 claude-code-action 的話,收和存這段 GitHub 做掉了,第一步可以跳過;用 Issue 編號設 concurrency group,至少不會同時跑兩個 Claude。同一張 Issue 會不會被調查兩次,我會在 workflow 開頭先查這張 Issue 有沒有 Claude 的留言,有就停。
單一來源、流量不大,一張收件表加既有的 queue 就夠開始,不必先建事件平台。要跨好幾個來源、多個 worker 搶同一批工作,或來源經常停機的時候,再把對帳補齊。
Day 26 會控制工作被叫醒之後的總支出,Day 28 會讓入口的決定和後面的每一步都追得回去。
回到 Issue 731,可以試著問自己:webhook 回了 200、收件表有紀錄、run_88 開起來了,各代表走到哪一步?那則花了 12 秒、被記成送失敗的通知補送回來,能不能再開一次調查?
回 200 只代表 GitHub 不會再送,收件表有紀錄才代表通知存下來了,run_88 開起來才代表調查開始;第二題不能:補送沿用同一個 delivery ID,收件表寫不進第二筆,接收服務就知道收過了;就算是加標籤那種不同的通知,同一個 business key 也只能有一筆進行中的調查。
GitHub 不保證剛好一次,要自己做到。回「收到了」只代表 GitHub 不會再送,所以通知要先存進資料庫再回覆,才不會漏;GitHub 送失敗的不會自動補,要定期自己要求補送;補送回來的、重複的通知,開調查前先用編號認出收過的,才不會做兩次。
Agent 能被可靠叫醒之後,明天接著看它開始工作以後的資源:能花多少時間和 token,好幾個 Agent 共用同一份額度時,又由誰決定還能不能繼續。
X-GitHub-Delivery 每次送達唯一而且重送時沿用原值、伺服器恢復後要補送漏掉的。@claude,給了 prompt 就能由任何 GitHub 事件觸發;建議用 GitHub 的 concurrency 限制同時跑的數量。queue: max 最多能排 100 個,順序不保證;它限制同時執行,不會把幾次觸發併成一次。X-Shopify-Webhook-Id 擋重複。

 iThome鐵人賽
 看影片追技術